-
Linux【操作系统】
目录
一、冯诺依曼体系结构
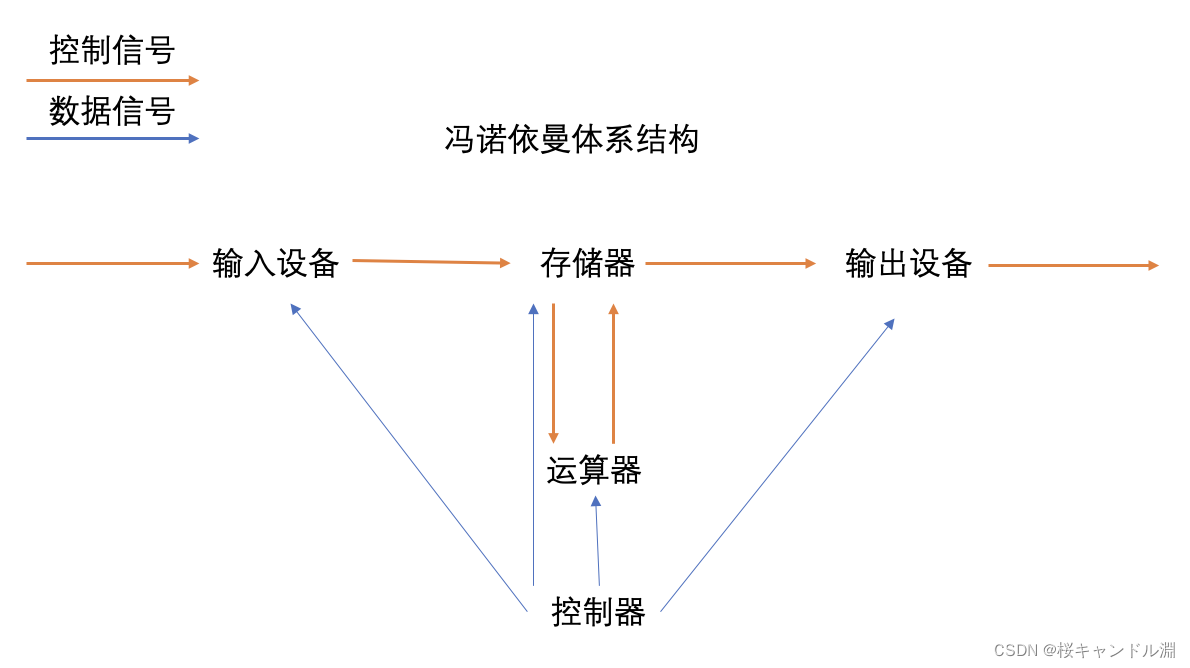
这里的存储器就是内存
输入设备:键盘,摄像头,话筒,磁盘,网卡
输出设备:显示器,音箱,磁盘(你可以把数据写入磁盘也可以把数据从磁盘读取出来,所以磁盘即是输入设备也是输出设备),网卡……
CPU:运算器(算术运算如加减乘除)(逻辑运算如if判断)
控制器:CPU是可以响应外部事件的,协调外部就绪时间,比如拷贝数据到内存
1.为什么我们需要存在一个存储器的结构呢?

为什么不能由 输入设备->CPU->输出设备呢?
输入设备:产生数据的
输出设备:保存或者显示数据
对于数据的读取速度以下列顺序递减,并且是数量级别的差别
1.CPU&&寄存器>内存>磁盘/SSD>光盘>磁带
这里的话,由于木桶原理,我们计算机总的运行速度就会被运行最慢的那一个设备所限制。就好比高u低显,cpu的速度就被GPU的速度限制了。在我们上面的假设中,如果我们没有一个内存来充当一个读取速度介于外设和CPU之间的设备,我们的计算器的整体运行速度就会被外设的速度拖慢。当我们把外设中的数据经过一些软件的合理调用,读取到内存中,我们的CPU就可以直接读取内存中的数据,这样就可以大大提高我们计算机的运行效率。
2.那为什么还要有外存呢?我们不能将我们的存储设备全部变成内存吗?
内存如果断电的话,里面的全部数据就会丢失,而我们的外存在断电之后还是会保存在里面的。并且我们的内存的价格远远大于我们外存的价格,会使我们计算机的造价直线上升。
这里我们需要知道一个概念,凡是被广泛传播的产品,一定是价格便宜,质量OK的。
1.CPU读取(数据+代码),都是要从内存中读取的。站在数据的角度,我们认为CPU不和外设直接交互。
2.CPU需要处理数据,需要先将外设中的数据,加载到内存当中。站在数据的角度,外设直接只和对应的内存打交道。
我们将数据从外设写入内存中称为input,从内存中将数据刷新到外设上称为output。这两个过程合并起来称为io操作。就像是scanf就是input的过程,printf就是output的过程,scanf和printf都是io操作。
程序要运行都必须要被加载到内存中。(程序本身就是一个文件,它存在于磁盘上)
3.那么为什么我们运行一个程序就必须被加载到内存呢?
因为我们的CPU只能在内存中读取代码和数据。我们的程序编译好就仅仅是一个文件。所以我们的程序只有被加载到内存中才能被CPU处理。这是由于我们的冯诺依曼的体系结构决定的
4.假设老冯通过QQ给王大队长发送消息“啊哈哈哈,鸡汤来喽”,那这个过程中,数据是如何流向的呢?
首先老冯和王大队长的手中都有两台冯诺依曼的体系结构的电脑,在这里我们先不考虑网络。老冯需要先通过输入设备(键盘输入)到内存中(虽然老冯好像是在QQ对话框中输入的,但事实上这个QQ软件此时是被加载到内存里的),然后CPU内存中读取了这个要发消息的请求,将我们的数据进行了包装,然后又重新写回内存中,内存又将这些数据刷新到网卡中,通过互联网,这个数据包就被王大队长的网卡收到了,根据冯诺依曼规定,内存就会从网卡中读取收到的数据,内存将这个数据包读取给CPU,CPU将这个数据包解读之后又将解读后的数据写入到内存中,而内存又将我们的内容刷新到王大队长的显示器上。
二、操作系统
计算机最底层的是硬件。
底层硬件之上是驱动程序。驱动程序是操纵具体的硬件的,并且向上提供一个访问硬件的软件接口。
驱动程序之上是操作系统操作系统是一个对我们计算机的软硬件进行统一管理的软件。人不是直接和硬件打交道的,而是通过操作系统。操作系统能给用户提供一个稳定、安全、简单的执行环境。
那么操作系统是怎么实现上述的功能的呢?(软硬件资源管理)
1.理解管理
校长并不会每天都和我们打交道,可能也只是在新生入学和毕业上发表一下演讲。但是辅导员会管理学生,实时提醒你是不是挂科挂得太多了。在这个体系中,被管理者是学生,管理者是校长,管理者和被管理者在原则上可以不直接沟通。
那么校长是如何管理学生的呢?
作为校长,只需要知道这个学生挂了多少们科目,有没有达到挂科的极限,就会要不要对这个学生劝退而做出决策管理,所以说拿到被管理者的数据,来进行管理决策,这才是最重要的。所以说管理者的核心工作就是做决策。管理并不是对于学生进行管理,而是对数据进行管理。
那么校长如何拿到数据,校长又如何下达你被开除了的决策呢?
这个角色就是辅导员,担任的是执行者的决策。
通过我们上面的例子,这里的校长就是我们的操作系统,学生就是我们的硬件,辅导员就是驱动程序。
假设我们现在有五万学生,辅导员将他们的数据全部收集起来,交给校长,但是面对如此庞大的数据,校长没有办法直接高效地处理完。校长就用c++设计了一个学生类,里面设计了姓名,电话,籍贯等等的属性。然后校长就创建了一个学生数组,并且叫辅导员将学生的数据填入其中。假如这时候,校长想要开除总分倒数的前三名角色,校长就可以编写一个按照总分排名的快速排序算法,从而直接找到总分导数的三个角色。校长就可以快速地找到这三名同学并且通知辅导员将他们三个开除,并且从刚刚的学生数组中删除了刚刚那三个学生的信息。
从上面的例子可以看出,管理者首先要对被管理者进行描述,再根据我们对应的描述类型定义对应的对象,可以把对象组织成数组的样子,然后对学生的管理工作就变成了对数组的增删改查工作。
上面的校长依旧是操作系统,学生依旧是硬件。所以操作系统想要管理不同的硬件,就可以先描述不同的硬件,然后将其组织成为一定的数据结构,然后将对于硬件的管理转化对于数据结构的管理。
Linux系统的内核是由c语言写的,也就是通过struct来描述不同的类型的对象,然后将对象进行组织形成数据结构,再进行对数据结构进行增删改查的管理。
所以操作系统内部一定存在着大量的数据结构和算法。
操作系统如何对硬件、软件进行管理?
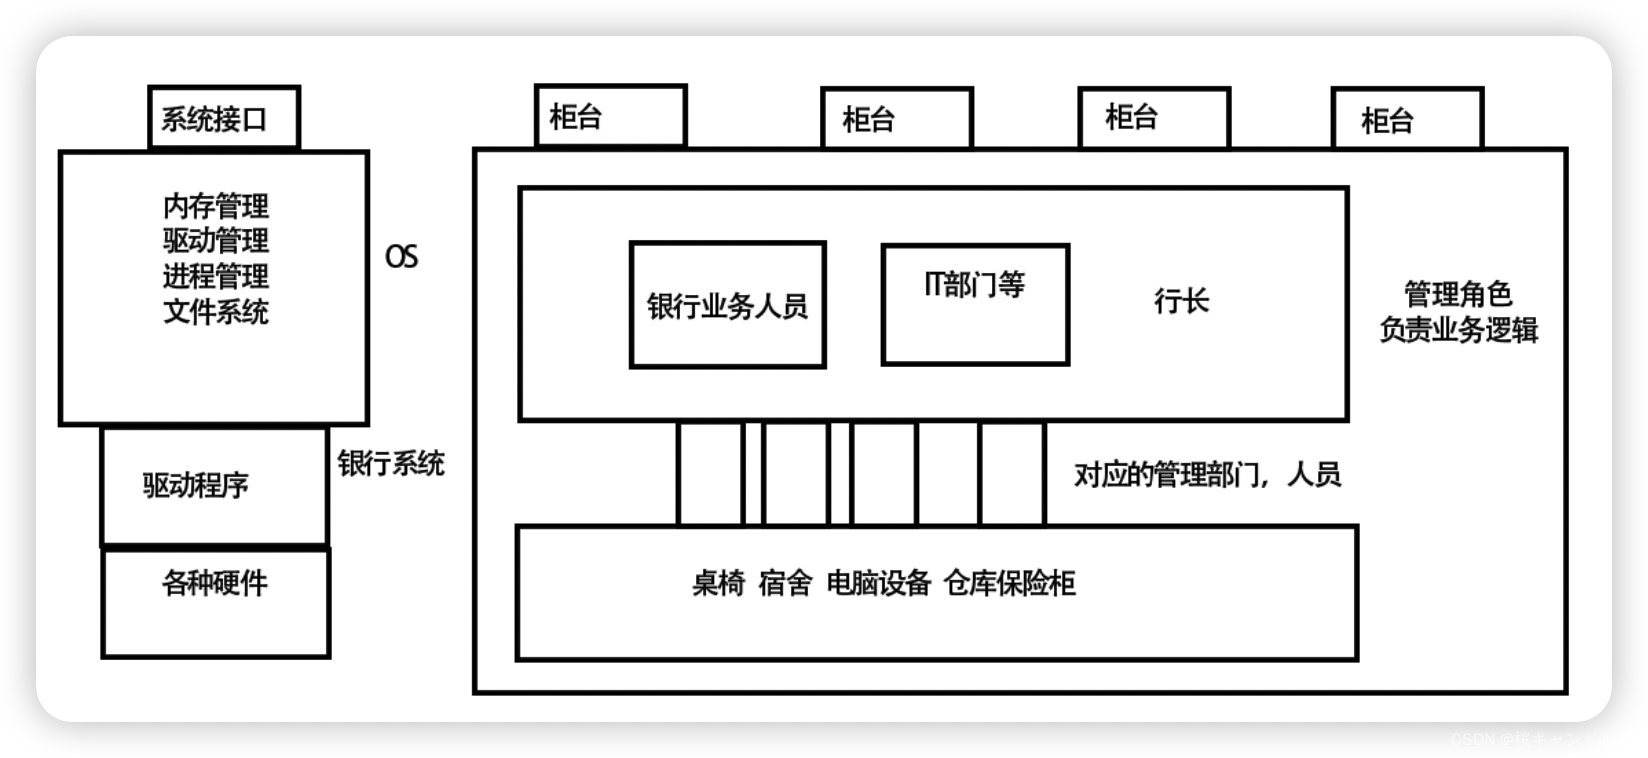
再打个比方,银行有许多桌椅、电脑、宿舍、仓库,然后有对应的仓管,保洁等。在这些底层人员之上,会有银行的工作人员,业务人员。在这些工作人员之上还有银行行长。银行行长会通过业务人员的组长、经理来进行对工作人员进行管理。
银行行长、业务人员、项目经理等的工作称为管理工作。
银行行长可以从保洁阿姨那边了解到底层的银行的硬件设备的情况,也就是操作系统对于硬件的管理。当然也可以从项目经理中了解到每一个工作人员的业绩如何,也就是操作系统对于软件的管理。
银行通过柜台的形式给用户提供服务,其是假设所有人都不值得信任,所以需要将自身的体系封闭起来,保证自身的安全,同时又为了满足和外界的业务处理,所以设立了柜台。
同样的话,操作系统也不能将自身完全暴露给用户,可能会导致操作系统不安全。所以操作系统假设全部的人都不值得信任。但是操作系统又需要给用户提供各种各样的功能,所以需要提供各种各样功能的系统接口。(我们学的Linux是用c语言写的,system call本质就是用C语言提供的函数)
我们和银行工作人员沟通帮助我们存钱,实质上是让银行工作人员调用某些方法将我们的存款单上记上存钱记录,并且将这笔钱存入银行的仓库。
我们调用系统的接口,实质上也是让我们的操作系统去操作一些底层的数据或者功能,来达到我们想要的目的。操作系统为我们的用户提供服务叫做系统调用。
一个好的产品,都是为用户提供傻瓜式操作的,让什么都不懂的用户都能轻易上手。打个比方:银行的具体业务要填一大堆单子,一个小白用户完全不会,但是我们可以通过与银行的引导人员进行沟通,得知如何操作。我们的系统调用也是这样,使用成本比较高,没有接触过操作系统的人基本上没法直接使用。但是现在我们创建了shell外壳和图形化界面,或者是对系统调用接口的封装(第三方库),从而让用户更好地去使用计算机。
三、进程
其实我们自己启动一个软件,本质其实就是启动了一个进程。
在Linux内,运行一条命令, ./xxx,运行的时候,其实就是在系统层面创建了一个进程。
Linux是可以同时加载多个程序的,Linux是可能同时存在大量的进程在系统中的(OS,内存)->Linux系统要不要管理进程呢?必须要管->Linux系统是如何管理大量进程的呢?先描述再组织。
当一个个可执行程序加载到内存当中,我们的Linux系统会为每一个进程都创建一个类(PCB,里面包含了进程的所有属性)
如何理解类呢?(struct)
人认识世界,是通过“属性”来认识的。
->属性是数据吗?是
->属性和进程内的代码和数据有关吗?
文件=内容+属性,文件就是我们的可执行文件,也就是我们编好的代码,我们把它加载到内存里,它就变成了进程,不再是程序了。有pcb结构来描述这个进程的具体属性,(优先级,状态,地址在哪里,等等)不同的PCB我们可以使用链表的方式连接在一起,对进程的管理就变成了对进程PCB结构体的增删改查。
什么叫做进程:进程=对应的代码和数据+进程对应的PCB结构体。
1.PCB
为什么要有PCB,就是为了方便系统管理进程。
假设你在清华大学读书,你需要将你的籍贯、身份证号、电话、家庭信息等录入大学的教务管理系统。学校可以通过这些信息来知道你的具体属性。PCB也是如此。
创建进程就是将代码和数据进而PCB放入内存当中,当一个进程结束的时候,内存中的代码,数据和PCB都要从内存中删除。
PCB(process control block),不同的操作系统中,PCB的名字不同
Linux系统中的为struct task_struct
在Linux中描述进程的结构体叫做task_struct。
task_struct是Linux内核的一种数据结构,它会被装载到RAM(内存)里并且包含着进程的属性信息。2.task_ struct内容分类
标示符: 描述本进程的唯一标示符,用来区别其他进程。
状态: 任务状态,退出代码,退出信号等。
优先级: 相对于其他进程的优先级。(确定谁先谁后)
程序计数器: 程序中即将被执行的下一条指令的地址。(CPU内一个寄存器指针,保存着当前正在执行的指令的下一条的地址)
内存指针: 包括程序代码和进程相关数据的指针,还有和其他进程共享的内存块的指针。
上下文数据: 进程执行时处理器的寄存器中的数据[休学例子,要加图CPU,寄存器]。
I/ O状态信息: 包括显示的I/O请求,分配给进程的I/ O设备和被进程使用的文件列表。(比如说我们买云服务器,上面有一个数据为带宽,这也是一种i/o信息)
记账信息: 可能包括处理器时间总和,使用的时钟数总和,时间限制,记账号等。(比如说这个进程已经累积被处理器处理了多长时间,消耗了多少的资源)
其他信息3.查看进程
使用下面的代码查看所有的进程
ps axj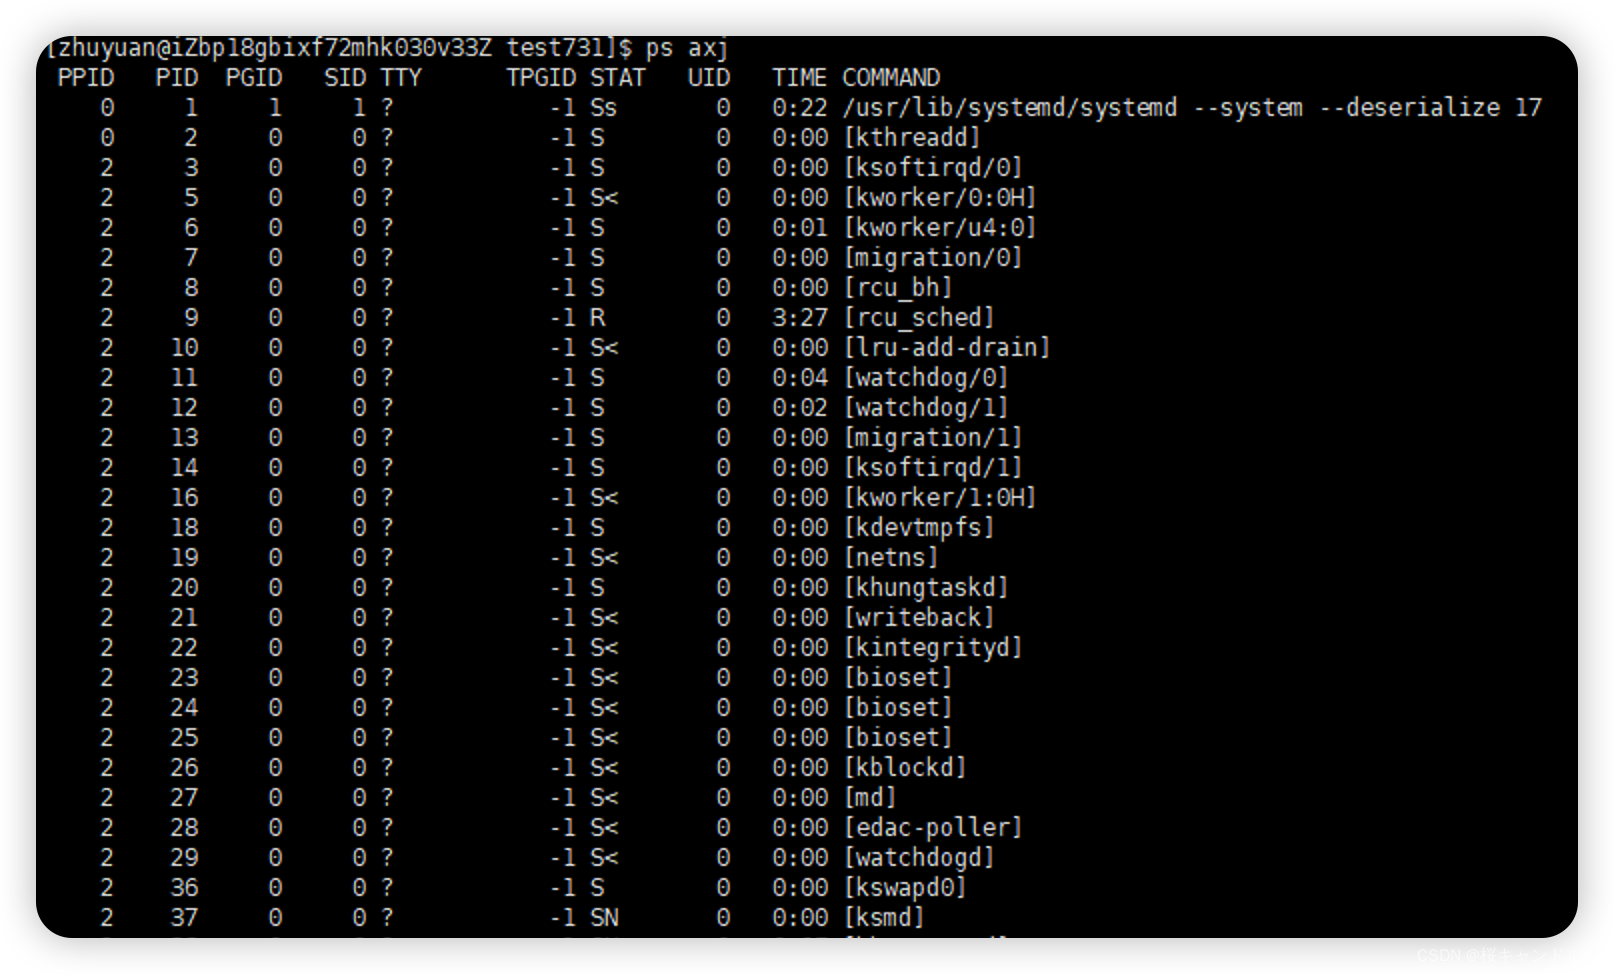
使用top命令可以查看当前的所有进程,按q退出
top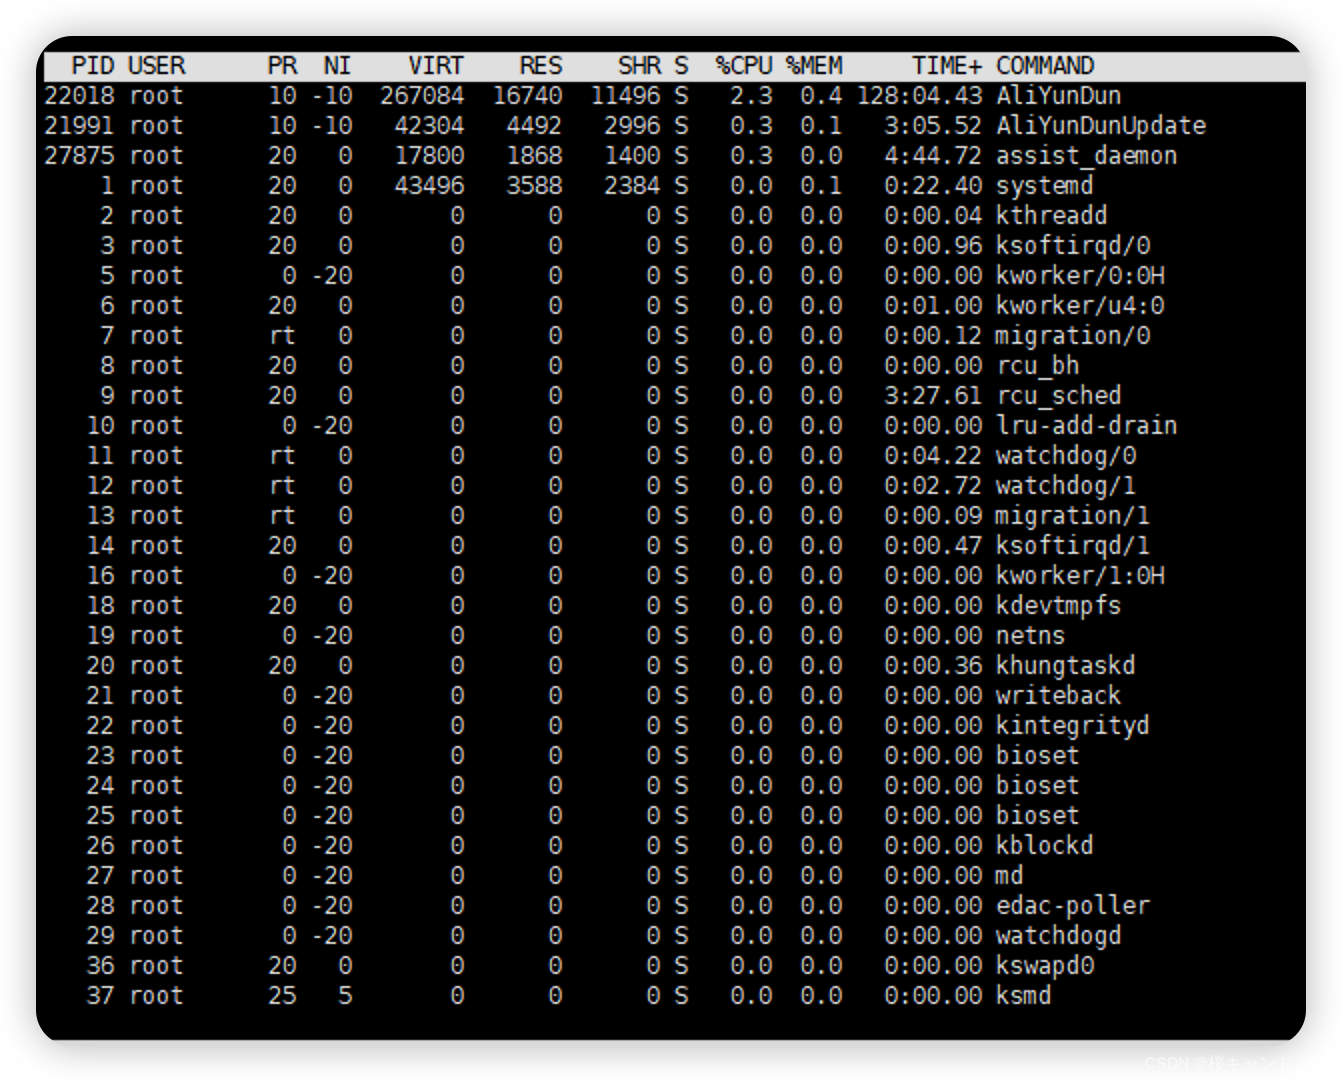
在根目录下有一个proc目录,Linux是可以让你采用文件的形式去查看每一个进程的具体属性。
ls /proc这里我们查看到我们的左边的一大片蓝色的数字就是我们的进程编号
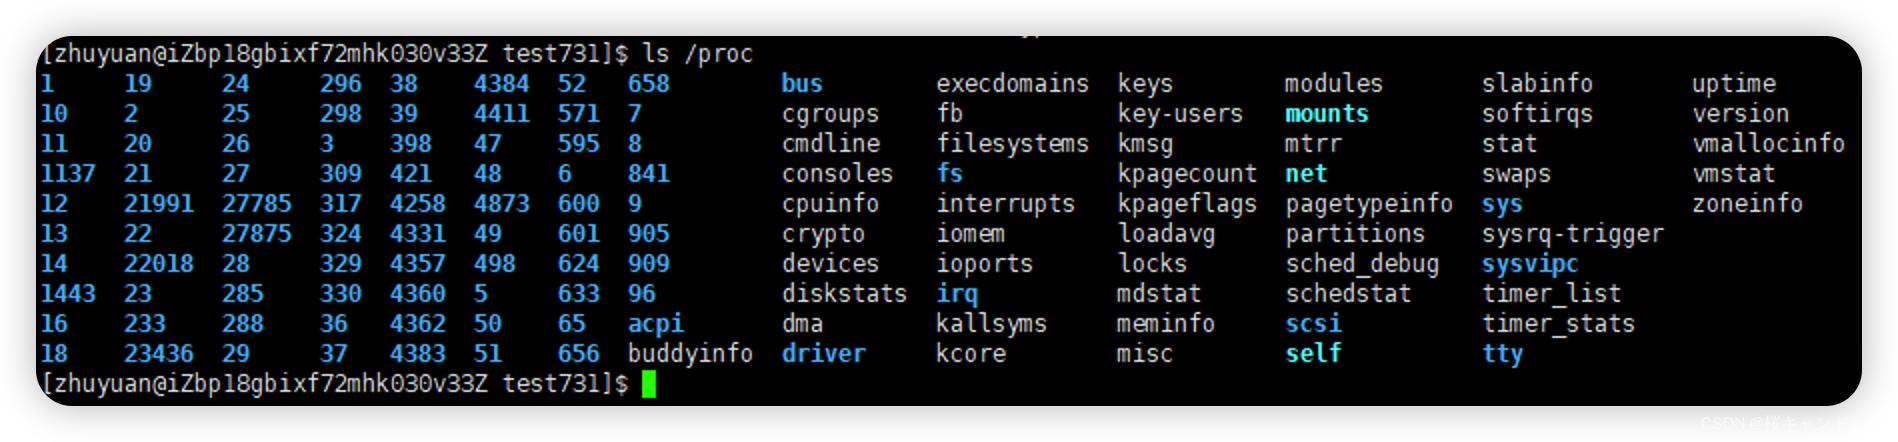
cwd currect work director当前进程的工作目录
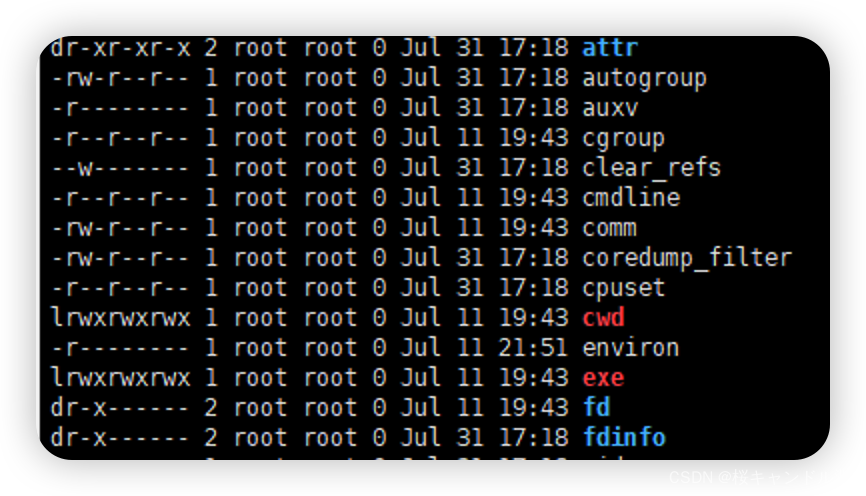
这和我们的文件工作目录很相似
FILE*fp=fopen("log.txt','w');
这里的log.txt是默认打开当前路径
bin(binary二进制)->运行的->每个进程都会有一个属性,来保存自己所在的工作路径。
4.getpid
所有函数只有在变成进程这里是我们的代码 ,getpid()能够获取到当前的进程编号,其编号是一个整型。
这里我们创建的这个程序为一个死循环,因为如果该程序一下子就进行完了,我们就没办法再查看其运行时的进程编号了。(其实我们的操作系统都是死循环,当你执行关机之类的操作时才从死循环中跳脱出来。)
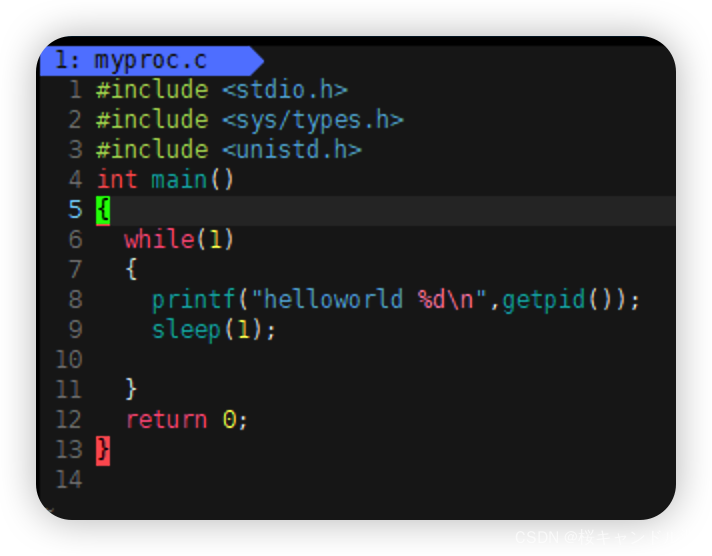
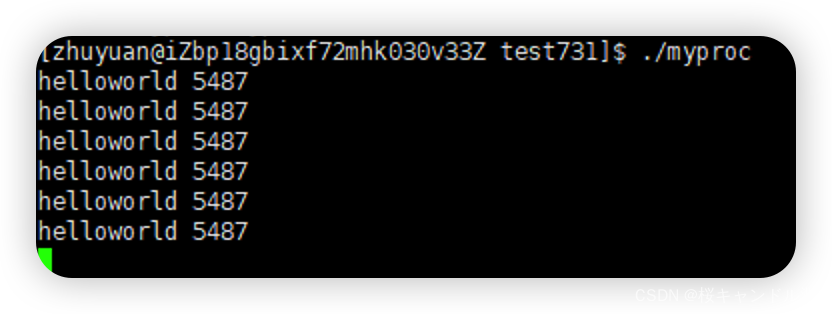
使用ctrl+c或者下面的代码再加上对应的进程编号就能杀死一个进程。
kill -9 +进程编号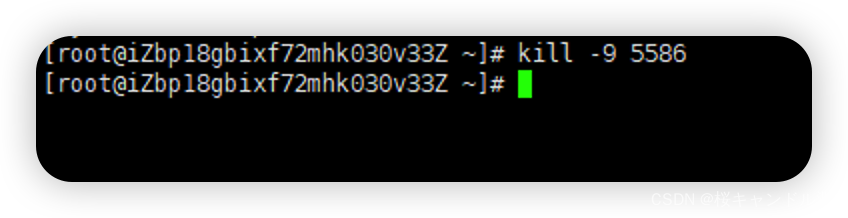
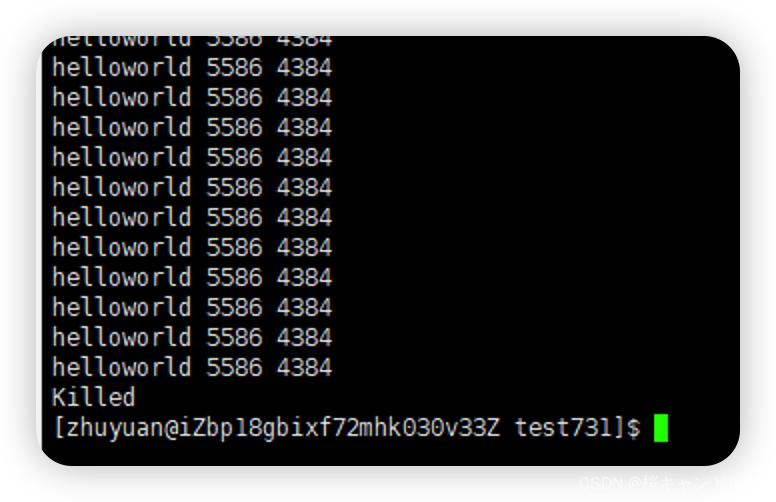
使用Ctrl+c(Mac为command+c)
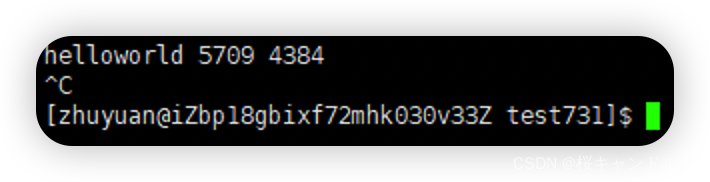
获得父进程id
getppid()
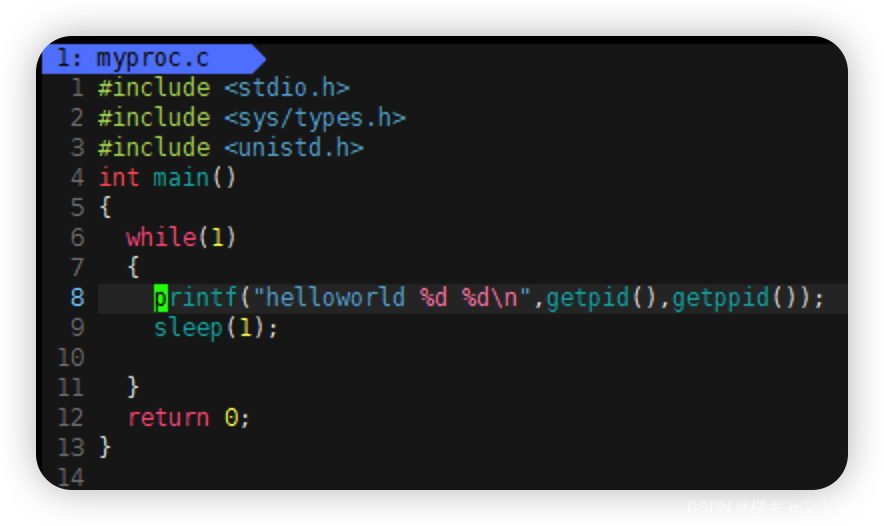
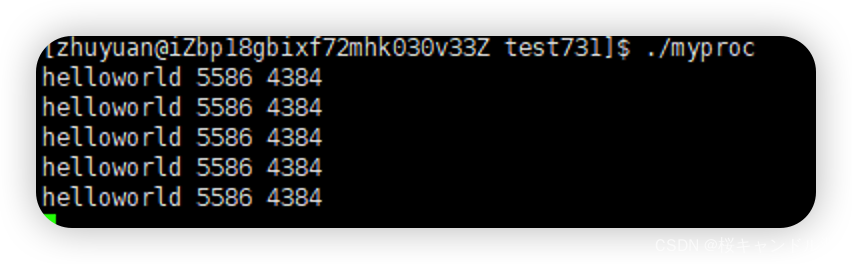
我们所有的进程都是以bash(也就是我们的shell的外壳程序)的子进程的形式进行的。
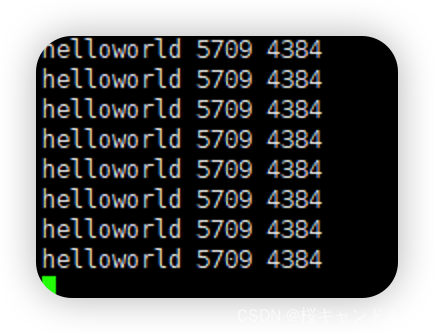
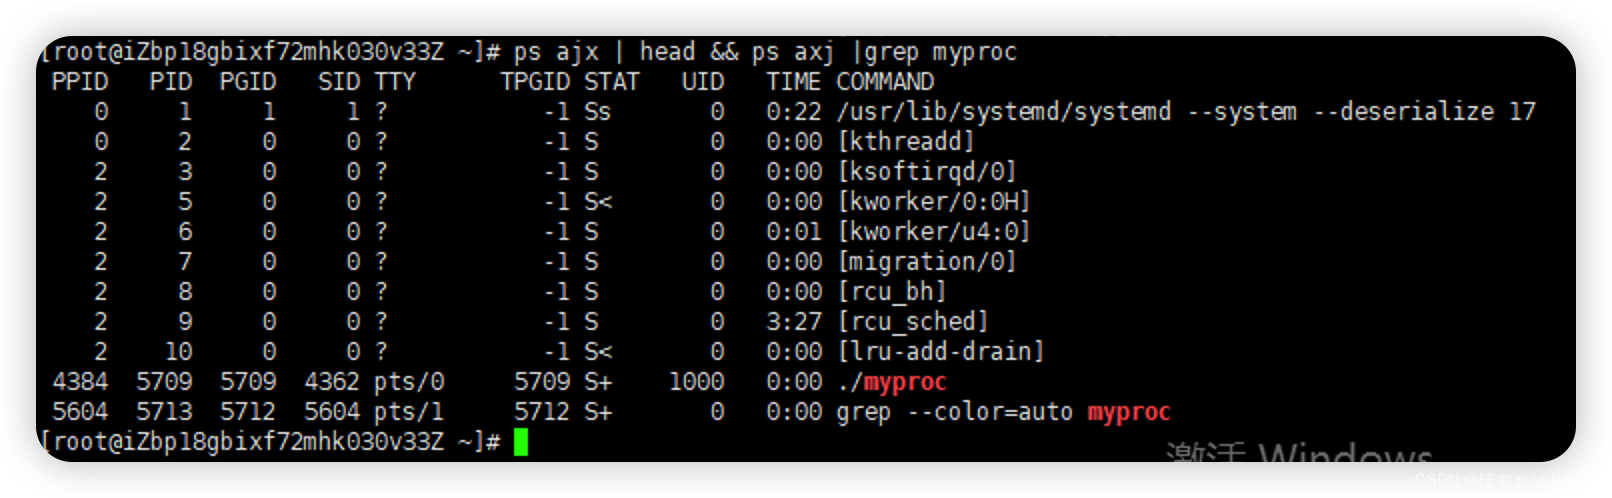
从上面的代码中我们可以查看到我们当前的子进程为5709,这个子进程的父进程是4384,那么这个4384进程是谁呢?我们进一步查看
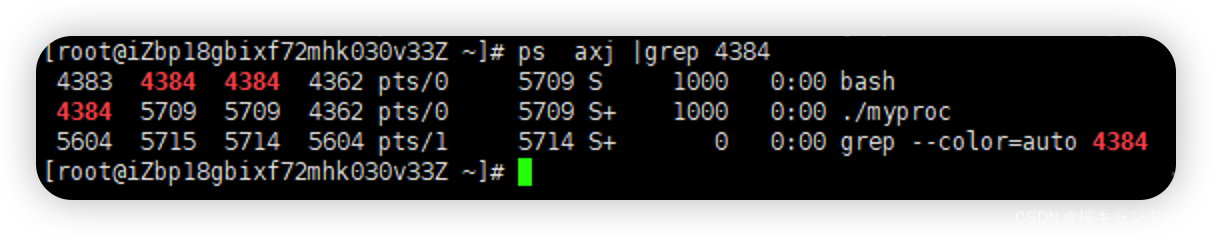
从上面的测试中,我们可以看到我们5709的父进程就是我们的bash进程
5.系统调用接口和创建子进程
fork创建一个子进程,要求包含
的头文件 pid_t fork(void) 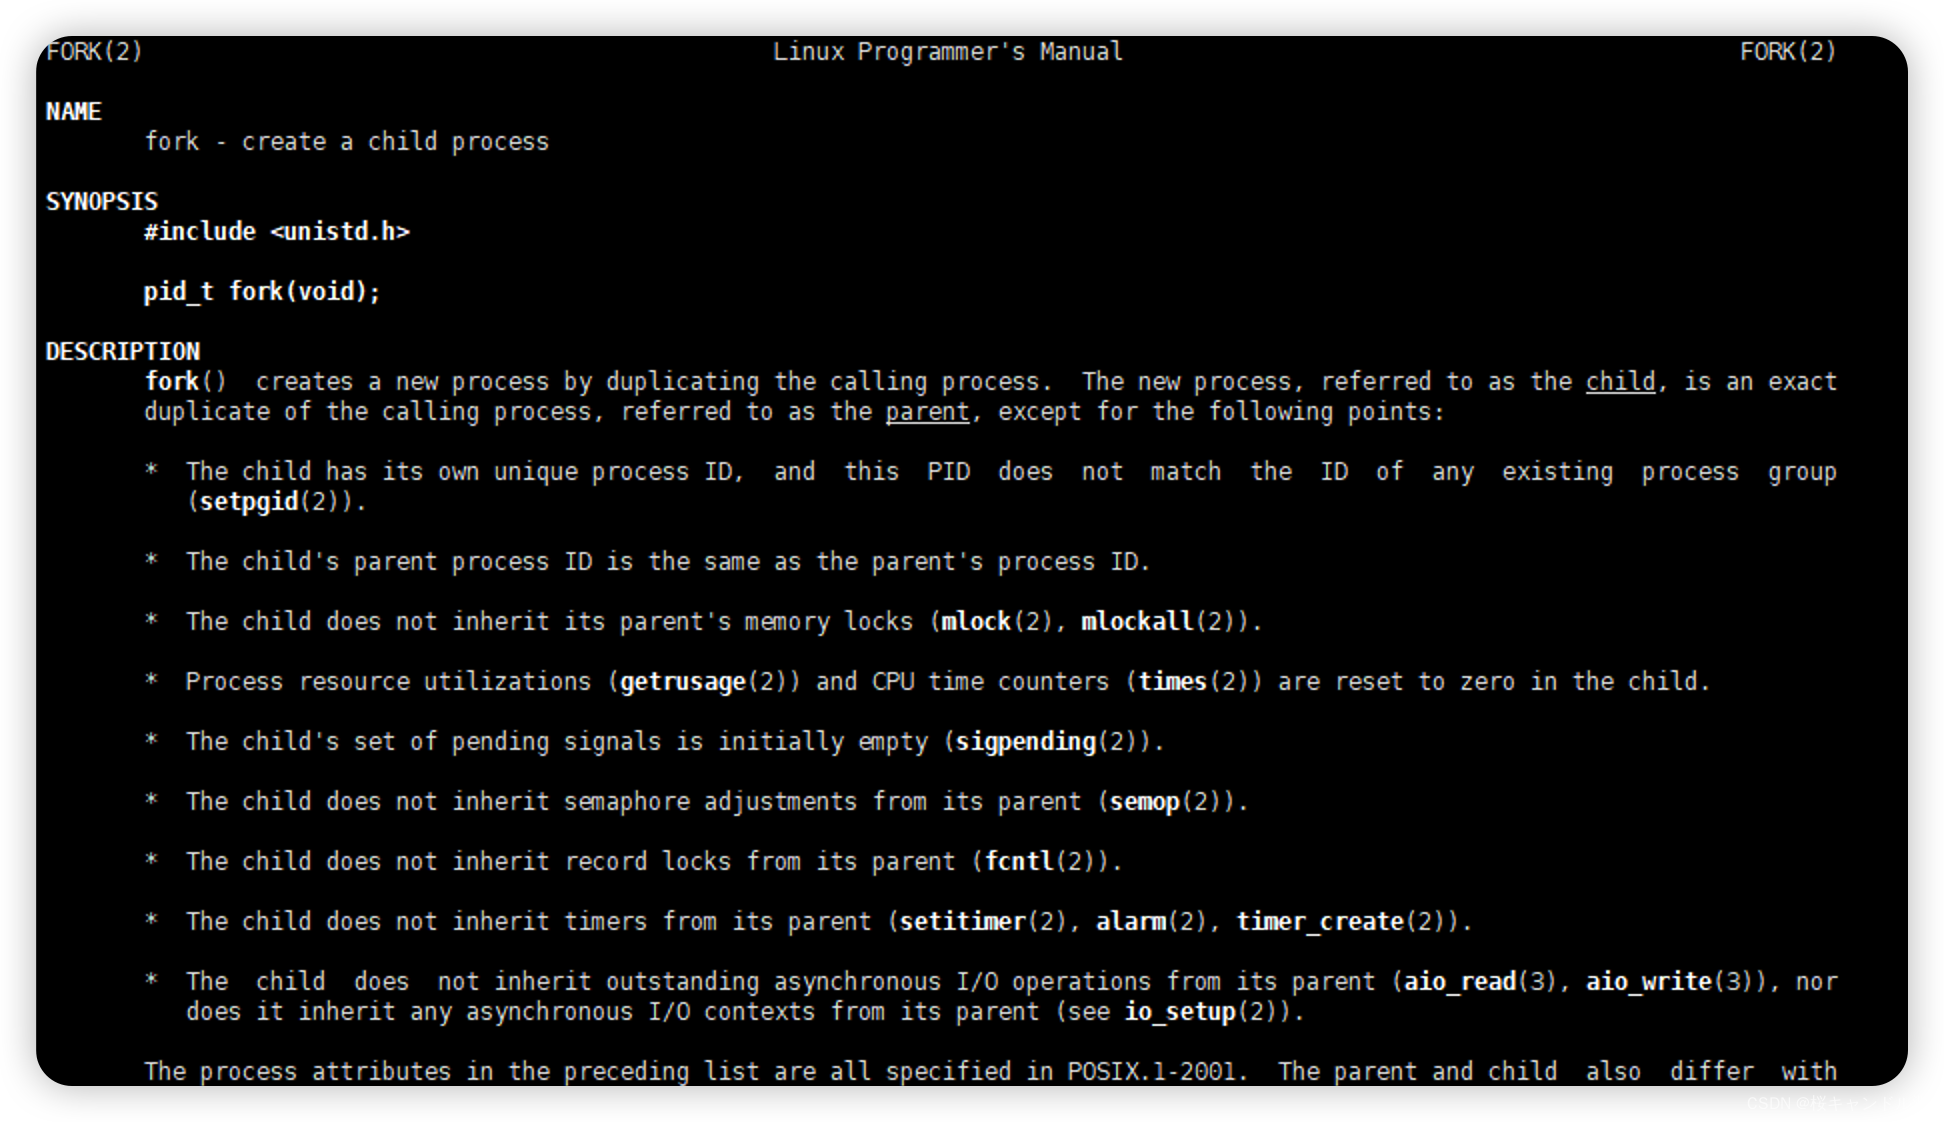
pid_t fork()fork的返回值有两大情况,
1.创建失败的时候返回-1
2.创建成功的时候,a.子进程的pid会返回给父进程
b.给子进程返回0
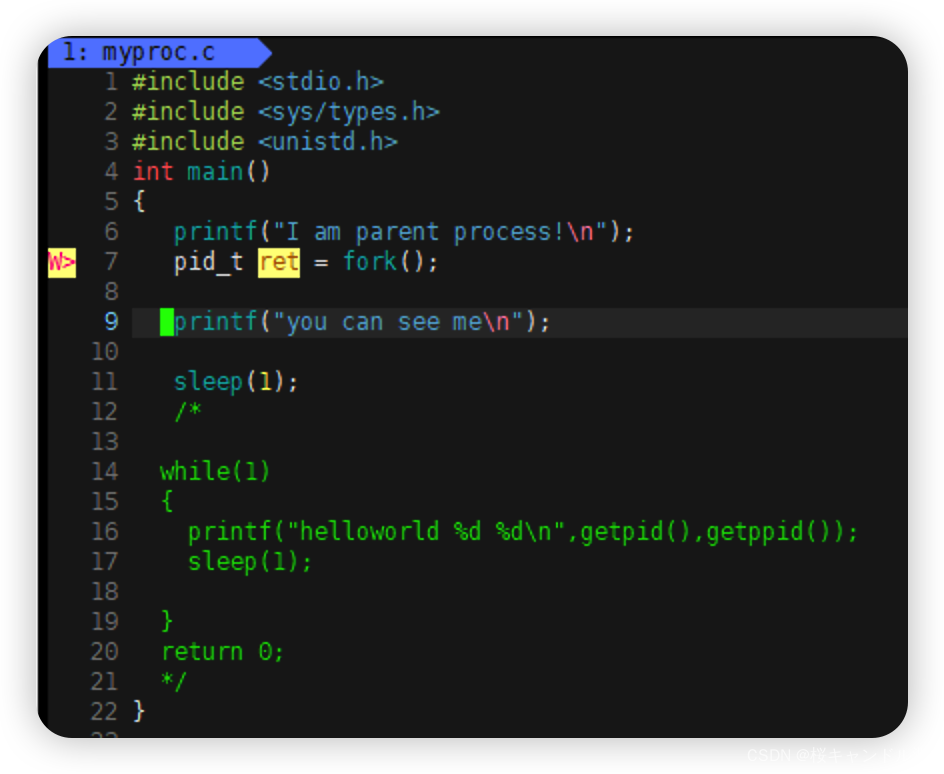
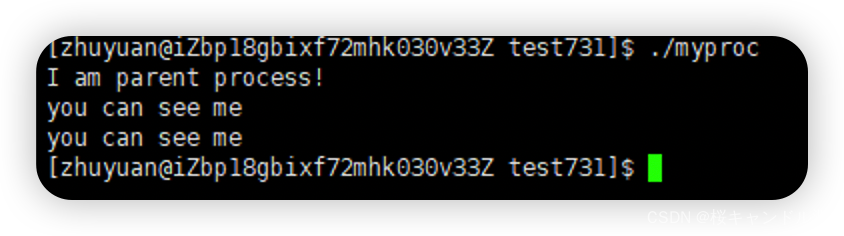
使用上面的代码之后,我们很吃惊的发现系统打印了两个you can see me
我们再尝试下面的代码
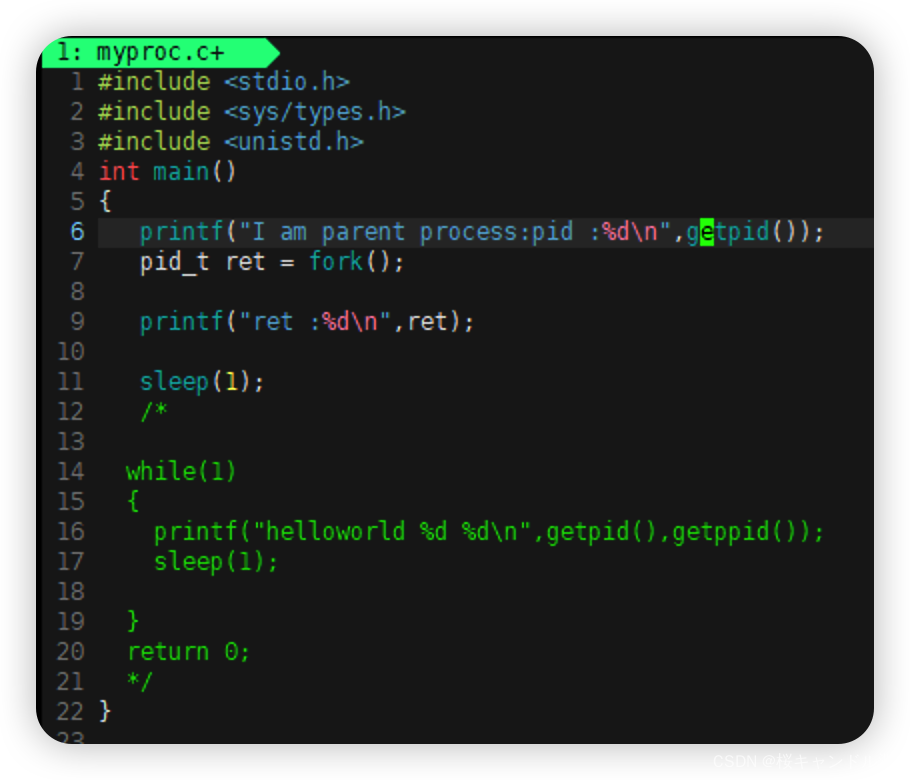
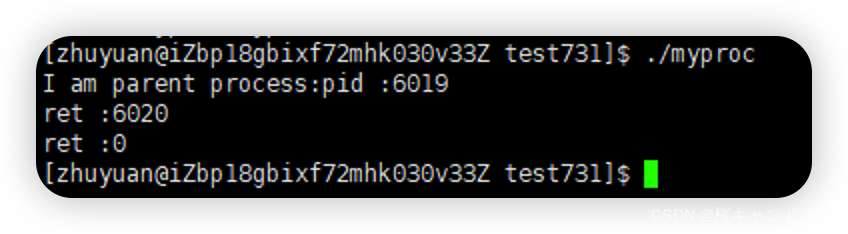
执行完上面的代码后,我们发现我们的ret竟然同时有两个值,我们再执行下面的代码进行进一步地查看。
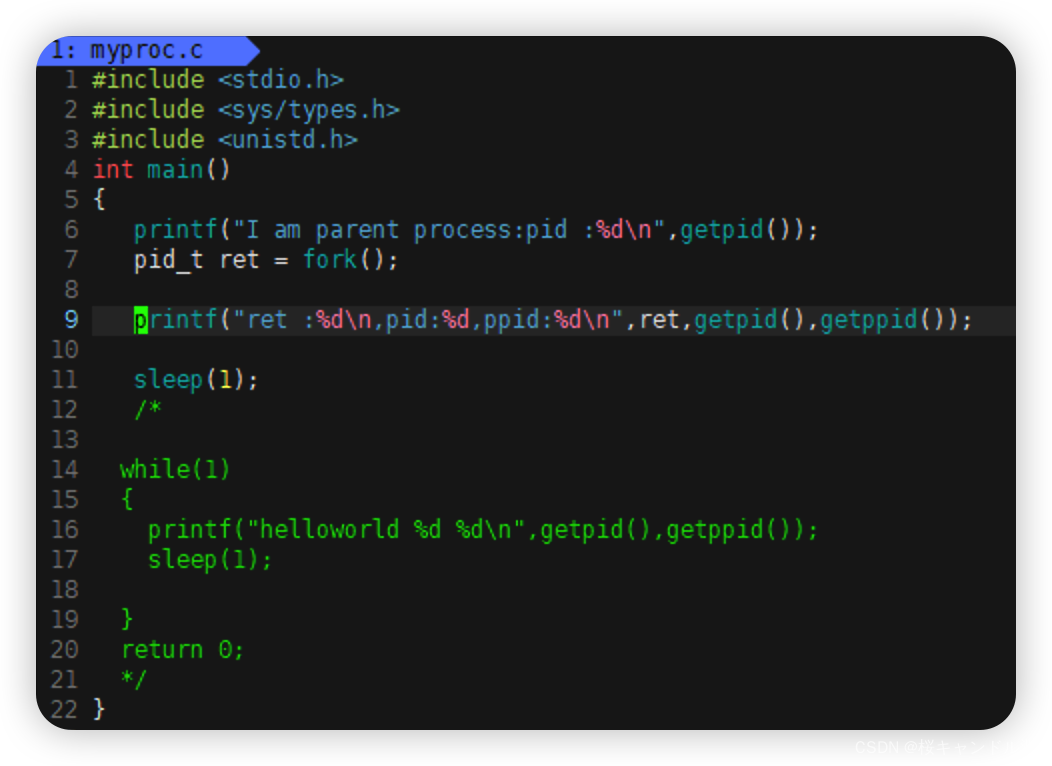
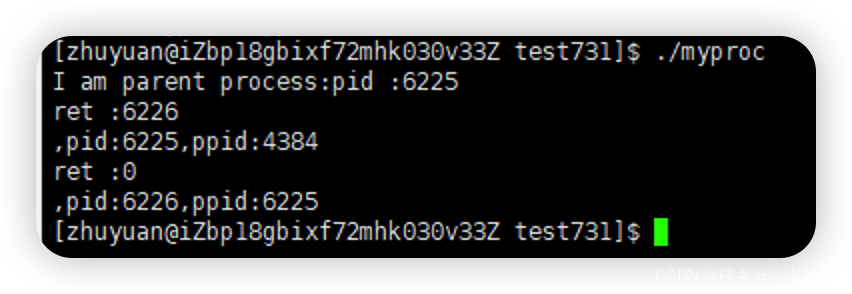
这里我们可以看出,我们原来的进程的编号为6625,然后我们使用fork()新创建了一个进程,创建成功,子进程为6226
然后我们的父进程这里先进行了打印,也就是6225,其父进程的父进程也就是4384也就是我们的bash,也就是我们的shell外壳进程(这里在上面我们有介绍,在同一次使用我们的Linux系统中,这个shell的进程编号是不变的)
然后我们的子进程也进行了打印,其ret值根据我们上面的fork的用法,创建成功给子进程返回0,然后打印子进程自身的编号为6226,其父进程为6225
从中我们可以看出,在fork之后,有两个进程进行了下面的代码,所以产生了两个返回的结果。
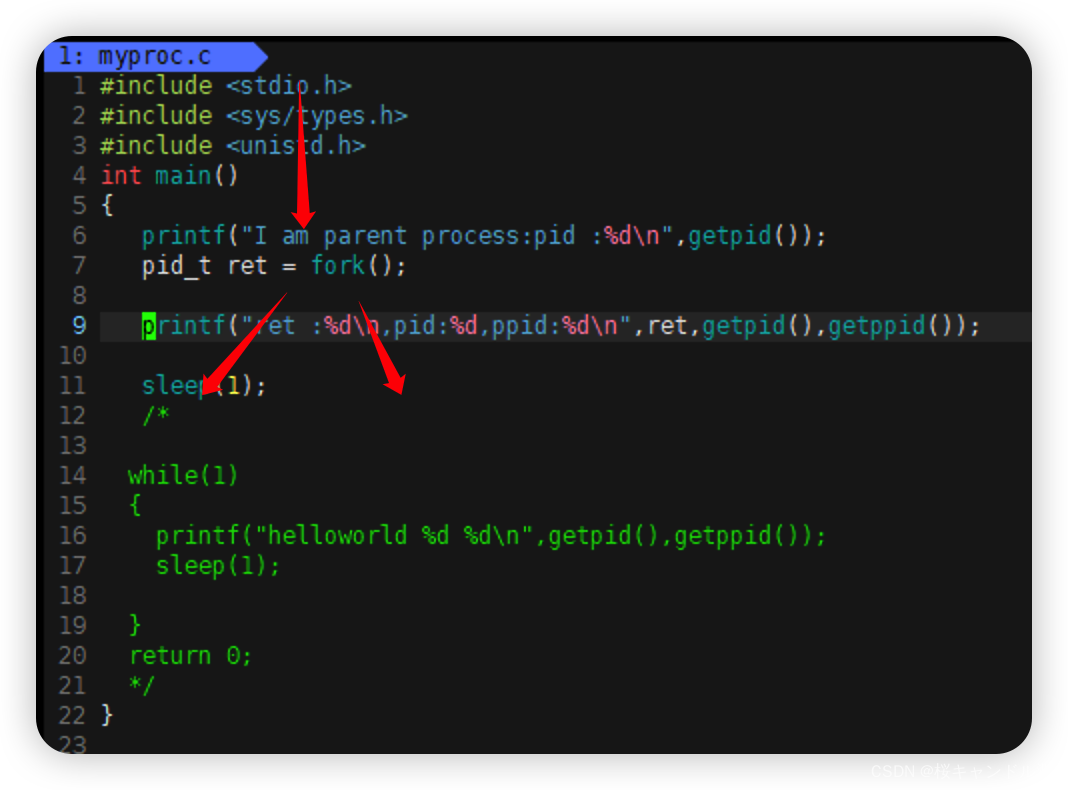
6.fork基本用法
fork帮我们创建了一个新的进程,也就是说帮助我们做事的人多了。
一般而言:fork之后,代码是父子共享的,也就是说运行之后父进程和子进程都能看到。
但是如果我们想要让我们的父进程和子进程执行不一样的代码,我们可以通过父子进程ID不一样的特点给我们的父子进程分配不同的任务。
下面我们让两个死循环同时执行
注意:id在父进程里面是子进程的pid在子进程里面是0,所以如果id==0的话,那么就是子进程,那么返回的ID是子进程的话就是父进程。
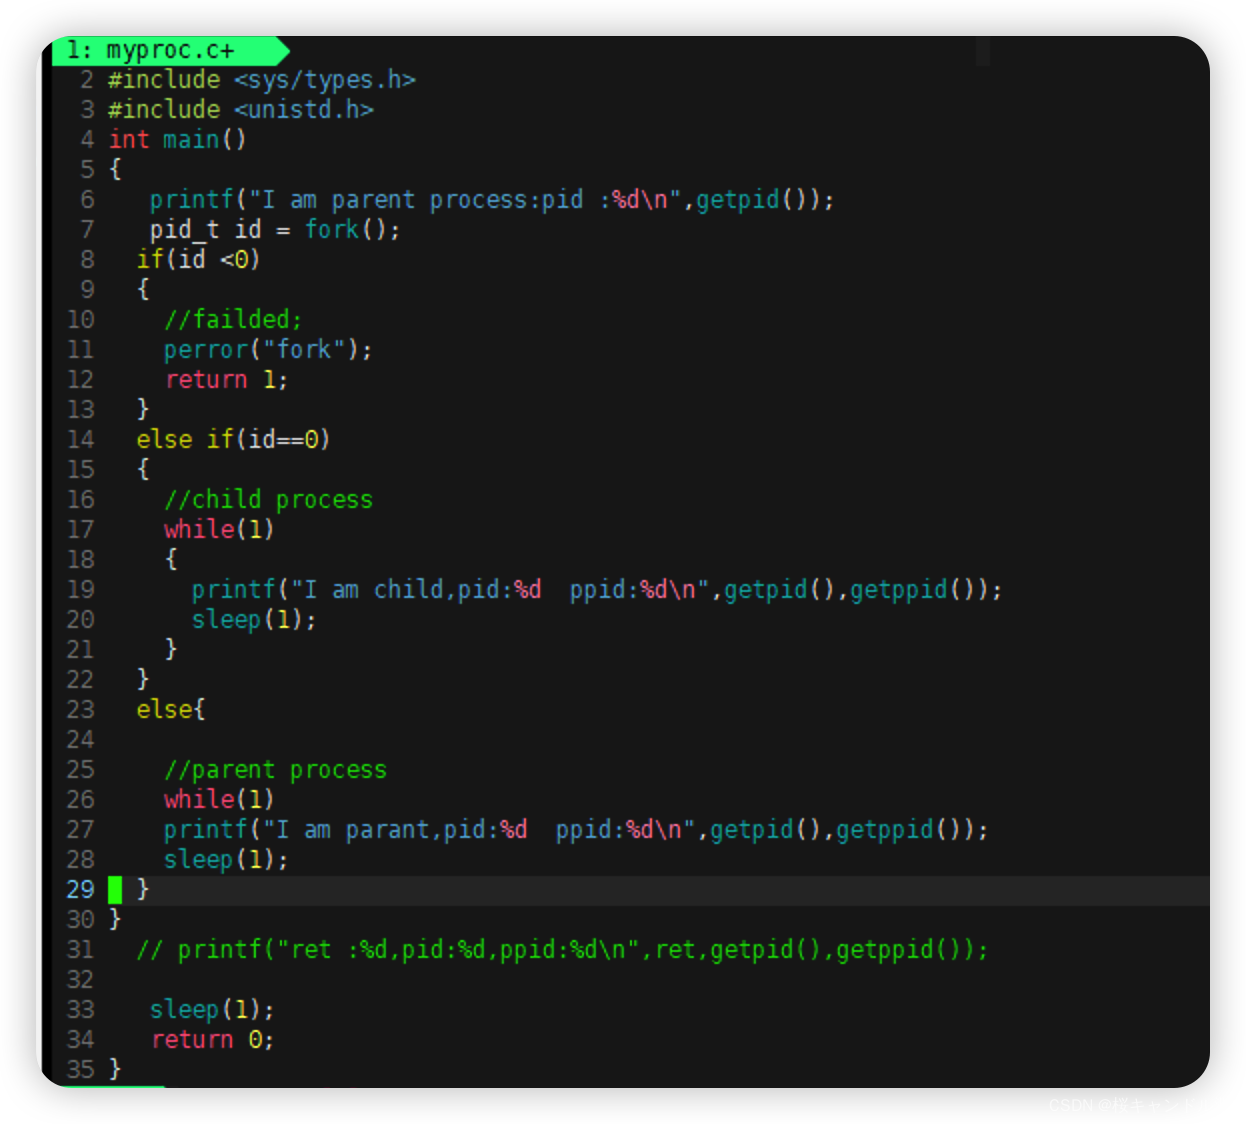
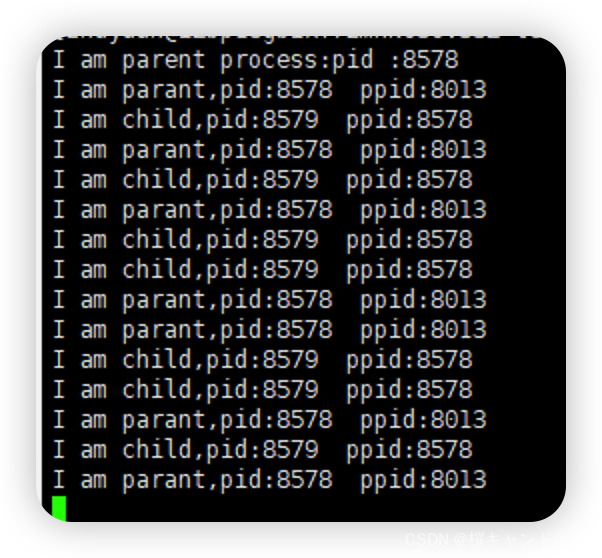
从上面的测试代码中我们可以看出父子进程执行了不同的代码
- 3 #include
- 4 int main()
- 5 {
- 6 printf("I am parent process:pid :%d\n",getpid());
- 7 pid_t id = fork();
- 8 if(id <0)
- 9 {
- 10 //failded;
- 11 perror("fork");
- 12 return 1;
- 13 }
- 14 else if(id==0)
- 15 {
- 16 //child process
- 17 while(1)
- 18 {
- 19 printf("I am child,pid:%d ppid:%d\n",getpid(),getppid());
- 20 sleep(1);
- 21 }
- 22 }
- 23 else{
- 24
- 25 //parent process
- 26 while(1)
- 27 {
- 28 printf("I am parant,pid:%d ppid:%d\n",getpid(),getppid());
- 29 sleep(1);
- 30 }
- 31 }
- 32
- 33 // printf("ret :%d,pid:%d,ppid:%d\n",ret,getpid(),getppid());
- 34
- 35 }
创建进程的时候,OS要做什么?本质,就是系统多了一个进程(要创建一个task_struct)
子进程的内部属性要以父进程为模板,将父进程的内部属性拷贝下来,复制给子进程。
- fork()
- {
- //创建子进程的逻辑
- return id;
- }
每一个CPU都会维护一个自己的运行队列,操作系统和CPU运行某一个进程,本质从task_struct形成的队列中挑选一个tasj_struct,来执行它的代码。
进程调度,变成了在task_struct的队列中选择一个进程的过程。
当我们已经准备return了,我们的核心代码已经执行完了吗?
①所以我们的return的时候,我们的计算结果已经完成,我们的核心代码其实已经被运行完了,我们的父进程和子进程都会return。
②但是返回两次并不代表着会保存两次。
- struct task struct{
- struct task_struct *next;
- int pid;
- int ppid;
- 状态;
- 优先级;
- ……
- }
只要想到进程,优先想到进程对应的task_struct。
父子进程创建出来,哪一个先运行呢?
不一定。由于我们的CPU是分时操作系统,要按照每一个进程被划分到的时间片来运行每一个进程。所以只有系统底层的进程调度算法才能够知道哪一个进程先运行, 我们目前无法得知。
四、进程状态
系统中一定是存在各种资源的(不仅是CPU),网卡,磁盘,显卡等其他设备。
系统中不一定只是存在一种队列,其中与CPU配套的队列称为运行队列
以下为操作系统的理论状态,不同操作系统有不同的具体实现。
新建:我们前面fork了一个新的进程就是新建状态
运行:task_struct结构体在运行队列中,就叫做运行态
阻塞:等待非CPU资源就绪,阻塞状态。
- int main()
- {
- int a=0;
- scanf("%d",&a);
- }
如果我们执行了上面的代码,但是我们就是没有把a的值从键盘输入进去,这时我们的这个进程就进入了阻塞状态。 有时候我们打开的软件卡死了,比如exe未响应,可能就是因为这个进程阻塞了。
挂起:当我们的内存快要不足的时候,操作系统会将长时间不执行的进程代码和数据换出到磁盘(磁盘中的swap分区,我们用户无法查看到)。(挂起和阻塞的区别,两种状态都是暂时得不到CPU的付出,但挂起态是将进程映像调到外存去了,而阻塞态下进程映像还在内存中)如果挂起态想要再次被运行,需要将之前挂起的进程数据重新调入内存中,进入运行队列。
如果是因为阻塞而挂起就称为阻塞挂起。
为了弄明白正在运行的进程是什么意思,我们需要知道进程的不同状态。一个进程可以有几个状态(在Linux内核里,进程有时候也叫做任务)。
下面的状态在kernel源代码里定义:/*
* The task state array is a strange "bitmap" of
* reasons to sleep. Thus "running" is zero, and
* you can test for combinations of others with
* simple bit tests.
*/
static const char * const task_state_array[] = {
"R (running)", /* 0 */
"S (sleeping)", /* 1 */
"D (disk sleep)", /* 2 */
"T (stopped)", /* 4 */
"t (tracing stop)", /* 8 */这里的小t和大T都是暂停状态,只不过t是调试过程中的暂停状态,也就是我们的gdb在我们的打断点的位置对我们的进程发送了第19号信号,让我们的进程停下来了。
"X (dead)", /* 16 */
"Z (zombie)", /* 32 */
};
使用下面的代码可以捕捉我们的myproc程序的当前的进程
while :; do ps axj|head -1 && ps ajx |grep myproc | grep -v grep;sleep 1; done;进程可以分为前台进程和后台进程
以下我们直接运行我们的死循环进程,也就是我们的前台进程
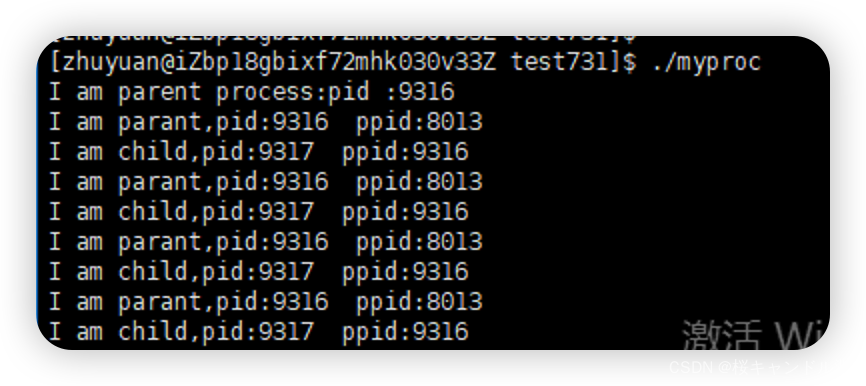
如果我们在我们运行的后面加上一个&就是后台进程,
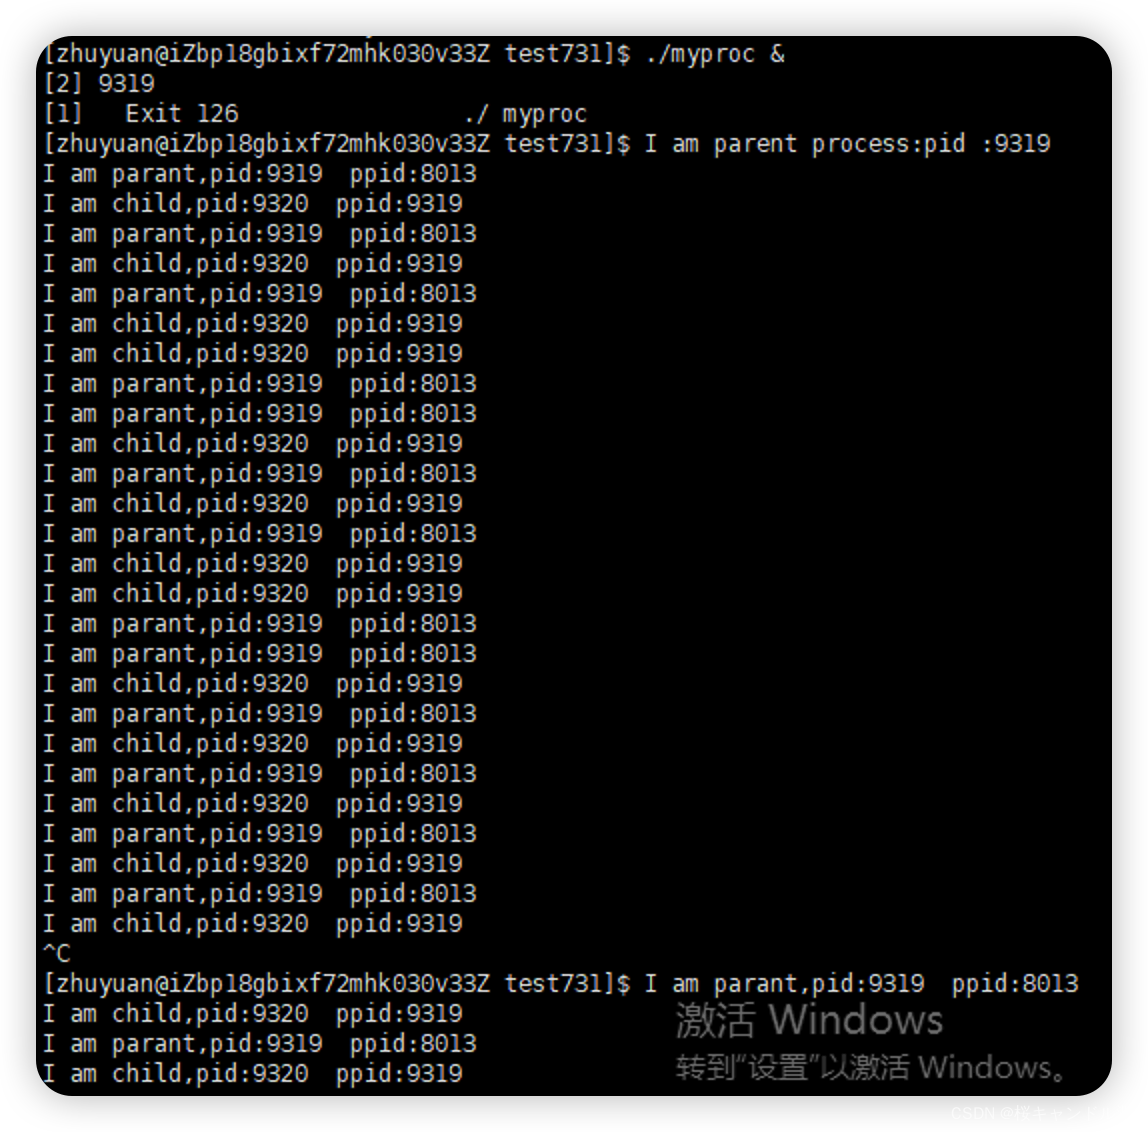
这个时候是没办法使用ctrl+c停止的,需要使用kill -9 再加上对应的进程编号
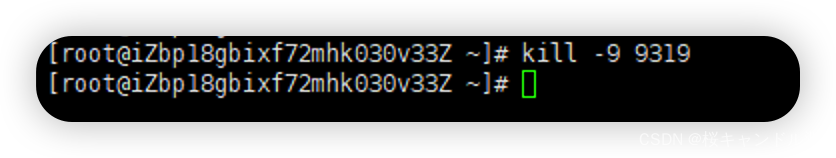
具体的
R运行状态(running)(运行态) : 并不意味着进程一定在运行中,它表明进程要么是在运行中要么在运行队列里。
S睡眠状态(sleeping)(阻塞状态): 意味着进程在等待事件完成(这里的睡眠有时候也叫做可中断睡眠(interruptible sleep))。(这里我们写的是一个死循环,这里的加号表示这是一个前台任务,就是说此时bash的解释器没办法再解释其他的命令,并且可以被ctrl+c终止。)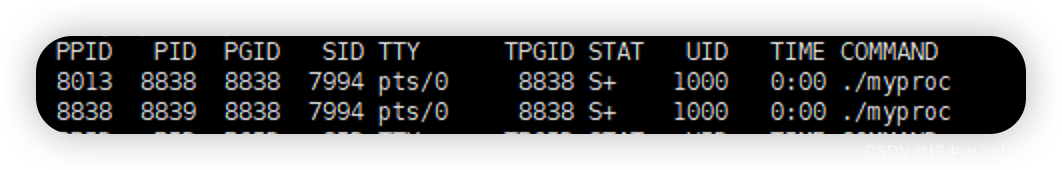
D磁盘休眠状态(Disk sleep)(阻塞状态)有时候也叫不可中断睡眠状态(uninterruptible sleep),在这个状态的进程通常会等待IO的结束。(只有等到这个磁盘读写进程的结果出来的时候系统才能干掉这个进程。)(可通过dd命令)
T停止状态(stopped)(阻塞状态): 可以通过发送 SIGSTOP 信号给进程来停止(T)进程。这个被暂停的进程可以通过发送 SIGCONT 信号让进程继续运行。(我们给我们的四循坏代码输入kill -19 再加上进程号,就能让我们的进程停止,再输入kill -18 再加上进程号就能够让我们刚刚暂停的进程重新进行)(调试的过程中就是停滞状态)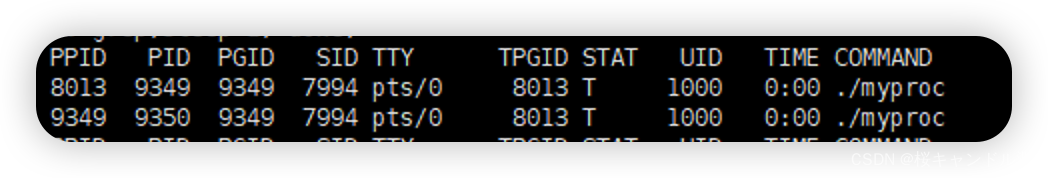
X死亡状态(dead):这个状态只是一个返回状态,你不会在任务列表里看到这个状态 (终止状态。瞬时性非常强,这个状态出现了,操作系统马上就会将这个进程的所占用的资源全部回收,咱可能看不到这个状态。)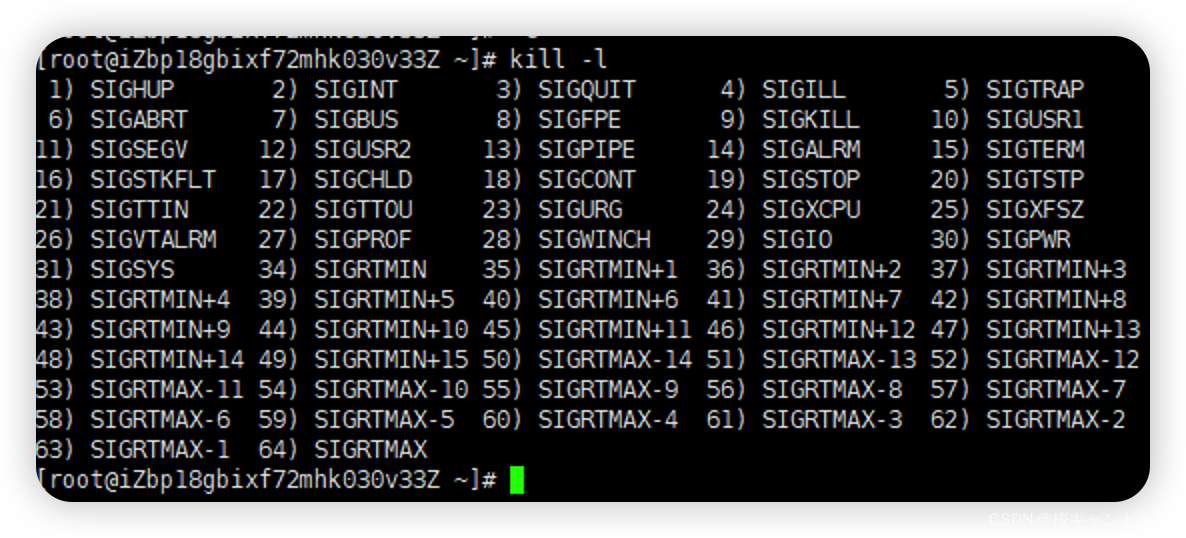
进程状态查看
使用下面的代码可以查看进程状态的查看
ps aux / ps axjZ(zombie)-僵尸进程
僵死状态(Zombies)是一个比较特殊的状态。当进程退出并且父进程(使用wait()系统调用)没有读取到子进程退出的返回代码时就会产生僵死(尸)进程。僵死进程会以终止状态保持在进程表中,并且会一直在等待父进程读取退出状态代码。所以,只要子进程退出,父进程还在运行,但父进程没有读取子进程状态,子进程进入Z状态
僵尸状态是什么?
举一个例子:如果一个程序员连续几天加班之后突然寄了,那么这个时候,这个人不是立马抬走,而是会有警方介入,封锁现场,确认调查结果,确认真的是过度加班才导致死亡的时候,才会将人送走。这个过程中, 警方调查死因的过程中,这个程序员,也就好比是我们的进程,就是僵尸进程了。(一个进程已经被退出,但是还不允许OS被释放,处于一个被检测状态--僵尸状态。维持僵尸状态是为了让父进程和OS来进行回收)
父进程或者操作系统主动去检测子进程是不是僵尸进程。
- 1 #include
- 2 #include
- 3 #include
- 4 #include
- 5 int main()
- 6 {
- 7 printf("I am parent process:pid :%d\n",getpid());
- 8 pid_t id = fork();
- 9 if(id <0)
- 10 {
- 11 //failded;
- 12 perror("fork");
- 13 return 1;
- 14 }
- 15 else if(id==0)
- 16 {
- 17 //child process
- 18 while(1)
- 19 {
- 20 printf("I am child,pid:%d ppid:%d\n",getpid(),getppid());
- 21 sleep(3);
- 22 break;
- 23 }
- 24 exit(0);
- 25 }
- 26 else{
- 27
- 28 //parent process
- 29 while(1)
- 30 {
- 31 printf("I am parant,pid:%d ppid:%d\n",getpid(),getppid());
- 32 sleep(1);
- 33 }
- 34 }
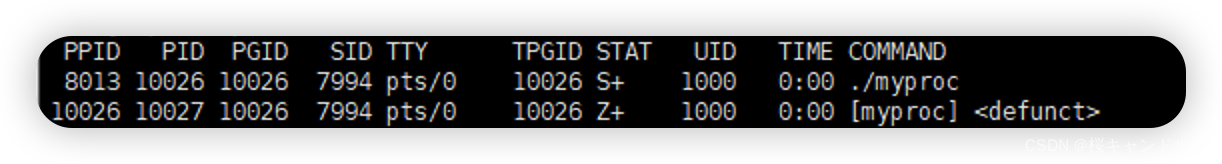
在上面的代码中,我们的子进程已经挂掉了,而父进程还在运行,所以子进程就呈现出僵尸状态。
僵尸进程危害
进程的退出状态必须被维持下去,因为他要告诉关心它的进程(父进程),你交给我的任务,我办的怎么样了。可父进程如果一直不读取,那子进程就一直处于Z状态?是的!
维护退出状态本身就是要用数据维护,也属于进程基本信息,所以保存在task_struct(PCB)中,换句话说, Z状态一直不退出, PCB一直都要维护?是的!
那一个父进程创建了很多子进程,就是不回收,是不是就会造成内存资源的浪费?是的!因为数据结构对象本身就要占用内存,想想C中定义一个结构体变量(对象),是要在内存的某个位置进行开辟空间!
内存泄漏?是的! -
相关阅读:
用postman发请求显示类型转换错误
B. Bin Packing Problem(线段树+multiset)
动态RDLC报表(七)
基础DFS与BFS
药企速看?四川省药品上市许可持有人制度试点方案
Redis缓存面临的缓存穿透问题
js中的同步任务、异步任务、宏任务、微任务
【学习】python装饰器
drools执行完某个规则后终止别的规则执行
Material ShapeableImageView 使用详解
- 原文地址:https://blog.csdn.net/weixin_62684026/article/details/126057522

- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读