-
Pytorch框架学习记录4——数据集的使用(torchvision.dataset)
Pytorch框架学习记录4——数据集的使用(torchvision.dataset)
1. 数据集
在pytorch官网中我们可以看到pytorch自身所配有的数据集的情况,以及该数据集的类型、使用方法等。在这里,我们选择数据集较小的CIFAR10作为我们的示例数据集。
该数据集的调用和使用使用代码如下:
torchvision.datasets.CIFAR10(root: str, train: bool = True, transform: Optional[Callable] = None, target_transform: Optional[Callable] = None, download: bool = False)- 1
参数说明:
- root ( string ) – 数据集的根目录,
cifar-10-batches-py如果下载设置为 True,则该目录存在或将保存到该目录。 - train ( bool , optional ) – 如果为真,则从训练集创建数据集,否则从测试集创建。
- transform ( callable , optional ) – 一个函数/转换,它接受 PIL 图像并返回转换后的版本。例如,
transforms.RandomCrop - target_transform ( callable , optional ) – 接收目标并对其进行转换的函数/转换。
- download ( bool , optional ) – 如果为 true,则从 Internet 下载数据集并将其放在根目录中。如果数据集已经下载,则不会再次下载。
2. 使用实例
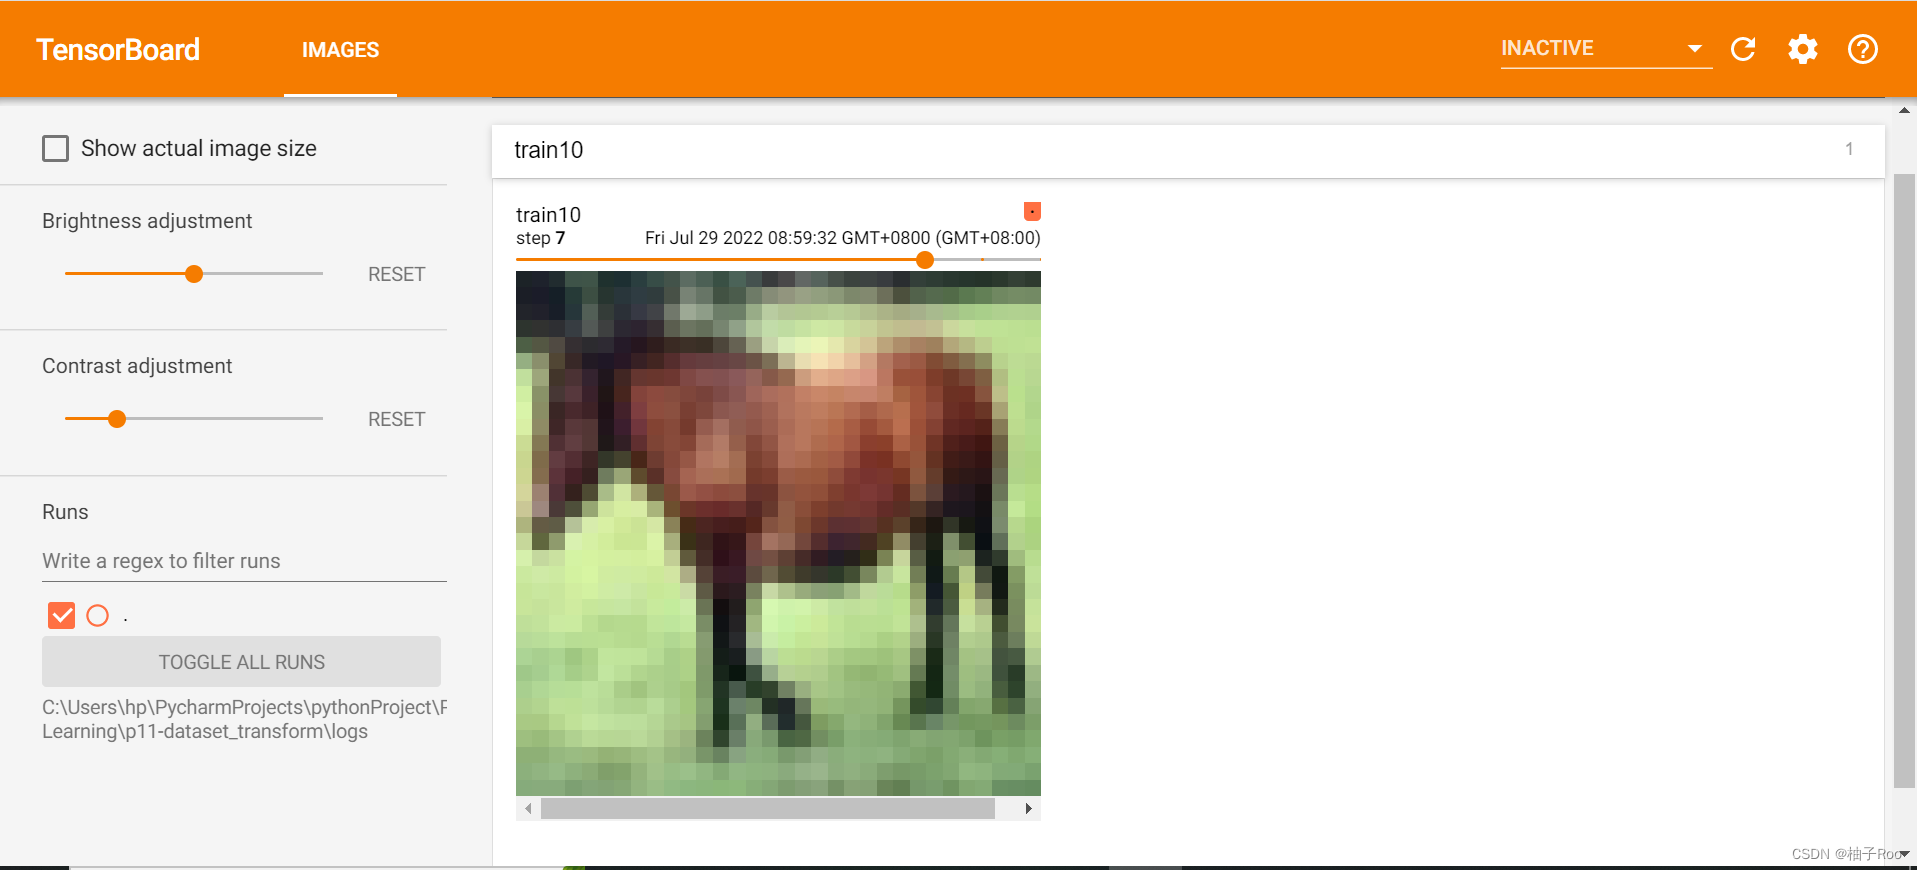
下载CIFAR10数据集后,将其类型转换为tensor类型,并在tensorboard中进行展示。
import torchvision from torch.utils.tensorboard import SummaryWriter from torchvision.transforms import transforms dataset_transform = transforms.Compose([ transforms.ToTensor() ]) train_set = torchvision.datasets.CIFAR10(root='./dataset', train=True, transform=dataset_transform, download=True) test_set = torchvision.datasets.CIFAR10(root='./dataset', train=False, transform=dataset_transform, download=True) writer = SummaryWriter('logs') for i in range(10): img, label = train_set[i] writer.add_image('train10', img, i) writer.close()- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
此外,还可以直接通过链接使用浏览器下载,下载完毕后,在当前目录下也命名一个dataset文件夹并放入,上述代码不做任何改变,会自动将手动下载的数据集进行解压和修正。
-
相关阅读:
圣杯布局和双飞翼布局
使用泛型 implRust 中的块
视觉信息处理和FPGA实现第二次作业
MB51选择屏幕与报表增强
心法利器[102] | 大模型落地应用架构的一种模式
对“Linux中遇到的RAID阵列”好好总结一次
怎样在应用中实现自助报表功能?
数字IC笔试千题解--编程&&脚本篇(八)
MySQL进阶09_锁
TR5521设计资料|TR5521替代方案|DP转VGA设计参考
- 原文地址:https://blog.csdn.net/qq_45955883/article/details/126048277

- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读