-
不依赖第三方库,原生C代码进行BASE64编码解码
用C语言代码进行BASE64的编码和解码,可以使用第三方库OpenSSL的相关函数,但在编译后的程序运行时依赖 LIBEAY32.DLL 或者 libcrypto-3-x64.dll 文件,缺点显而易见:编译后的程序在缺乏这些.DLL文件的系统里无法正常运行。要么使用静态编译,在编译的参数里增加:-static -lssl -lcrypto -lz -lpthread -lgdi32,使得生成的exe程序具备可移植性,能在别人的Windows系统里正常运行,但程序的体积增加不少。
我在寻求不依赖第三方库,仅使用C语言自带库的来进行BASE64编码解码的原生代码。于是在网上找到这个:
作者:John,发表日期:2017年11月18日
该代码用 gcc 或 clang 均可成功编译,运行起来看起来没问题。
但作者只是示范了对英文字符进行编码解码,当我尝试对中文编码解码时,发现编码没问题,倒是解码出了问题,多出一个不可识别的字符:
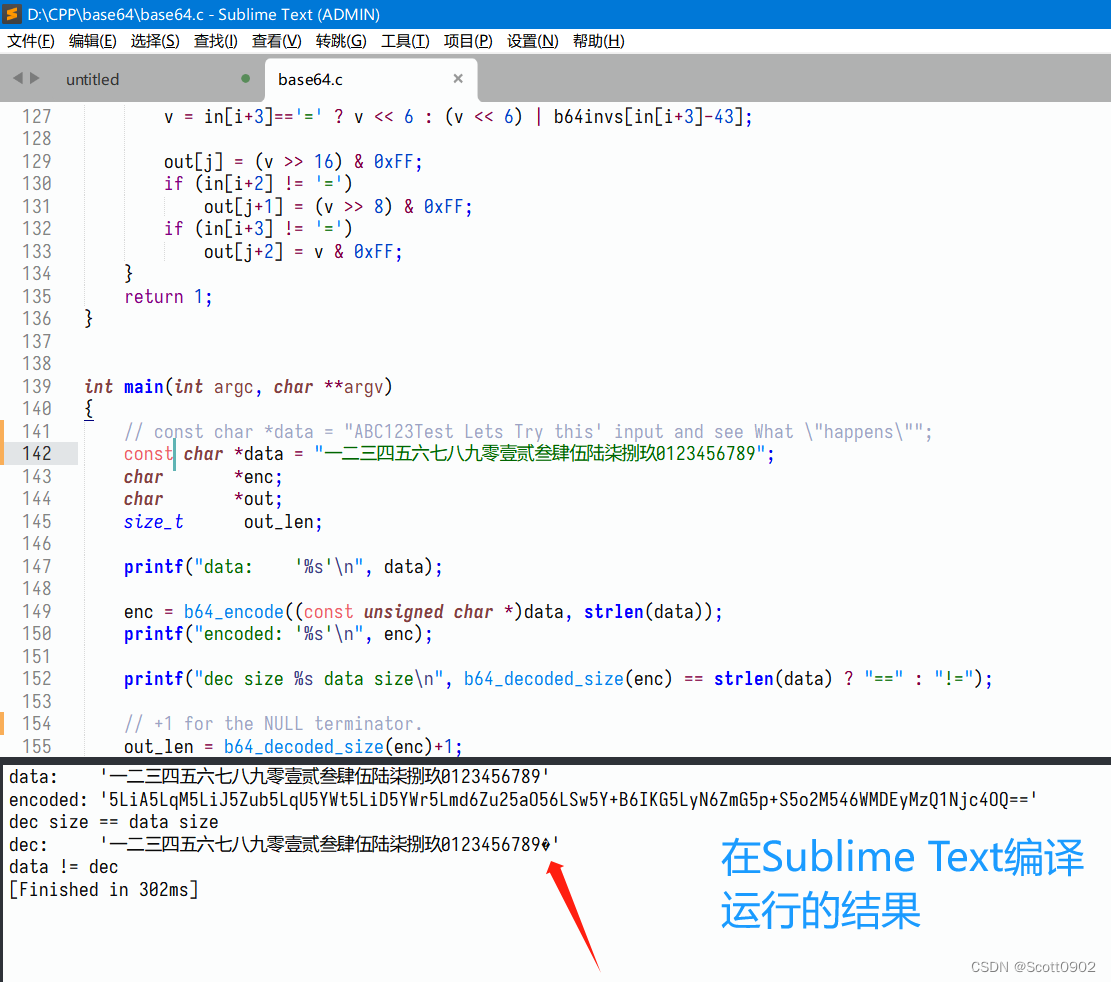
而且解码字符串末尾多出来的字符随着每次运行都不一样。
于是怀疑是解码字符串在分配内存环节上有问题。
作者在代码里对声明 out_len 变量一行作了注释:+1是为了留多一个字节的空间来加上“\0”终止符。
- // +1 for the NULL terminator.
- out_len = b64_decoded_size(enc)+1;
我尝试一下把这一行代码末尾的“+1”去掉,变成:out_len = b64_decoded_size(enc);
这样一来,解码后的字符串在分配内存上就刚刚好,没有多余的空间,解码后的字符串末尾就不会有奇怪的字符了。
完整的代码如下:
- #include
- #include
- #include
- #include
- const char b64chars[] = "ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789+/";
- int b64invs[] = { 62, -1, -1, -1, 63, 52, 53, 54, 55, 56, 57, 58,
- 59, 60, 61, -1, -1, -1, -1, -1, -1, -1, 0, 1, 2, 3, 4, 5,
- 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20,
- 21, 22, 23, 24, 25, -1, -1, -1, -1, -1, -1, 26, 27, 28,
- 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42,
- 43, 44, 45, 46, 47, 48, 49, 50, 51 };
- size_t b64_encoded_size(size_t inlen) {
- size_t ret;
- ret = inlen;
- if (inlen % 3 != 0)
- ret += 3 - (inlen % 3);
- ret /= 3;
- ret *= 4;
- return ret;
- }
- char *b64_encode(const unsigned char *in, size_t len) {
- char *out;
- size_t elen;
- size_t i;
- size_t j;
- size_t v;
- if (in == NULL || len == 0)
- return NULL;
- elen = b64_encoded_size(len);
- out = malloc(elen+1);
- out[elen] = '\0';
- for (i=0, j=0; i
- v = in[i];
- v = i+1 < len ? v << 8 | in[i+1] : v << 8;
- v = i+2 < len ? v << 8 | in[i+2] : v << 8;
- out[j] = b64chars[(v >> 18) & 0x3F];
- out[j+1] = b64chars[(v >> 12) & 0x3F];
- if (i+1 < len) {
- out[j+2] = b64chars[(v >> 6) & 0x3F];
- } else {
- out[j+2] = '=';
- }
- if (i+2 < len) {
- out[j+3] = b64chars[v & 0x3F];
- } else {
- out[j+3] = '=';
- }
- }
- return out;
- }
- size_t b64_decoded_size(const char *in) {
- size_t len;
- size_t ret;
- size_t i;
- if (in == NULL)
- return 0;
- len = strlen(in);
- ret = len / 4 * 3;
- for (i=len; i-->0; ) {
- if (in[i] == '=') {
- ret--;
- } else {
- break;
- }
- }
- return ret;
- }
- void b64_generate_decode_table(){
- int inv[80];
- size_t i;
- memset(inv, -1, sizeof(inv));
- for (i=0; i<sizeof(b64chars)-1; i++) {
- inv[b64chars[i]-43] = i;
- }
- }
- int b64_isvalidchar(char c){
- if (c >= '0' && c <= '9')
- return 1;
- if (c >= 'A' && c <= 'Z')
- return 1;
- if (c >= 'a' && c <= 'z')
- return 1;
- if (c == '+' || c == '/' || c == '=')
- return 1;
- return 0;
- }
- int b64_decode(const char *in, unsigned char *out, size_t outlen) {
- size_t len;
- size_t i;
- size_t j;
- int v;
- if (in == NULL || out == NULL)
- return 0;
- len = strlen(in);
- if (outlen < b64_decoded_size(in) || len % 4 != 0)
- return 0;
- for (i=0; iif (!b64_isvalidchar(in[i])) {return 0;}}for (i=0, j=0; iv = b64invs[in[i]-43];v = (v << 6) | b64invs[in[i+1]-43];v = in[i+2]=='=' ? v << 6 : (v << 6) | b64invs[in[i+2]-43];v = in[i+3]=='=' ? v << 6 : (v << 6) | b64invs[in[i+3]-43];out[j] = (v >> 16) & 0xFF;if (in[i+2] != '=')out[j+1] = (v >> 8) & 0xFF;if (in[i+3] != '=')out[j+2] = v & 0xFF;}return 1;}int main(int argc, char **argv){// 自动切换至UTF-8环境输出if (GetConsoleOutputCP() != CP_UTF8) SetConsoleOutputCP(CP_UTF8);const char *data = "一二三四五六七八九零壹贰叁肆伍陆柒捌玖0123456789";char *enc;char *out;size_t out_len;printf("Original str:\t%s\n", data);enc = b64_encode((const unsigned char *)data, strlen(data));printf("BASE64 encoded:\t%s\n", enc);printf("dec size %s data size\n", b64_decoded_size(enc) == strlen(data) ? "==" : "!=");// +1 for the NULL terminator.// out_len = b64_decoded_size(enc)+1;out_len = b64_decoded_size(enc);out = malloc(out_len);if (!b64_decode(enc, (unsigned char *)out, out_len)) {printf("Decode Failure\n");return 1;}out[out_len] = '\0';printf("BASE64 decoded:\t%s\n", out);printf("data %s dec\n", strcmp(data, out) == 0 ? "==" : "!=");free(out);return 0;}
运行结果:
- Original str: 一二三四五六七八九零壹贰叁肆伍陆柒捌玖0123456789
- BASE64 encoded: 5LiA5LqM5LiJ5Zub5LqU5YWt5LiD5YWr5Lmd6Zu25aO56LSw5Y+B6IKG5LyN6ZmG5p+S5o2M546WMDEyMzQ1Njc4OQ==
- dec size == data size
- BASE64 decoded: 一二三四五六七八九零壹贰叁肆伍陆柒捌玖0123456789
- data == dec
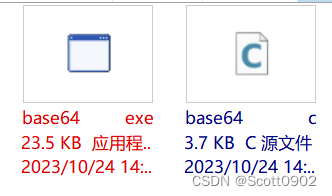
用 clang 编译后的.exe文件只有23.5KB,不依赖第三方DLL文件。C语言的代码虽然比较冗长,但编译的结果很小很精致。
如果使用 OpenSSL 库来写base64编码解码又如何?
下面是使用OpenSSL库的示范代码:
- #include
- #include
- #include
- #include
- #include
- char* base64_encode(const char* input, size_t input_len)
- {
- BIO *bio, *b64;
- FILE* stream;
- int encoded_size;
- b64 = BIO_new(BIO_f_base64());
- bio = BIO_new(BIO_s_mem());
- bio = BIO_push(b64, bio);
- BIO_set_flags(bio, BIO_FLAGS_BASE64_NO_NL);
- BIO_write(bio, input, input_len);
- BIO_flush(bio);
- BIO_get_mem_data(bio, &stream);
- encoded_size = BIO_get_mem_data(bio, &stream);
- char* encoded = (char*)malloc(encoded_size + 1);
- memcpy(encoded, stream, encoded_size);
- encoded[encoded_size] = '\0';
- BIO_free_all(bio);
- return encoded;
- }
- char* base64_decode(const char* input, size_t input_len, size_t* output_len)
- {
- BIO *bio, *b64;
- int decoded_size;
- char* decoded = NULL;
- b64 = BIO_new(BIO_f_base64());
- bio = BIO_new_mem_buf(input, input_len);
- bio = BIO_push(b64, bio);
- BIO_set_flags(bio, BIO_FLAGS_BASE64_NO_NL);
- decoded_size = (input_len * 3) / 4;
- decoded = (char*)malloc(decoded_size);
- *output_len = BIO_read(bio, decoded, input_len);
- BIO_free_all(bio);
- return decoded;
- }
- int main()
- {
- if (GetConsoleOutputCP() != CP_UTF8) SetConsoleOutputCP(CP_UTF8);
- const char *text1 = "一二三四五六七八九零壹贰叁肆伍陆柒捌玖0123456789";
- char *text2 = base64_encode(text1, strlen(text1));
- printf("Original str:\t%s\nBASE64 encoded:\t%s\n", text1, text2);
- size_t output_len=0;
- text2 = base64_decode(text2, strlen(text2), &output_len);
- printf("BASE64 decoded:\t%s\n", text2);
- free(text2);
- return 0;
- }
clang编译参数加上:-lcrypto -lz
运行结果:
- Original str: 一二三四五六七八九零壹贰叁肆伍陆柒捌玖0123456789
- BASE64 encoded: 5LiA5LqM5LiJ5Zub5LqU5YWt5LiD5YWr5Lmd6Zu25aO56LSw5Y+B6IKG5LyN6ZmG5p+S5o2M546WMDEyMzQ1Njc4OQ==
- BASE64 decoded: 一二三四五六七八九零壹贰叁肆伍陆柒捌玖0123456789
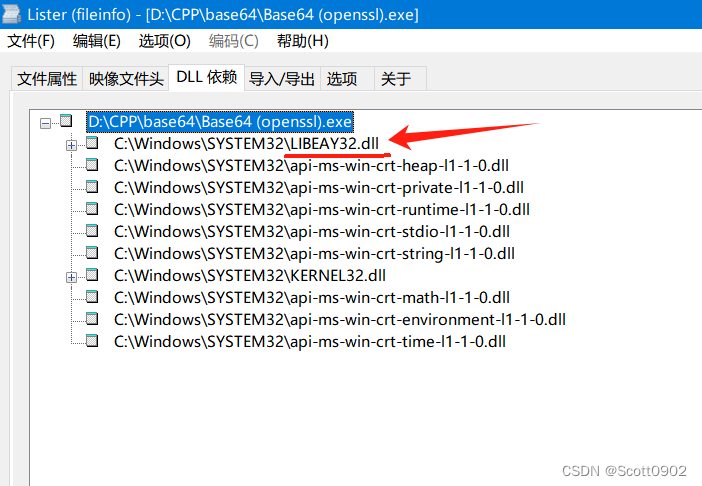
编译后的可执行文件大约24KB,但这是动态链接编译,我在 Total Commander 按 F3 键查看编译后的可执行文件,点击“DLL依赖”,可见它依赖 LIBEAY32.DLL,而这个.DLL文件并非所有系统都有。
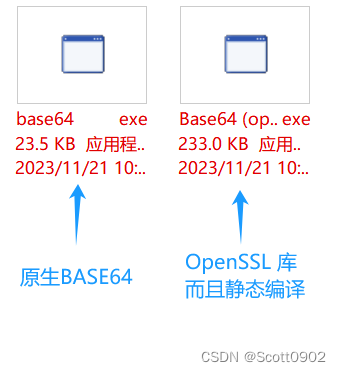
如果采用静态编译的方法,编译参数加上:-static -lcryto -lz,编译后的可执行文件增长到233KB。
- 相关阅读:
UDP多播
IT项目管理成功的技巧通常有哪些?
深度学习系列47:styleGAN总结
Java面试题:Redis分片集群结构
reactive和effect,依赖收集触发依赖
shell三剑客-----sed命令
C++全局变量和局部变量
Nacos集群和持久化配置(重要)
HTML5 跨屏前端框架 Amaze UI
2023亚太杯数学建模思路 - 复盘:光照强度计算的优化模型
- 原文地址:https://blog.csdn.net/Scott0902/article/details/134011444
