-
python-(6-3-3)爬虫---requests入门(对参数封装)
一 需求
爬取豆瓣电影的“纪录片”的电影信息数据
二 分析
老规矩,先在网页的“检查”中提取我们需要的信息
如下图所示。在“纪录片”那一页面,选择"network"----“XHR”----“preview”。
我们需要在3个文件中选择,罗列出如图页面电影数据的那个文件。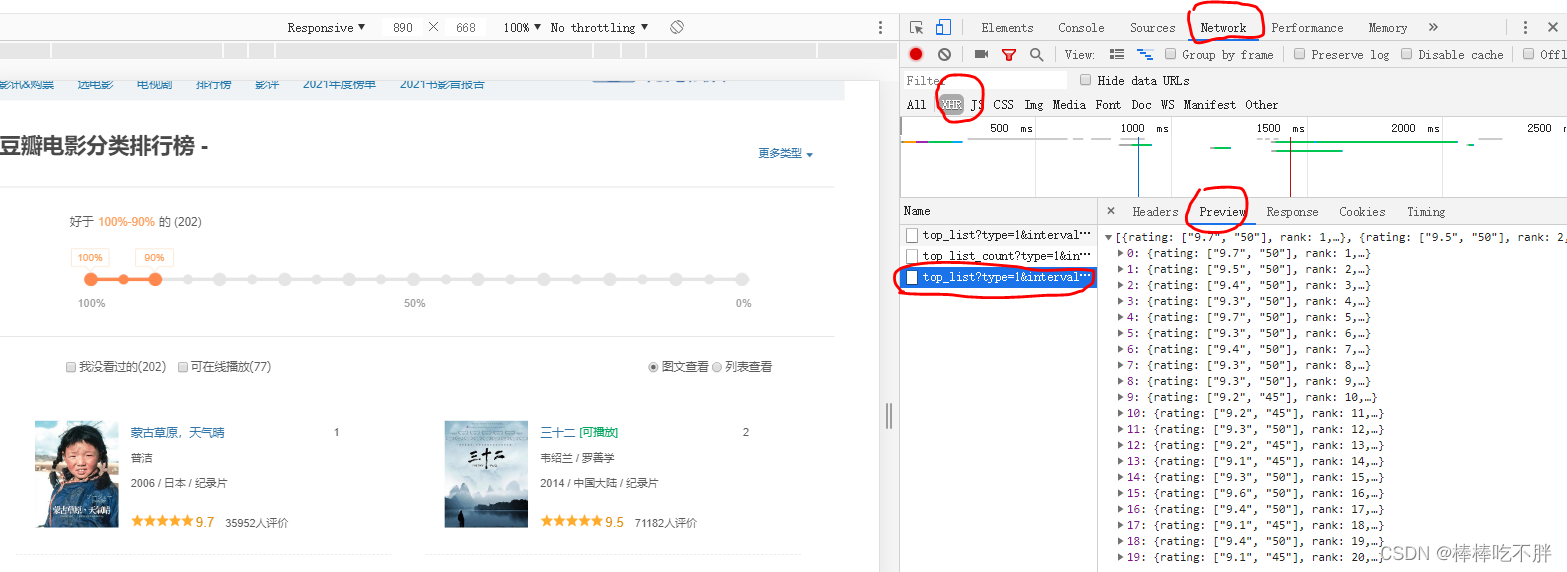
通过点开1-19数字前面的三角形,我们可以查看到每部电影的具体信息,这就是我们要爬取的数据内容。然后从“preview"切换到”headers",可以得到URL与访问网站请求的方式
get,于是明白了在下面的代码中应该是requests.get()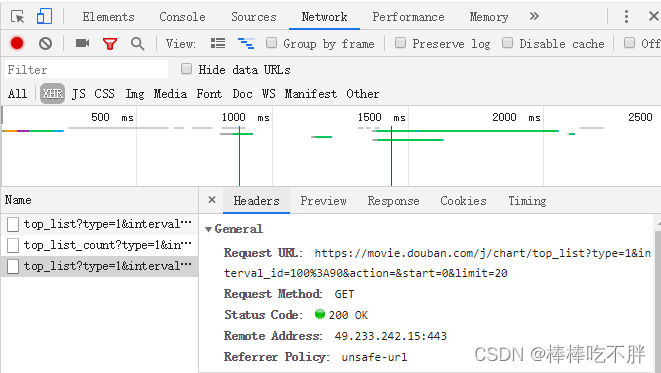
不难发现,在代码中赋值给URL变量的内容显得十分冗长(问号后面的内容都是参数),一方面笔者希望将其缩短;
另一方面,由于把网页下拉,会出现新的电影信息,我们为了获取更多更新的电影数据,也需要通过修改参数的方式,从而爬取新的数据。所以我们将页面下拉,找到其他代码编写时需要的信息。
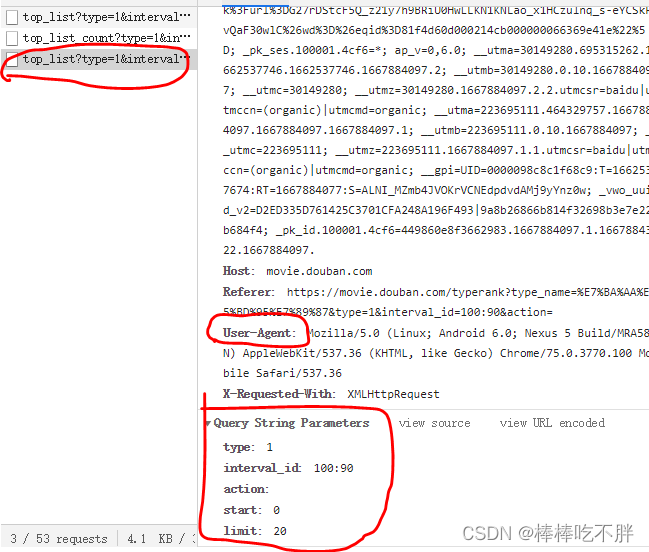
提前剧透一下,由于网站设立了反爬机制,所以我们需要
User-Agent进行伪装。而最下面的一系列参数就是我们需要的信息。
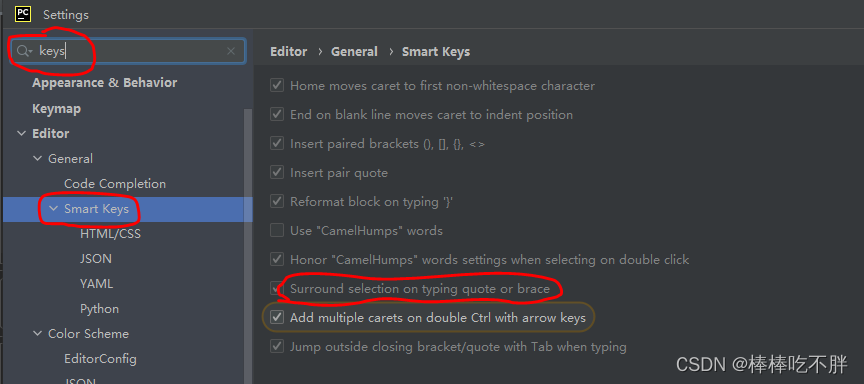
另外,这些参数会以字典的形式体现,因此需要将其全部加上双引号括起来,所以要在pycharm中如下图设置。将圈中的内容打勾后(意思是,单引号或双引号会悬浮环绕在周围),我们将某一段字符选中,直接打出双引号或者单引号符号,就可以为该段字符加上单引号或双引号。
三 代码
import requests # 找到的url url = "https://movie.douban.com/j/chart/top_list" # 要封装的参数 # 原本url的问号后面的都是参数,我们将这部分内容封装成下面的参数 param = { "type": "1", "interval_id": "100:90", "action": "", "start": "0", "limit": "20" } # 伪装成正常浏览器用户访问 headers = { "User-Agent": "Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Mobile Safari/537.36" } # 发送的get请求,封装参数,并伪装成浏览器 response = requests.get(url=url,params=param,headers=headers) # 将服务器返回的数据直接返回成json格式 print(response.json()) # 关闭访问的链接,防止以后访问其他网页报错 response.close()- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
四 补充说明
当我们把网页内容往下拉取,希望看到更多的电影资源时,我们代码中封装的参数会发生改变。经过对比,只有
start变化。所以如果想看到更多的电影信息,只需要改变start后面的值即可。 -
相关阅读:
spark 读操作
springboot项目配置ssl证书
Unity Xlua热更新框架(七):声音与事件管理
微信小程序积分活动有哪些玩法
linux0.11-虚拟内存
Vue3 —— 常用 Composition API(零)(setup函数、ref函数、reactive函数、响应式、reactive对比ref)
精彩数据:2021年我国民旅客周转量6530亿公里,审定受理飞机2803架
飞书ChatGPT机器人 – 打造智能问答助手实现无障碍交流
c# Word操作
【计算机网络笔记】Web应用之HTTP协议(涉及HTTP连接类型和HTTP消息格式)
- 原文地址:https://blog.csdn.net/oldboy1999/article/details/127749099

- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读