-
c++中和c语言不相同的地方
c++糅合了c语言的语法,并且在c语言的基础上进行了改进,并且具有向下兼容的特性;
但是c++改进了什么东西呢?今天就来学习一下吧;

目录
命名空间 (namespace)
在使用c语言写代码的时候,我们有时候会碰到这种报错:

有时候是因为代码过长,忘记自己已经定义了这个变量,有时候兴许是某处的域没注意到;
就会出现这种状况;
而c++针对这种情况推出了一个新的语法——命名空间;
语法:
namespace (命名空间名)
{
(变量表)
}使用方法:
(命名空间名):: (变量名);
or
using namespace (命名空间名);
我们看看实例:
- #include
- namespace Date {
- int year = 2022;
- int month = 9;
- int date = 28;
- }
- int main()
- {
- int date = 10;
- printf("%d\n%d", Date::date, date);
- return 0;
- }

我们可以看到,编译器没有报错,并且成功的输出了结果;

而c++中我们用的最多的命名空间就是std了;
那么std又是什么命名空间呢?
这里我们就不得不提一下c++专用的输入输出语句了;
cout与cin与endl
c++中,更新了新的输入输出方式:cout与cin;
其使用方式是:
int a ;
std::cin>>a;
std::cout<
正如上面所写,所谓cin和cout实际上也是在一个命名空间中有的,大家可能很疑惑,cout和cin按理说应该是函数一类,为何会在命名空间中呢?
实际上命名空间中不仅可以设置变量,你还可以设定函数,结构体等一系列东西;

那么这两个输入输出语句有什么特别之处,能够胜过scanf和printf呢?
这就不得不聊到c++中新添加的几个运算符了
流插入符与流运算符
流插入运算符:>>
流提取运算符: >>
在c语言中提到的流只有在文件中用到过,比如 fgetc 或者 fgets 是从文件流中提取字符或者字符串;
而c++则可以利用cin和cout直接提取流用来输入或者输出,并且会自动辨别变量的类型;

可以自动辨别!这可是一个好东西啊,以后要多用,当然也有人觉得 std:: 这个前缀很麻烦,我们可以在使用 cin 和 cout 之前写下 "using namespace std;"就可以了;
提到了using namespace std;之后,就不得不提到命名空间这个用法的缺陷了;
using namespace (命名空间名)的缺陷
之前提到过,命名空间的最大的好处是可以避免重命名的错误,但是当我们使用这条语句后,这个好处就没有了;
就好像原本紧闭的大门被开了一个洞,大家都能随便进出了;
因此是否使用这条语句,还得看实际场景;
当然,这个缺陷c++的创始人当然也发现了,于是他有一个好点子——局部展开;
语法:
using namespace (命名空间名):: (空间内部变量);
这样大部分都能避免重定义,并且可以指展开常用的;
命名空间的嵌套和合并
命名空间虽然内部的变量不能直接使用,但是其实内部变量全部都是全局变量;
只是因为namespace限定了这些变量的访问方式;
因此,命名空间又有一个骚操作——合并

命名空间的合并只有一个条件——空间名相同;
就像这样:
- #include
- using namespace std;
- namespace Date {
- int year = 2022;
- }
- namespace Date {
- int month = 9;
- int date = 28;
- }
- int main()
- {
- int date = 10;
- printf("%d\n%d", date, Date::date);
- return 0;
- }

就像这样;
而命名空间既然只是将域限定了,那么命名空间内部能不能再限定一个域呢?
答案是肯定的,这就是命名空间的第二个骚操作之——嵌套;
- namespace Date
- {
- int year = 2022;
- int month = 9;
- int day = 28;
- namespace Week {
- int Mon = 1;
- int Tue = 2;
- }
- }
- int main()
- {
- cout << Date::Week::Mon << endl;
- return 0;
- }

实际上这个嵌套不过是在命名空间内再搞一个命名空间罢了,大家了解一下就可以了;

引用
在c语言中,我们如果需要用函数将两个变量的值交换的时候,我们需要用到指针才能将数据成功交换;
但是指针比较难,因此c++对此进行了改进,那就是引用;
什么是引用?
实际上就是相当于给变量起了一个别名;
- int main()
- {
- int a = 10;
- int& ra = a;
- ra = 0;
- cout << ra << endl;
- return 0;
- }

我们可以看到,变量 a 的值确实改变了,这就是引用的作用;
有的同学就会问了,这有什么,我们指针也能改变 a 的值啊,有什么用啊?
虽然这里表现上看上去和指针类似,实则大不相同;
我们的指针其实也是一种变量,只是这个变量里面存的是另一个变量的地址,而指针依旧占用内存;
而引用则不同,引用实际上就是相当于给变量起了一个别名,实际上并没有占用内存;
既然知道了引用和指针的区别,我们就来继续了解一下引用的规则;
1:引用必须一开始就初始化;
2:一个变量可以有多个引用;
3:引用初始化一个实体后,就不能引用别的实体;
了解后,我们再来了解引用的一些奇奇怪怪的错误;
常引用

如图上所示,我们设了一个常变量a,并且用 ra 引用 a,却显示错误;
这就涉及了权限的放大和缩小了;
我们这张图就是典型的权限放大;
const int a 是一个常变量,只可读,不可写;
而 ra 则是一个变量,可读,可写;
这就涉及到了权限放大,而权限只能缩小不能放大;
但是如果我们反过来
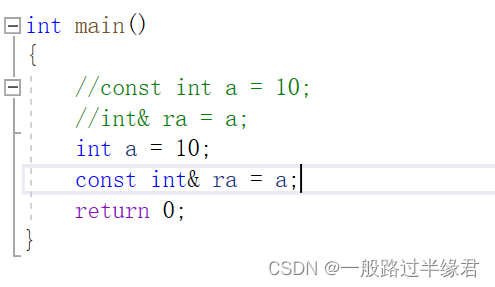
这样就可以了;
按照上面的说法,ra只可读,不可写,而a可读可写,因此是权限缩小,可以使用;
当然,若是两边权限相同当然是可以的

两边都只可读不可写,权限的平移,因此可以;
做返回值
当用引用返回的时候,有一个需要注意的地方,那就是那个引用的实体地址不在栈区;
又或者说,引用的实体的地址没有被销毁;

就像这样,途中a的值已经修改成a了,但是输出依旧是0;
这是因为返回的n的空间已经被销毁了,可以随意访问,那么自然a的值就会被随机改变了;
因此我们需要给n加个修饰符;

这样就没出错了;
引用做返回值的好处
对比:
- struct A { int a[10000]; };
- A a;
- // 值返回
- A TestFunc1() { return a; }
- // 引用返回
- A& TestFunc2() { return a; }
- void TestReturnByRefOrValue()
- {
- // 以值作为函数的返回值类型
- size_t begin1 = clock();
- for (size_t i = 0; i < 100000; ++i)
- TestFunc1();
- size_t end1 = clock();
- // 以引用作为函数的返回值类型
- size_t begin2 = clock();
- for (size_t i = 0; i < 100000; ++i)
- TestFunc2();
- size_t end2 = clock();
- // 计算两个函数运算完成之后的时间
- cout << "TestFunc1 time:" << end1 - begin1 << endl;
- cout << "TestFunc2 time:" << end2 - begin2 << endl;
- }
- int main()
- {
- TestReturnByRefOrValue();
- return 0;
- }

我们发现,引用做返回值的时候,其实还是很好用的,对性能消耗是非常小的;
引用和指针的对比
1. 引用概念上定义一个变量的别名,指针存储一个变量地址。2. 引用 在定义时 必须初始化 ,指针没有要求3. 引用 在初始化时引用一个实体后,就 不能再引用其他实体 ,而指针可以在任何时候指向任何 一个同类型实体4. 没有 NULL 引用 ,但有 NULL 指针5. 在 sizeof 中含义不同 : 引用 结果为 引用类型的大小 ,但 指针 始终是 地址空间所占字节个数7. 有多级指针,但是没有多级引用8. 访问实体方式不同, 指针需要显式解引用,引用编译器自己处理9. 引用比指针使用起来相对更安全别看引用和指针有这么多不同,其实引用和指针在底层设计都是类似的;

当我们转到反汇编看汇编代码的时候,我们发现,这两个在底层逻辑是一样的;
重载函数
在c语言中,不能够有相同名字的函数,但是在c++中,有一个新的概念名叫函数的重载;
可以使得我们的函数可以名字相同而不报错;
我们可以看看

我们可以看到确实是运行了起来,那么为什么呢?
我们知道,代码需要经过 预编译——编译——汇编——链接几个阶段才能生成可执行文件;
而c++正是在这之中动了手脚;
它在编译的时候,会根据函数名称,形参个数,形参类型以及不同环境下的名字修饰规则,生成不同的函数名,随后编译器链接的时候,就会到对应的地址使用对应的函数了;
因此就能够实现函数重载;
函数重载规则
1.函数形参个数要不同;
2.函数形参类型要不同;
3.函数形参顺序要不同;
缺省函数
c++中,我们的函数可以不给值,而在函数中直接给值;

就像这样;
缺省函数又分为全缺省和半缺省;
上图就是全缺省,即所有参数都有值;
接下来就是半缺省;

半缺省就是有的值有初始值,有的没有;
那么缺省函数有什么需要注意的呢?
那是当然有的;
1. 半缺省参数必须 从右往左依次 来给出,不能间隔着给2. 缺省参数不能在函数声明和定义中同时出现(若是两边缺省值不同会错误)3. 缺省值必须是全局变量或者常量只有注意了以上几点,才能够正确的使用缺省函数,还请注意;

内联函数
在讲这个之前,请大家回忆一下,大家还记得宏函数是什么吗?
宏函数在使用的时候,编译器会直接将函数内部的代码直接替换掉宏所在位置;
没有栈帧的消耗;
而内联函数也是类似的;
用inline修饰的函数,会在函数调用的位置展开,没有栈帧消耗,提升程序运行效率
接下来我们直接看看内联函数是怎么用的吧;

那么内联函数和普通的函数有什么不同呢?
这就要去看看底层代码了;
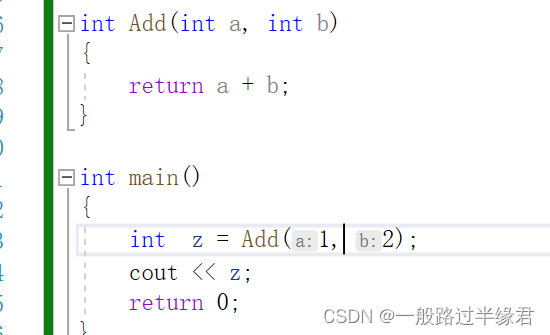

我们先看看普通函数的底层代码,发现Add前面有一个call指令,也就是调用Add函数的指令;
我们再来看看内联函数的底层代码;

我们发现,此处并没有call指令,而是直接利用 eax寄存器将数据放到函数内部;
这就是内联函数的作用;
内联函数的特点
1.内联函数是一种以空间换时间的做法,虽然会增大程序的大小,但是会减少程序运行时间;
2.内联对编译器只是一个建议,不同编译器的要求不同,一般建议是函数体较小,不用递归且使用频繁的函数才使用内联;
3.内联函数的声明和定义不能分离,若是分离函数的链接可能会出错,因为inline函数被展开了,没有函数地址,链接时会出错;
之前用宏来引入内联函数,那么内联函数和宏有什么不同呢?
宏:
优点:
1.增加代码复用性
2.增加效率
缺点:
1.没有类型安全检查;
2.代码可读性差;
3.容易出错;
4.不可调试
内联函数:
优点:
1.增加代码复用性;
2.增加效率;
3.有类型安全检查;
4.可读性好;
5.可以调试;
缺点:
1.不可递归;
2.声明和定义不可分离
不过有一点需要注意,内联函数其实只是一个建议,并不代表编译器一定会执行;
比如有的编译器,你的代码超过20行或者30行,inline关键字就会被忽略。
关键字auto
在c++中还有这样一个关键字:auto;
那么auto是干什么的呢?
用于将那些类型名特别长容易写错的类型推导出来;
auto是一个类型指示器来指示编译器,并且 auto 声明的变量必须在编译时期推导出来;
那么auto怎么用呢?
int a;
auto b = a;
auto c = 'a';
这样,就声明了int类型的b变量,char类型的c变量;
但是auto虽然好用,但是也有很多限制;
auto的限制:
1.auto定义变量必须初始化;
2.auto不能作为函数的参数;
3.auto不可直接声明数组;
4.auto用来引用别的变量时,必须写auto&,而auto指针则没必要加*;
5.在一行定义多个auto变量,必须类型的都一样;
实例
- int main()
- {
- int a = 10;
- auto b = a, c = 10;
- auto& ra = a;
- auto d = &a;
- auto* e = &a;
- return 0;
- }
运行这样就是auto的使用方法了;
范围for循环
c++中有一个范围的or循环,可以直接来循环遍历数组内部的所有元素;
使用方法:
- void TestFor()
- {
- int array[] = { 1, 2, 3, 4, 5 };
- for(auto& e : array)
- e *= 2;
- for(auto e : array)
- cout << e << " ";
- return 0;
- }
- int main()
- {
- TestFor();
- return 0;
- }

我们可以看到,我们不仅可以访问内部的数据,也可以改变内部的数据;
c++的nullptr
在c++中,NULL并不是所谓的空指针;
实际上c++中的NULL是数据0;
nullptr才是空指针;
这点需要注意;
总结
c++针对C语言的一些缺陷或者说不好用的地方都提出了新的语法,比如难以理解的引用,以及函数重载等技术,都说明C++是C语言的升级,而且C++语言包含C语言的语法,可以直接使用C语言的语法,这点需要点个赞。

-
相关阅读:
基于SSM的失物招领信息交互平台
大学生简单环保环境静态HTML网页设计作品 DIV布局环境介绍网页模板代码 DW学生环境网站制作成品下载 HTML5期末大作业
订单。。。
docker安装tomcat8
算法排序之冒泡排序及优化
ThreadLocal你真的用不上吗?
计算机毕业设计选题推荐-教师薪酬管理系统-Java项目实战
Android SystemServer进程解析
《痞子衡嵌入式半月刊》 第 91 期
Git提交代码.gitignore的模版
- 原文地址:https://blog.csdn.net/m0_64028711/article/details/127087091
- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读