-
<哈希及模拟实现>——《C++高阶》
目录
后记:●由于作者水平有限,文章难免存在谬误之处,敬请读者斧正,俚语成篇,恳望指教!
一、知识回顾:
1.暴力查找---时间复杂度:O(N)
2.二分查找---时间复杂度:O(logN)缺点:有序、数组结构
3.搜索二叉树---时间复杂度:O(N) 缺点:极端场景,退化单支
4.平衡二叉搜索树---时间复杂度:O(logN)
- AVLTree:左右子树高度差不超过1
- 红黑树:最长路径不超过最短路径的2倍
两者相比而言,AVL树是通过多次旋转保持均衡,红黑树的高度会比AVL树高,但旋转更少,尽管红黑树没有AVL树均衡(可能会长的长,短的短),但高度和AVL树是一个数量级,这些对于现代计算机CPU而言,差别可以忽略。因此红黑树是近似平衡,应用广泛。
二、哈希及哈希结构:
1. unordered系列关联式容器
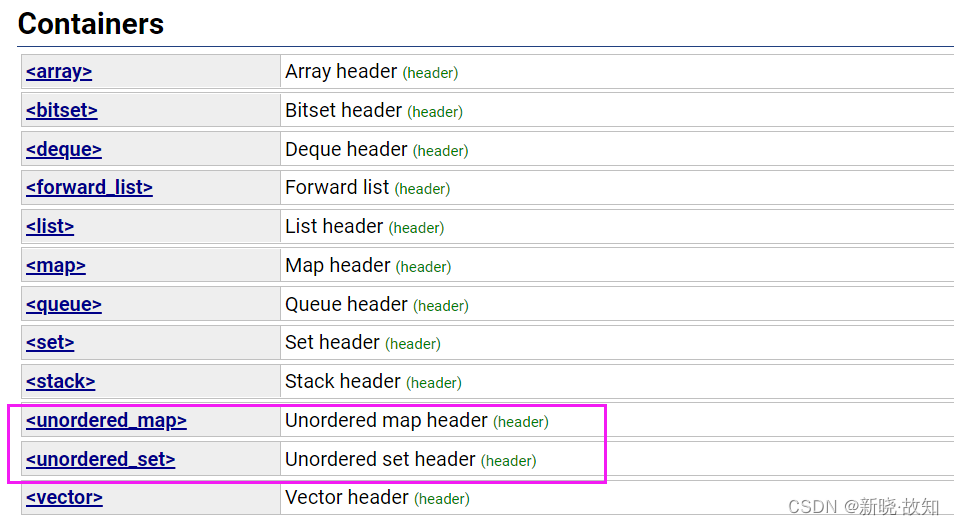
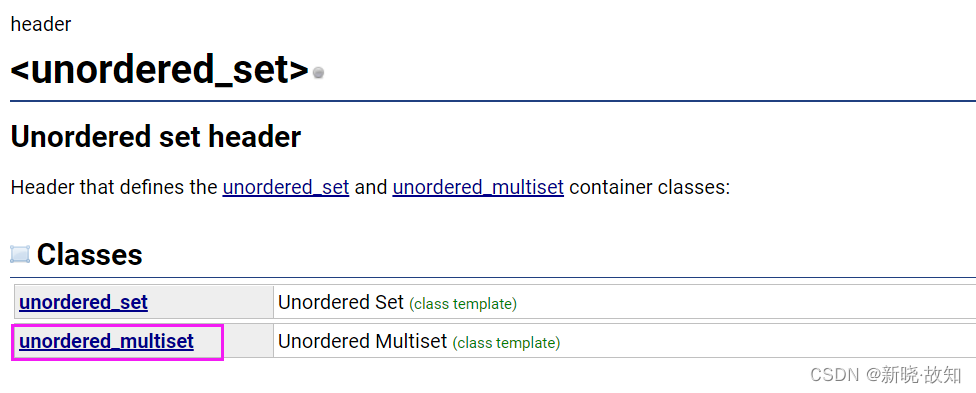
在C++98中,STL提供了底层为红黑树结构的一系列关联式容器,在查询时效率可达到logN,即最差情况下需要比较红黑树的高度次,当树中的节点非常多时,查询效率也不理想。最好的查询是,进行很少的比较次数就能够将元素找到,因此在C++11中,STL又提供了4个unordered系列的关联式容器,这四个容器与红黑树结构的关联式容器使用方式基本类似,只是其底层结构不同,本文中只对unordered_map和unordered_set进行介绍,
unordered_multimap和unordered_multiset具体可查看文档介绍。
unordered_multimap文档链接:unordered_map - C++ Reference
1.1 unordered_map
1.1.1 unordered_map的文档介绍
unordered_map在线文档说明:
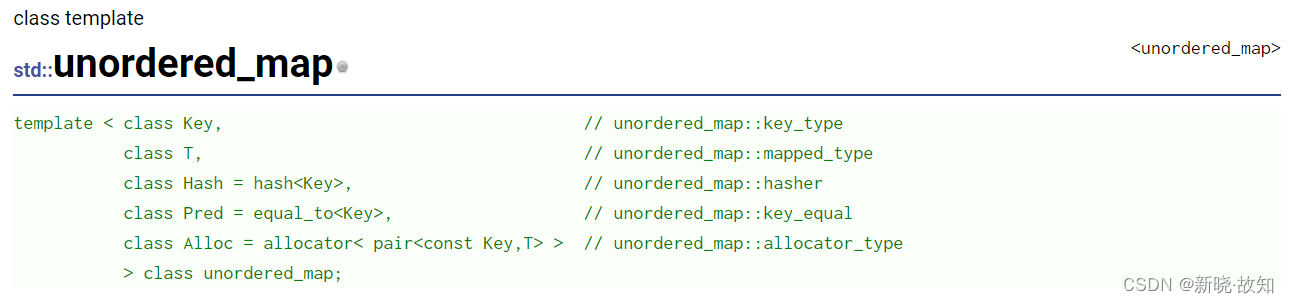
1. unordered_map是存储
2. 在unordered_map中,键值通常用于惟一地标识元素,而映射值是一个对象,其内容与此
键关联。键和映射值的类型可能不同。
3. 在内部,unordered_map没有对
4. unordered_map容器通过key访问单个元素要比map快,但它通常在遍历元素子集的范围迭代方面效率较低。
5. unordered_maps实现了直接访问操作符(operator[]),它允许使用key作为参数直接访问
value。
6. 它的迭代器至少是前向迭代器。
1.1.2 unordered_map的接口说明
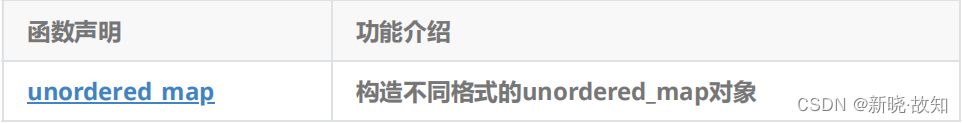
1. unordered_map的构造
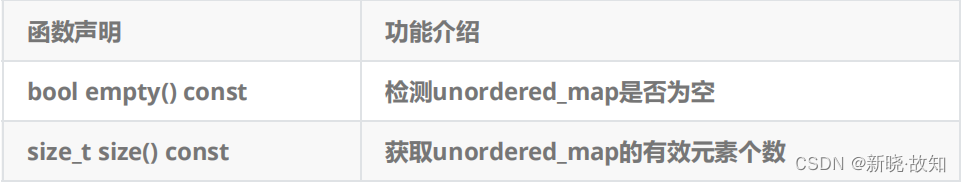
2. unordered_map的容量
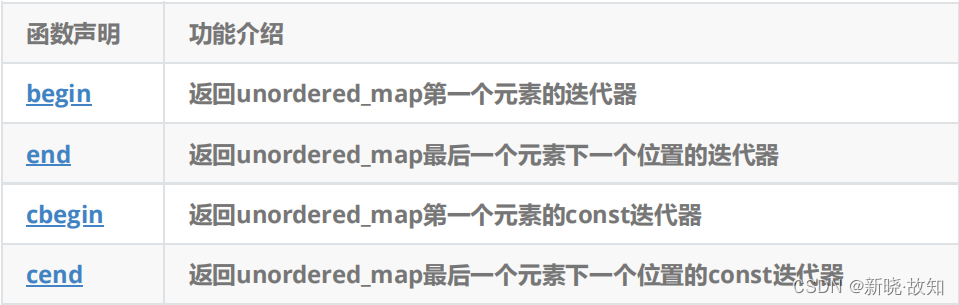
3. unordered_map的迭代器
4. unordered_map的元素访问
函数声明 功能介绍 operator[] 返回与key对应的value,没有一个默认值 注意:该函数中实际调用哈希桶的插入操作,用参数key与V()构造一个默认值往底层哈希桶
中插入,如果key不在哈希桶中,插入成功,返回V(),插入失败,说明key已经在哈希桶中,
将key对应的value返回。
5. unordered_map的查询
函数声明
功能介绍 iterator fifind(const K& key)
返回key在哈希桶中的位置
size_t count(const K& key)
返回哈希桶中关键码为key的键值对的个数
注意:unordered_map中key是不能重复的,因此count函数的返回值最大为1
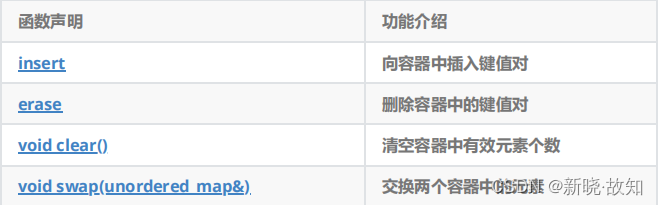
6. unordered_map的修改操作
7. unordered_map的桶操作

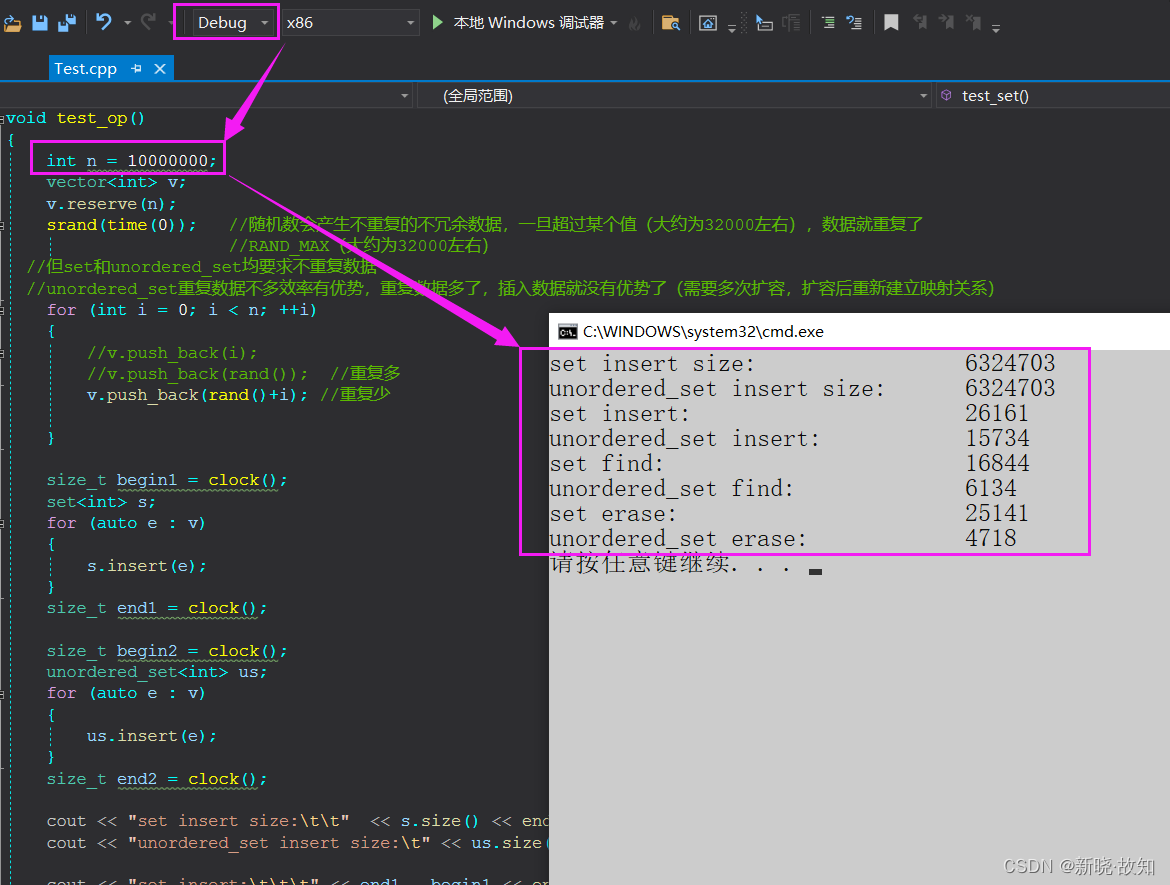
对比set和unorded_set的效率:
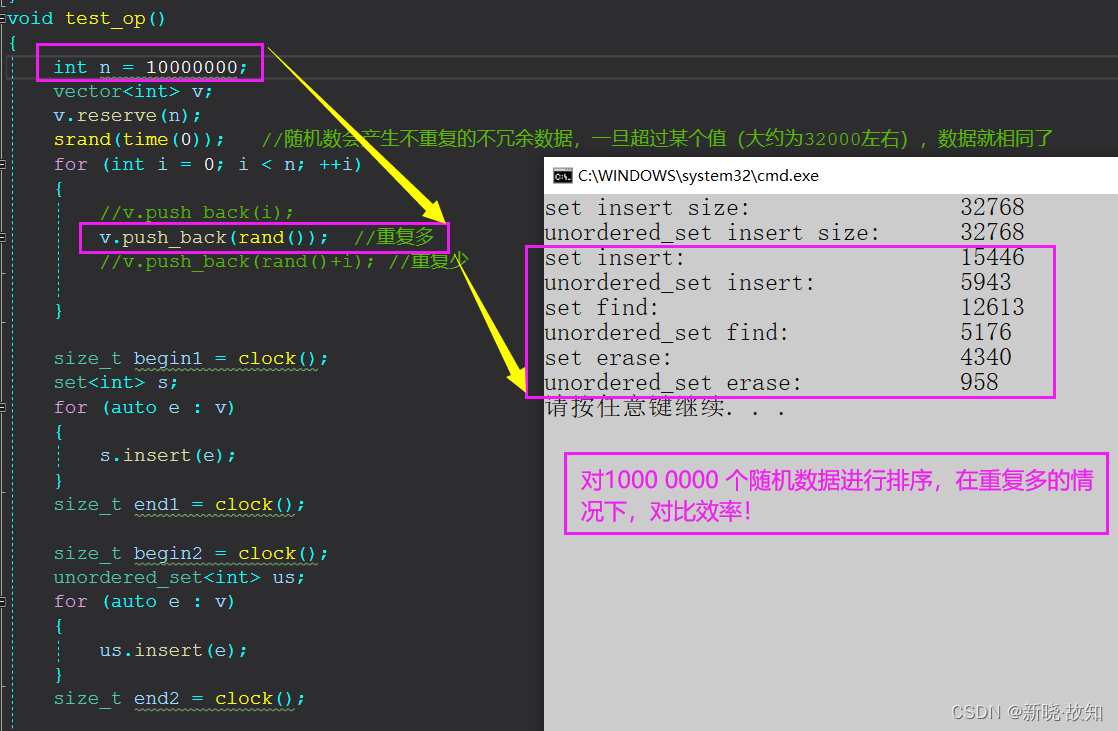
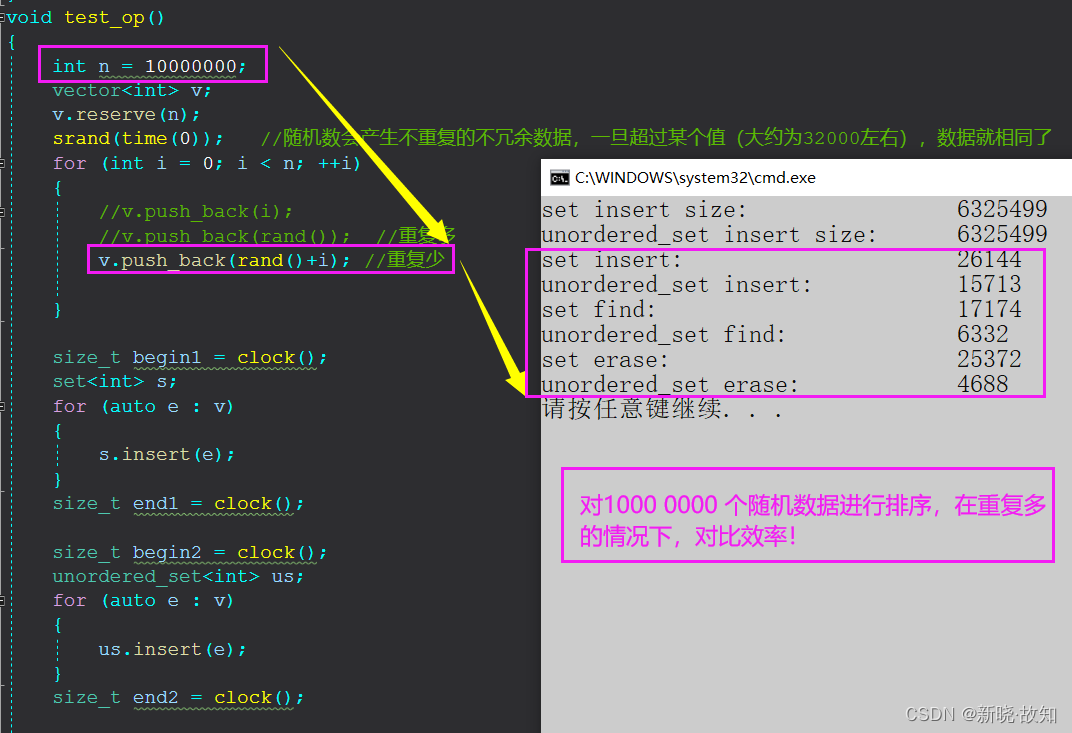
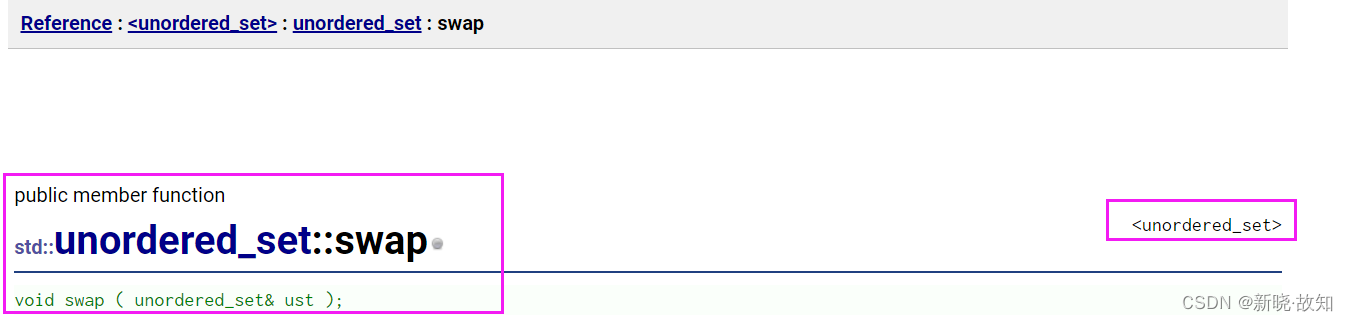
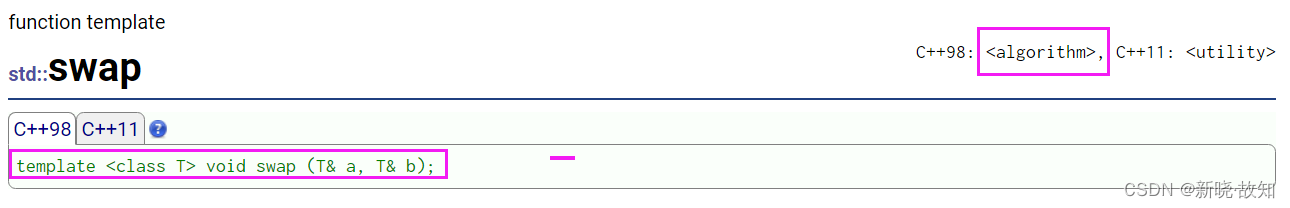
每个容器都自身提供swap成员函数,算法库也有swap,它们的区别是什么?
s1.swap(s2); 效率高,交换底层结构,比如树:交换根结点指针
swap(s1,s2); 效率低,利用第三个对象,深拷贝交换。
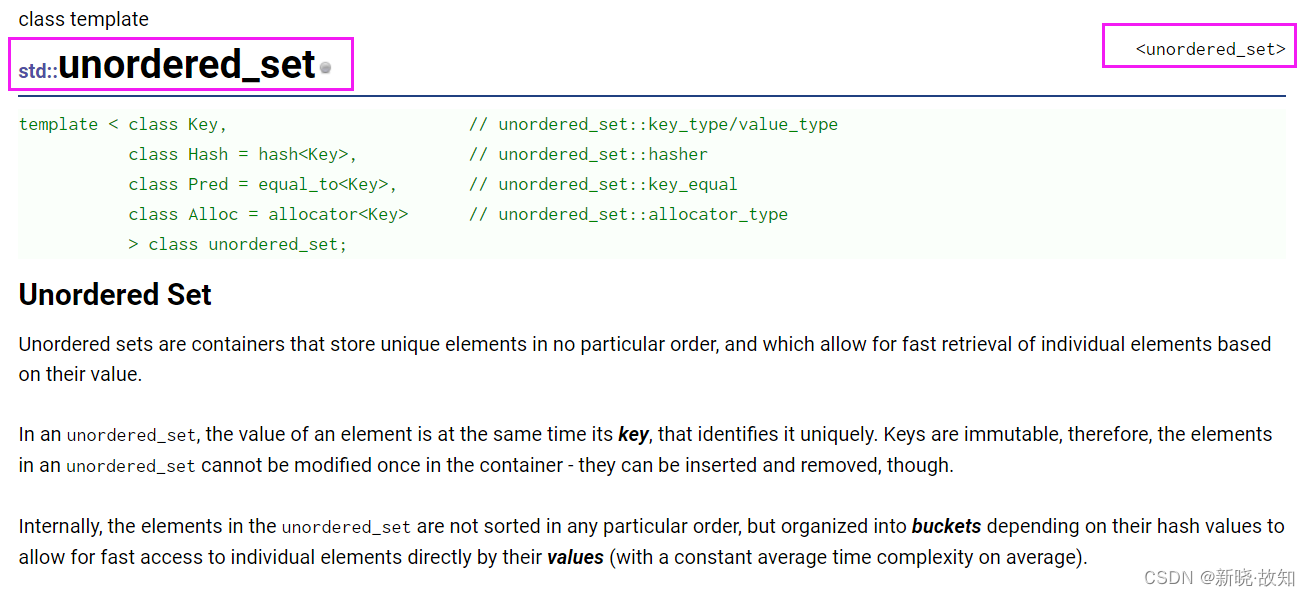
1.2 unordered_set
参见 unordered_set在线文档说明
unordered_set链接:unordered_set - C++ Reference
1.3 OJ试题:
重复n次的元素:
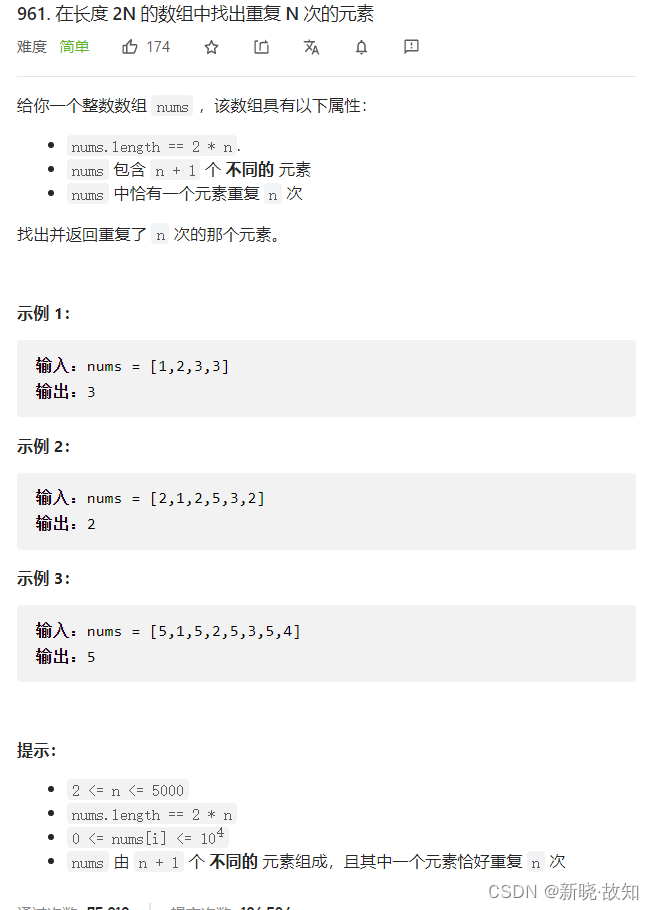
- class Solution
- {
- public:
- int repeatedNTimes(vector<int>& A)
- {
- size_t N = A.size() / 2;
- // 用unordered_map统计每个元素出现的次数
- unordered_map<int, int> m;
- for (auto e : A)
- m[e]++;
- // 找出出现次数为N的元素
- for (auto& e : m)
- {
- if (e.second == N)
- return e.first;
- }
- }
- };
两个数组的交集:
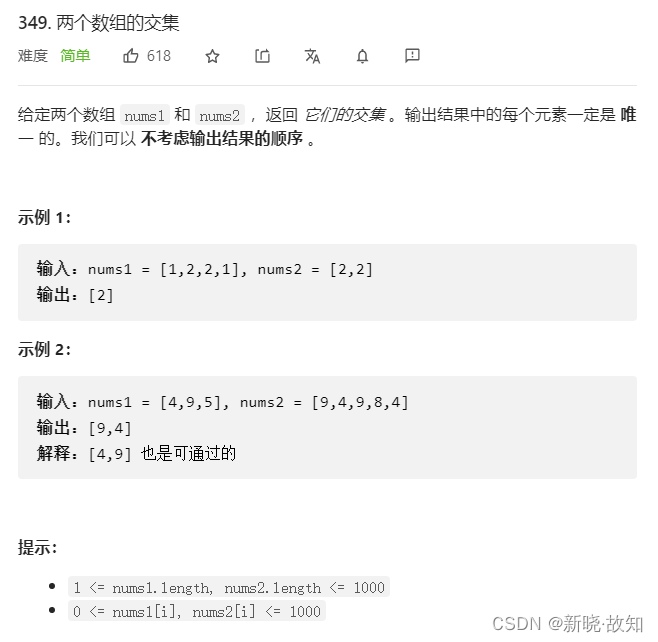
- class Solution
- {
- public:
- vector<int> intersection(vector<int>& nums1, vector<int>& nums2)
- {
- // 用unordered_set对nums1中的元素去重
- unordered_set<int> s1;
- for (auto e : nums1)
- s1.insert(e);
- // 用unordered_set对nums2中的元素去重
- unordered_set<int> s2;
- for (auto e : nums2)
- s2.insert(e);
- // 遍历s1,如果s1中某个元素在s2中出现过,即为交集
- vector<int> vRet;
- for (auto e : s1)
- {
- if (s2.find(e) != s2.end())
- vRet.push_back(e);
- }
- return vRet;
- }
- };
2. 底层结构:
unordered系列的关联式容器之所以效率比较高,是因为其底层使用了哈希结构。
2.1 哈希概念
顺序结构以及平衡树中,元素关键码与其存储位置之间没有对应的关系,因此在查找一个元素时,必须要经过关键码的多次比较。顺序查找时间复杂度为O(N),平衡树中为树的高度,即 O(logN),搜索的效率取决于搜索过程中元素的比较次数。
理想的搜索方法:可以不经过任何比较,一次直接从表中得到要搜索的元素。
如果构造一种存储结构,通过某种函数(hashFunc)使元素的存储位置与它的关键码之间能够建立一一映射的关系,那么在查找时通过该函数可以很快找到该元素。
当向该结构中:
插入元素
根据待插入元素的关键码,以此函数计算出该元素的存储位置并按此位置进行存放
搜索元素
对元素的关键码进行同样的计算,把求得的函数值当做元素的存储位置,在结构中按此位置
取元素比较,若关键码相等,则搜索成功
该方式即为哈希(散列)方法,哈希方法中使用的转换函数称为哈希(散列)函数,构造出来的结构称为哈希表(Hash Table)(或者称散列表)
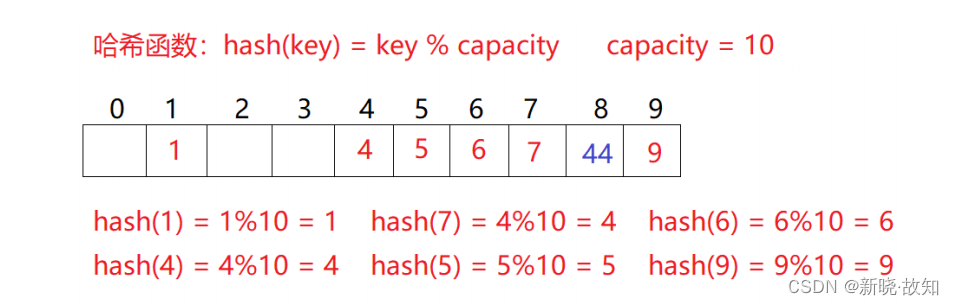
例如:数据集合{1,7,6,4,5,9};
哈希函数设置为:hash(key) = key % capacity; capacity为存储元素底层空间总的大小。
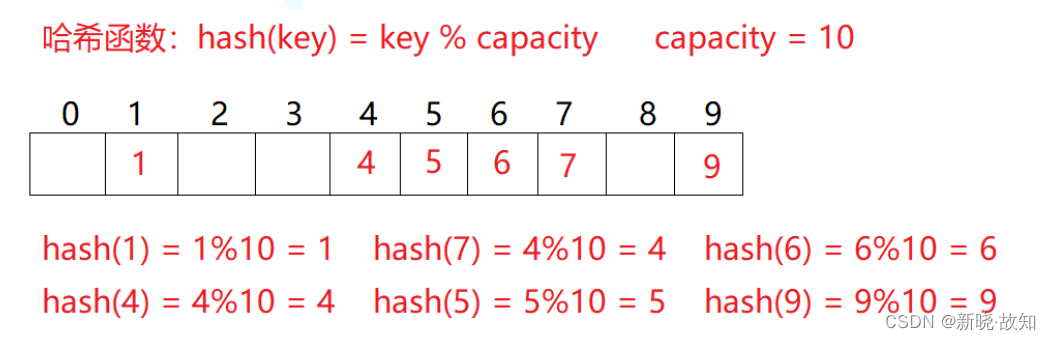
用该方法进行搜索不必进行多次关键码的比较,因此搜索的速度比较快
问题:按照上述哈希方式,向集合中插入元素44,会出现什么问题?
2.2 哈希冲突
对于两个数据元素的关键字ki和 kj(i != j),有ki != kj,但有:Hash(ki) == Hash(kj),即:不同关键字通过相同哈希哈数计算出相同的哈希地址,该种现象称为哈希冲突或哈希碰撞。
把具有不同关键码而具有相同哈希地址的数据元素称为“同义词”。
发生哈希冲突该如何处理呢?
2.3 哈希函数
引起哈希冲突的一个原因可能是:哈希函数设计不够合理。
哈希函数设计原则:
哈希函数的定义域必须包括需要存储的全部关键码,而如果散列表允许有m个地址时,其值
域必须在0到m-1之间
哈希函数计算出来的地址能均匀分布在整个空间中
哈希函数应该比较简单
直接建立映射关系问题:
1.若数据范围分布很广,不集中怎么办?
2.key的数据不是整数,是字符串怎么办?是自定义类型对象怎么办?
常见哈希函数
1. 直接定址法--(常用)
取关键字的某个线性函数为散列地址:Hash(Key)= A*Key + B
优点:简单、均匀
缺点:需要事先知道关键字的分布情况
使用场景:适合查找比较小且连续的情况
面试题:字符串中第一个只出现一次字符
2. 除留余数法--(常用)
设散列表中允许的地址数为m,取一个不大于m,但最接近或者等于m的质数p作为除数,
按照哈希函数:Hash(key) = key% p(p<=m),将关键码转换成哈希地址
3. 平方取中法--(了解)
假设关键字为1234,对它平方就是1522756,抽取中间的3位227作为哈希地址;
再比如关键字为4321,对它平方就是18671041,抽取中间的3位671(或710)作为哈希地址
平方取中法比较适合:不知道关键字的分布,而位数又不是很大的情况
4. 折叠法--(了解)
折叠法是将关键字从左到右分割成位数相等的几部分(最后一部分位数可以短些),然后将这
几部分叠加求和,并按散列表表长,取后几位作为散列地址。
折叠法适合事先不需要知道关键字的分布,适合关键字位数比较多的情况
5. 随机数法--(了解)
选择一个随机函数,取关键字的随机函数值为它的哈希地址,即H(key) = random(key),其中
random为随机数函数。
通常应用于关键字长度不等时采用此法
6. 数学分析法--(了解)
设有n个d位数,每一位可能有r种不同的符号,这r种不同的符号在各位上出现的频率不一定
相同,可能在某些位上分布比较均匀,每种符号出现的机会均等,在某些位上分布不均匀只
有某几种符号经常出现。可根据散列表的大小,选择其中各种符号分布均匀的若干位作为散
列地址。例如:假设要存储某家公司员工登记表,如果用手机号作为关键字,那么极有可能前7位都是 相同
的,那么我们可以选择后面的四位作为散列地址,如果这样的抽取工作还容易出现 冲突,还
可以对抽取出来的数字进行反转(如1234改成4321)、右环位移(如1234改成4123)、左环移
位、前两数与后两数叠加(如1234改成12+34=46)等方法。
数字分析法通常适合处理关键字位数比较大的情况,如果事先知道关键字的分布且关键字的
若干位分布较均匀的情况
注意:哈希函数设计的越精妙,产生哈希冲突的可能性就越低,但是无法避免哈希冲突
2.4 哈希冲突解决
解决哈希冲突两种常见的方法是:闭散列和开散列
2.4.1 闭散列
闭散列:也叫开放定址法,当发生哈希冲突时,如果哈希表未被装满,说明在哈希表中必然还有空位置,那么可以把key存放到冲突位置中的“下一个” 空位置中去。那如何寻找下一个空位置呢?
1. 线性探测
比如2.1中的场景,现在需要插入元素44,先通过哈希函数计算哈希地址,hashAddr为4,
因此44理论上应该插在该位置,但是该位置已经放了值为4的元素,即发生哈希冲突。
线性探测:从发生冲突的位置开始,依次向后探测,直到寻找到下一个空位置为止。
插入通过哈希函数获取待插入元素在哈希表中的位置
如果该位置中没有元素则直接插入新元素,如果该位置中有元素发生哈希冲突,
使用线性探测找到下一个空位置,插入新元素
删除
采用闭散列处理哈希冲突时,不能随便物理删除哈希表中已有的元素,若直接删除元素
会影响其他元素的搜索。比如删除元素4,如果直接删除掉,44查找起来可能会受影
响。因此线性探测采用标记的伪删除法来删除一个元素。
- // 哈希表每个空间给个标记
- // EMPTY此位置空, EXIST此位置已经有元素, DELETE元素已经删除
- enum State{EMPTY, EXIST, DELETE};
线性探测的实现
- // 注意:假如实现的哈希表中元素唯一,即key相同的元素不再进行插入
- // 为了实现简单,此哈希表中我们将比较直接与元素绑定在一起
- template<class K, class V>
- class HashTable
- {
- struct Elem
- {
- pair
- State _state;
- };
- public:
- HashTable(size_t capacity = 3)
- : _ht(capacity), _size(0)
- {
- for(size_t i = 0; i < capacity; ++i)
- _ht[i]._state = EMPTY;
- }
- bool Insert(const pair
- {
- // 检测哈希表底层空间是否充足
- // _CheckCapacity();
- size_t hashAddr = HashFunc(key);
- // size_t startAddr = hashAddr;
- while(_ht[hashAddr]._state != EMPTY)
- {
- if(_ht[hashAddr]._state == EXIST && _ht[hashAddr]._val.first
- == key)
- return false;
- hashAddr++;
- if(hashAddr == _ht.capacity())
- hashAddr = 0;
- /*
- // 转一圈也没有找到,注意:动态哈希表,该种情况可以不用考虑,哈希表中元
- 素个数到达一定的数量,哈希冲突概率会增大,需要扩容来降低哈希冲突,因此哈希表中元素是
- 不会存满的
- if(hashAddr == startAddr)
- return false;
- */
- }
- // 插入元素
- _ht[hashAddr]._state = EXIST;
- _ht[hashAddr]._val = val;
- _size++;
- return true;
- }
- int Find(const K& key)
- {
- size_t hashAddr = HashFunc(key);
- while(_ht[hashAddr]._state != EMPTY)
- {
- if(_ht[hashAddr]._state == EXIST && _ht[hashAddr]._val.first
- == key)
- return hashAddr;
- hashAddr++;
- }
- return hashAddr;
- }
- bool Erase(const K& key)
- {
- int index = Find(key);
- if(-1 != index)
- {
- _ht[index]._state = DELETE;
- _size++;
- return true;
- }
- return false;
- }
- size_t Size()const;
- bool Empty() const;
- void Swap(HashTable
- private:
- size_t HashFunc(const K& key)
- {
- return key % _ht.capacity();
- }
- private:
- vector
_ht; - size_t _size;
- };
思考:哈希表什么情况下进行扩容?如何扩容?
- void CheckCapacity()
- {
- if(_size * 10 / _ht.capacity() >= 7)
- {
- HashTable
- for(size_t i = 0; i < _ht.capacity(); ++i)
- {
- if(_ht[i]._state == EXIST)
- newHt.Insert(_ht[i]._val);
- }
- Swap(newHt);
- }
- }
线性探测优点:实现非常简单,
线性探测缺点:一旦发生哈希冲突,所有的冲突连在一起,容易产生数据“堆积”,即:不同
关键码占据了可利用的空位置,使得寻找某关键码的位置需要许多次比较,导致搜索效率降
低。如何缓解呢?
2. 二次探测
线性探测的缺陷是产生冲突的数据堆积在一块,这与其找下一个空位置有关系,因为找空位
置的方式就是挨着往后逐个去找,因此二次探测为了避免该问题,找下一个空位置的方法
为:Hi= (H0 + i^2)% m, 或者:H_i= (H0 - i^2 )% m。其中:i =
1,2,3…, H_0是通过散列函数Hash(x)对元素的关键码 key 进行计算得到的位置,m是表
的大小。
对于2.1中如果要插入44,产生冲突,使用解决后的情况为:研究表明:当表的长度为质数且表装载因子a不超过0.5时,新的表项一定能够插入,而且任
何一个位置都不会被探查两次。因此只要表中有一半的空位置,就不会存在表满的问题。在
搜索时可以不考虑表装满的情况,但在插入时必须确保表的装载因子a不超过0.5,如果超出
必须考虑增容。
因此:比散列最大的缺陷就是空间利用率比较低,这也是哈希的缺陷。
二次探测是跳跃着去找空位置
哈希处理调试:
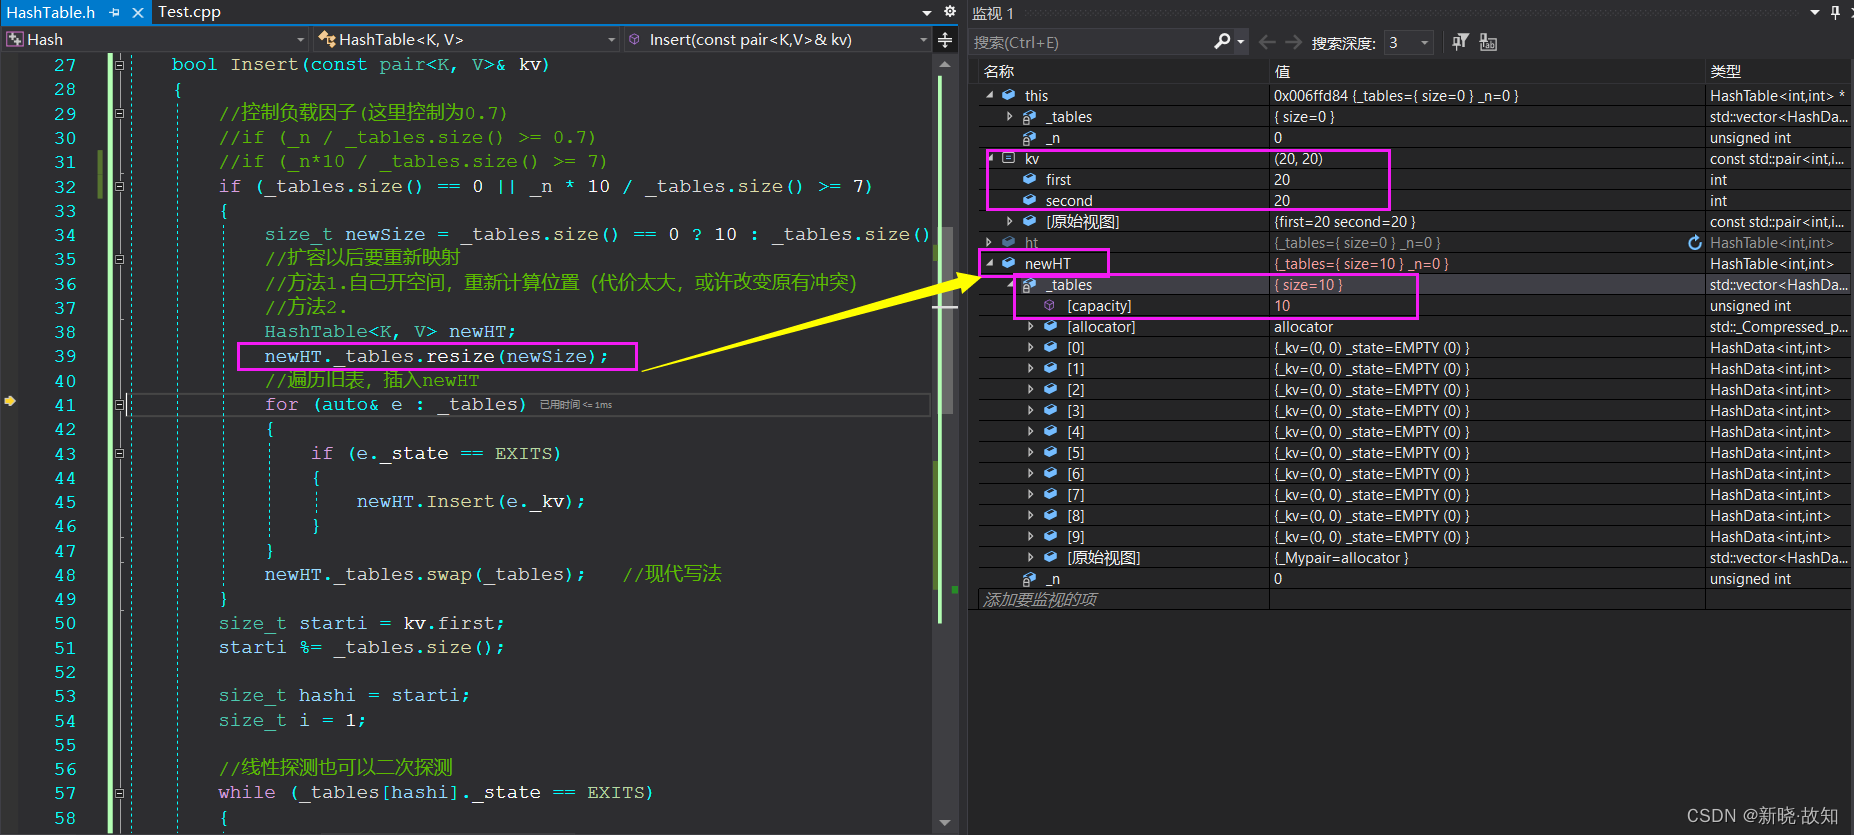
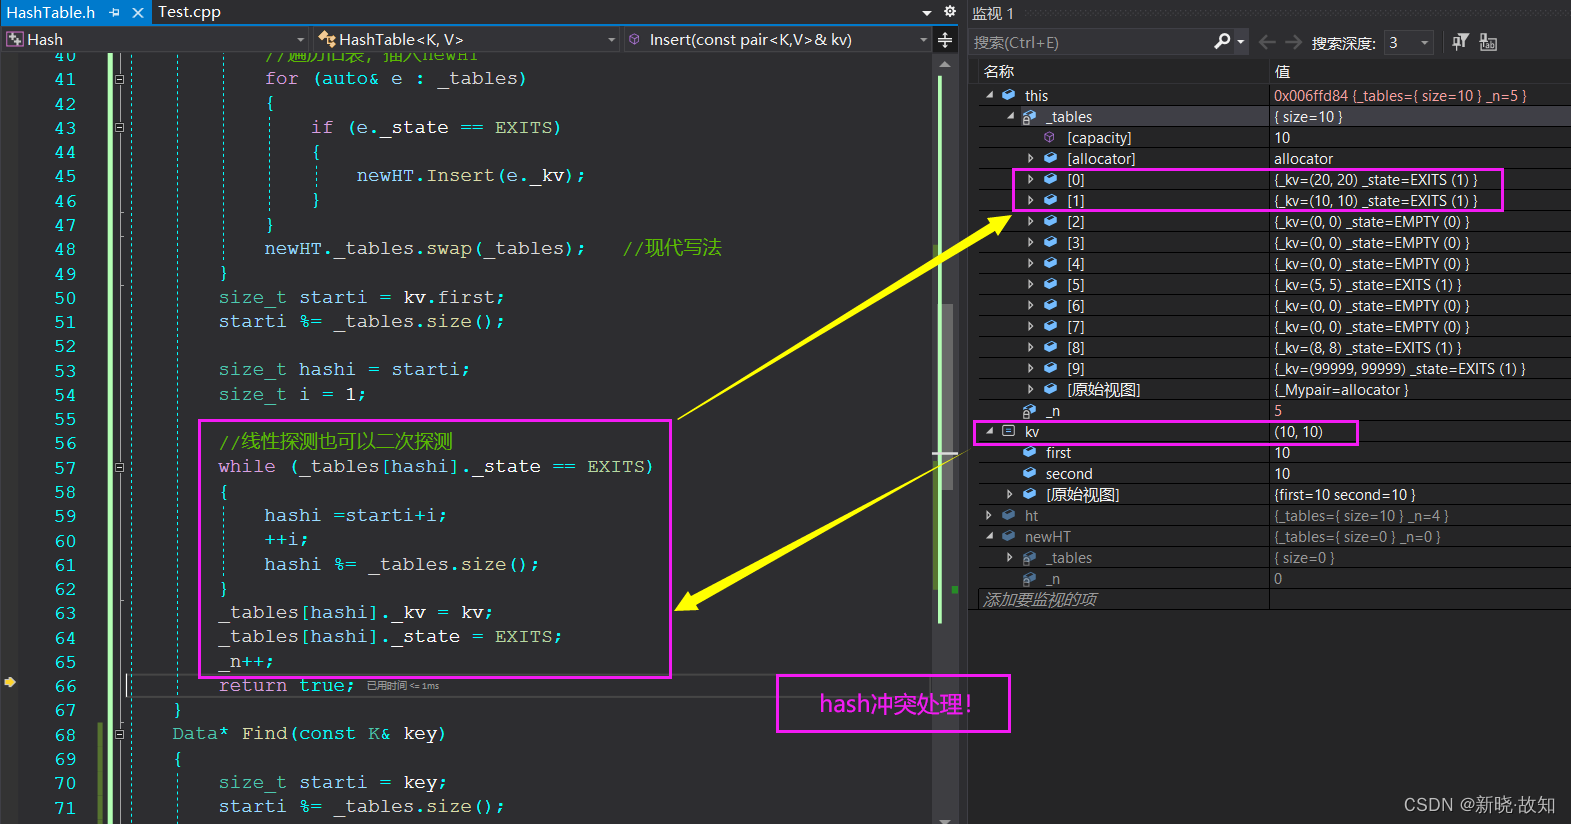
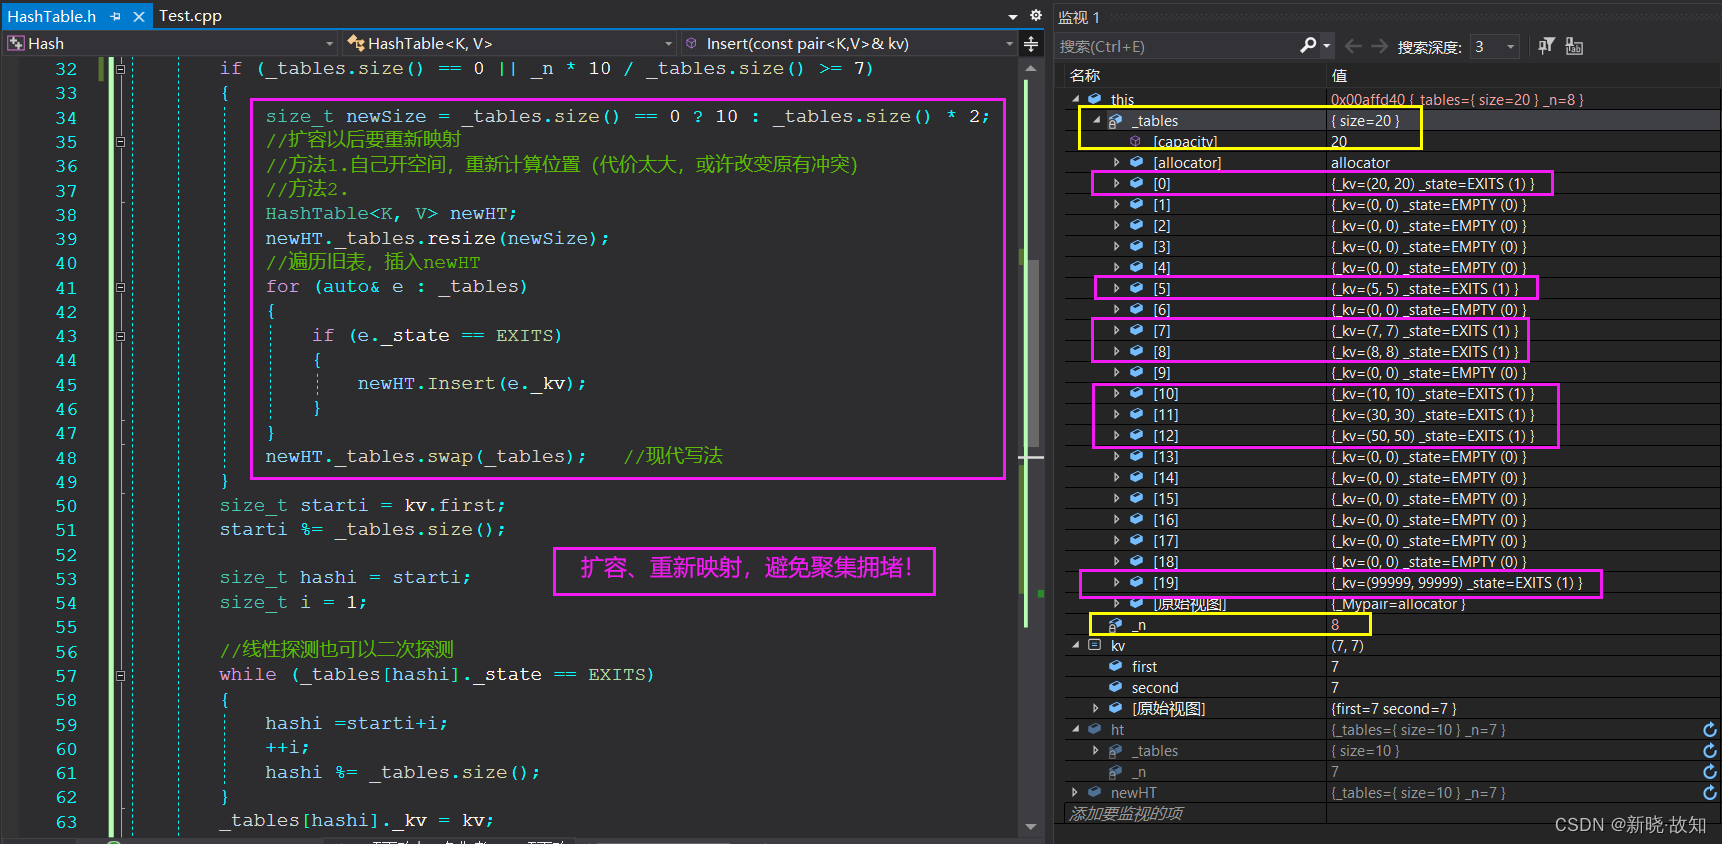
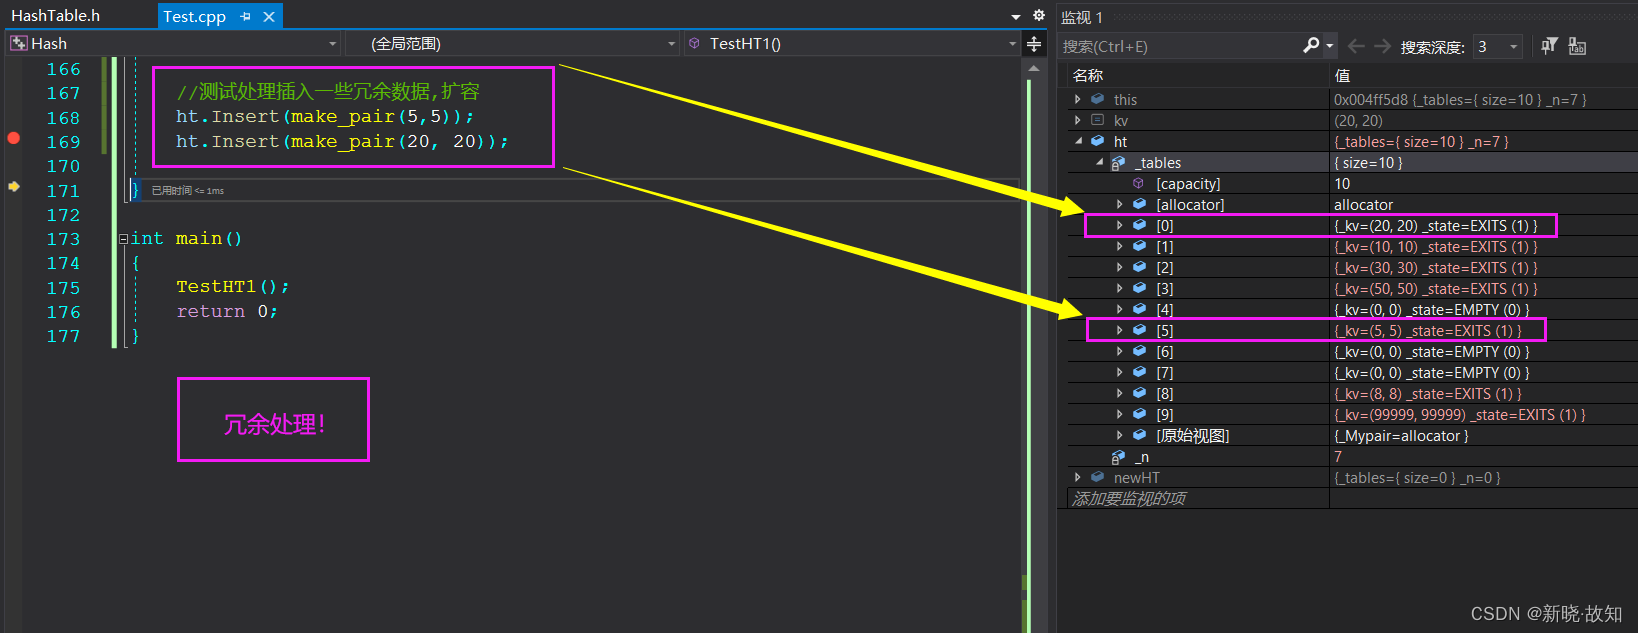
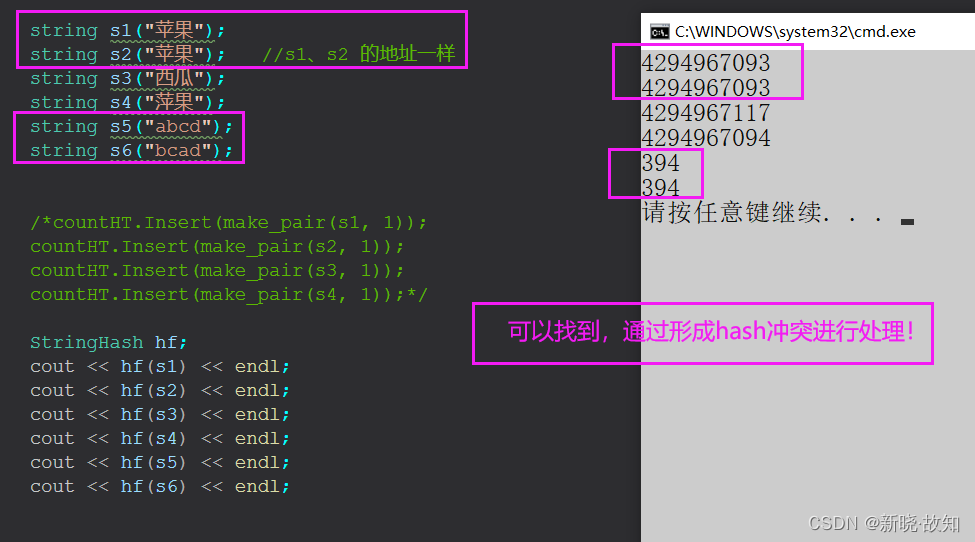
当key为整数时: key% --->映射
当key为字符串时:字符串--->整数---> 整数%
当key为其他类型时,通过转换到整数,再进行hash映射
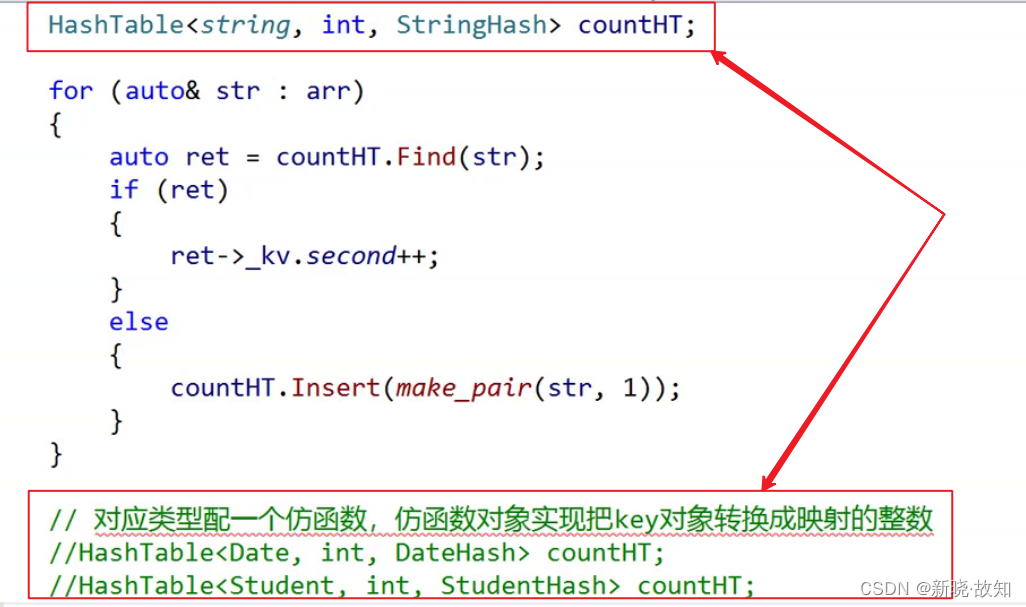
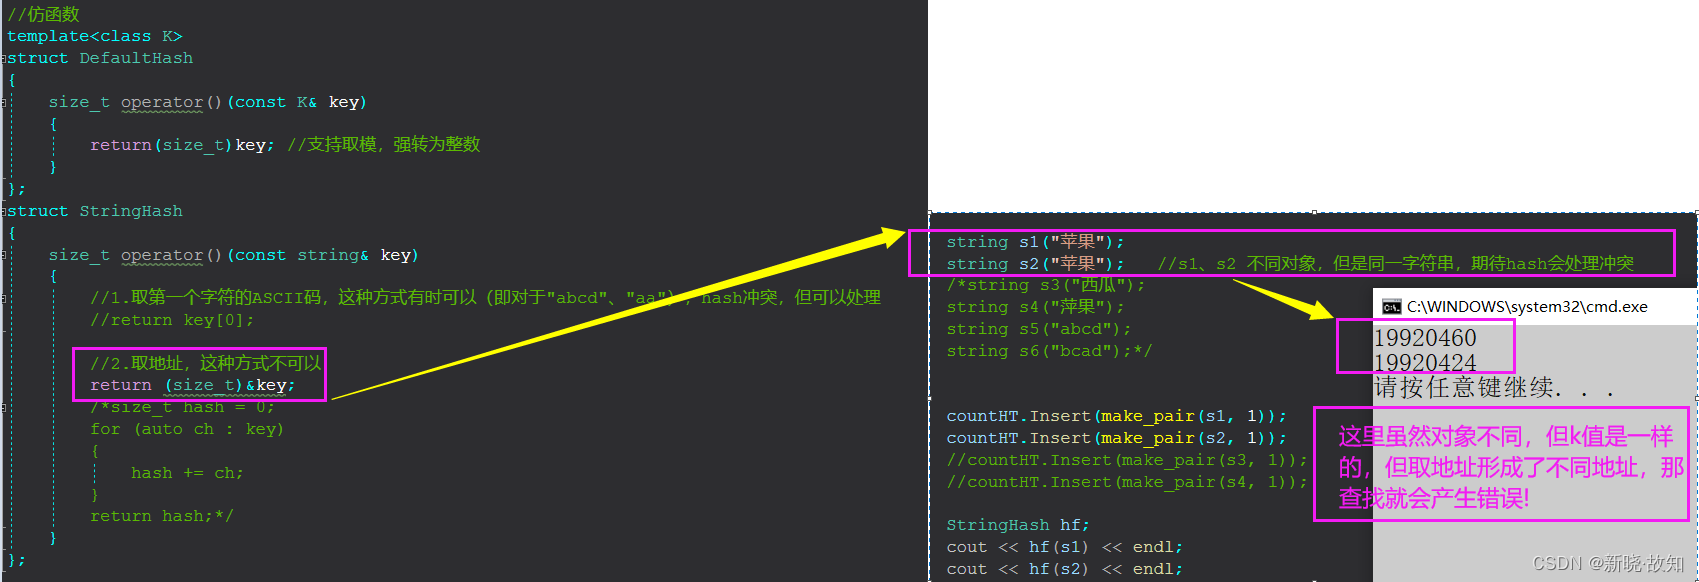
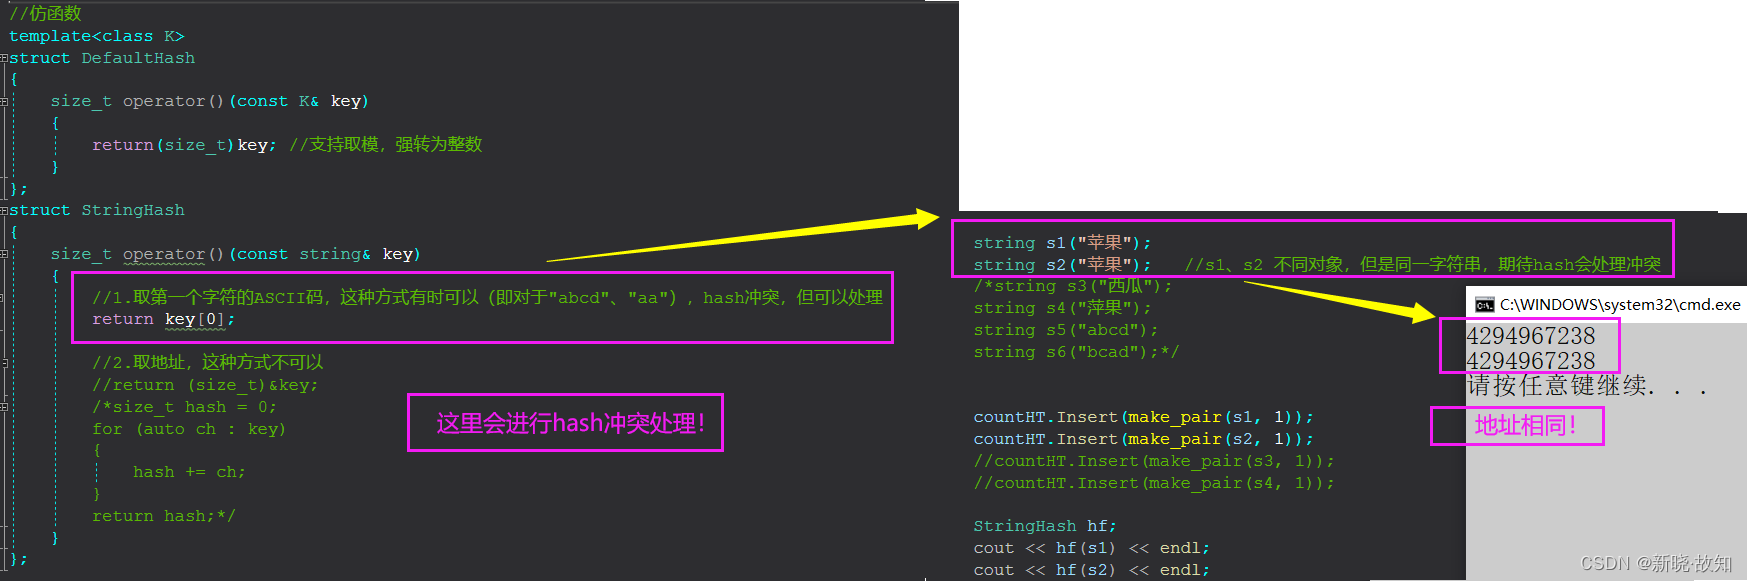
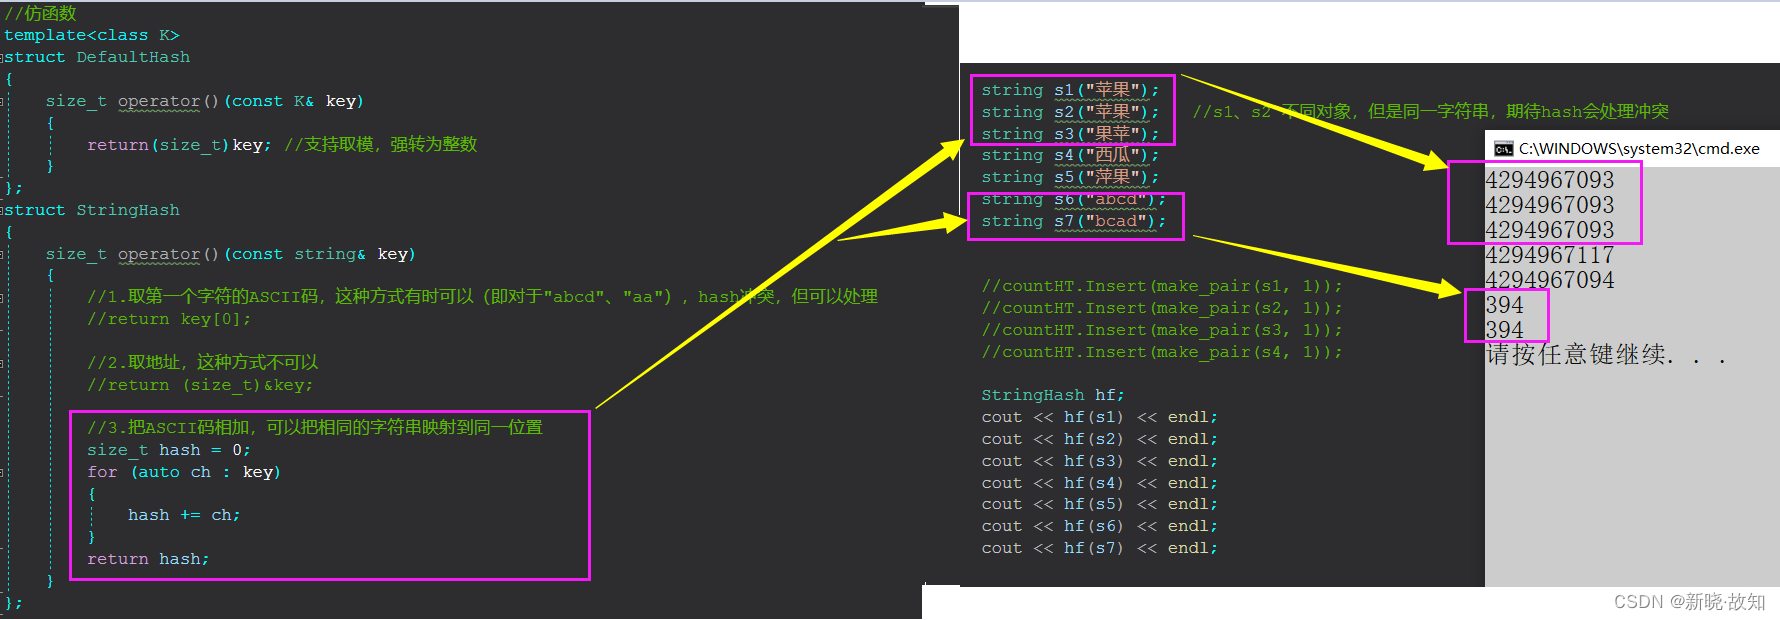
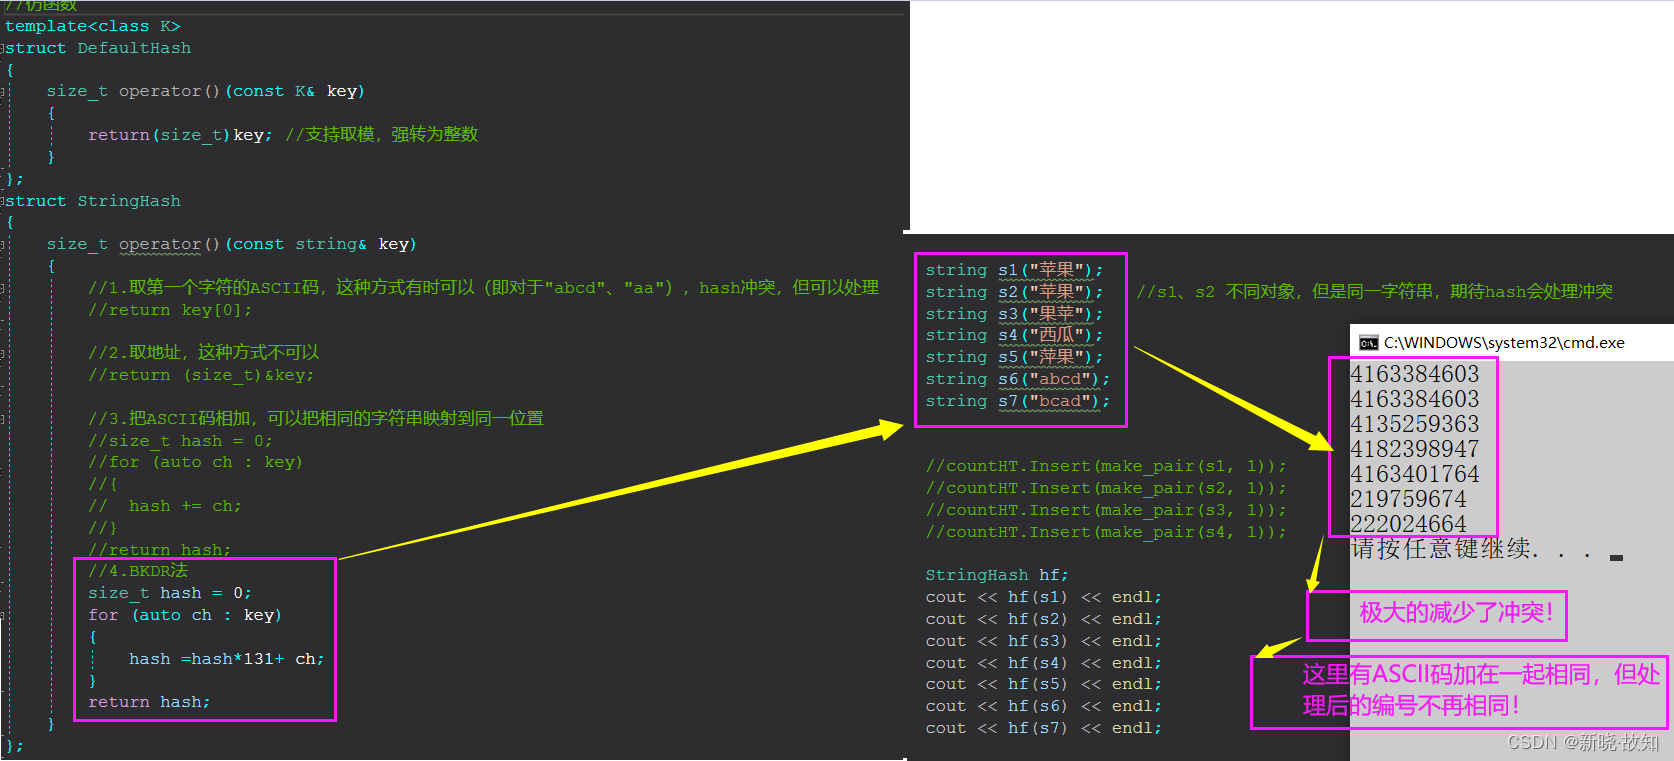
字符串哈希算法链接:各种字符串Hash函数
2.4.2 开散列
1. 开散列概念
开散列法又叫链地址法(开链法),首先对关键码集合用散列函数计算散列地址,具有相同地
址的关键码归于同一子集合,每一个子集合称为一个桶,各个桶中的元素通过一个单链表链
接起来,各链表的头结点存储在哈希表中。
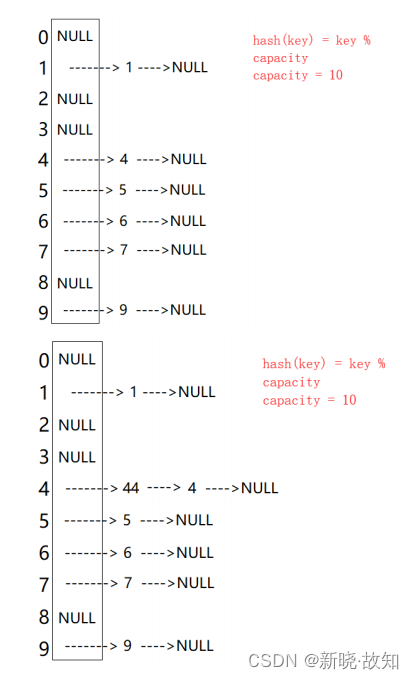
从上图可以看出,开散列中每个桶中放的都是发生哈希冲突的元素。
又称为哈希桶,数据不存在表中,表里面存储一个链表指针,冲突的数据链表形式挂起来
2. 开散列实现
- template<class V>
- struct HashBucketNode
- {
- HashBucketNode(const V& data)
- : _pNext(nullptr), _data(data)
- {}
- HashBucketNode
* _pNext; - V _data;
- };
- // 本文所实现的哈希桶中key是唯一的
- template<class V>
- class HashBucket
- {
- typedef HashBucketNode
Node; - typedef Node* PNode;
- public:
- HashBucket(size_t capacity = 3): _size(0)
- { _ht.resize(GetNextPrime(capacity), nullptr);}
- // 哈希桶中的元素不能重复
- PNode* Insert(const V& data)
- {
- // 确认是否需要扩容。。。
- // _CheckCapacity();
- // 1. 计算元素所在的桶号
- size_t bucketNo = HashFunc(data);
- // 2. 检测该元素是否在桶中
- PNode pCur = _ht[bucketNo];
- while(pCur)
- {
- if(pCur->_data == data)
- return pCur;
- pCur = pCur->_pNext;
- }
- // 3. 插入新元素
- pCur = new Node(data);
- pCur->_pNext = _ht[bucketNo];
- _ht[bucketNo] = pCur;
- _size++;
- return pCur;
- }
- // 删除哈希桶中为data的元素(data不会重复),返回删除元素的下一个节点
- PNode* Erase(const V& data)
- {
- size_t bucketNo = HashFunc(data);
- PNode pCur = _ht[bucketNo];
- PNode pPrev = nullptr, pRet = nullptr;
- while(pCur)
- {
- if(pCur->_data == data)
- {
- if(pCur == _ht[bucketNo])
- _ht[bucketNo] = pCur->_pNext;
- else
- pPrev->_pNext = pCur->_pNext;
- pRet = pCur->_pNext;
- delete pCur;
- _size--;
- return pRet;
- }
- }
- return nullptr;
- }
- PNode* Find(const V& data);
- size_t Size()const;
- bool Empty()const;
- void Clear();
- bool BucketCount()const;
- void Swap(HashBucket
- ~HashBucket();
- private:
- size_t HashFunc(const V& data)
- {
- return data%_ht.capacity();
- }
- private:
- vector
- size_t _size; // 哈希表中有效元素的个数
- };
3. 开散列增容
桶的个数是一定的,随着元素的不断插入,每个桶中元素的个数不断增多,极端情况下,可
能会导致一个桶中链表节点非常多,会影响的哈希表的性能,因此在一定条件下需要对哈希
表进行增容,那该条件怎么确认呢?开散列最好的情况是:每个哈希桶中刚好挂一个节点,
再继续插入元素时,每一次都会发生哈希冲突,因此,在元素个数刚好等于桶的个数时,可
以给哈希表增容。- void _CheckCapacity()
- {
- size_t bucketCount = BucketCount();
- if(_size == bucketCount)
- {
- HashBucket
- for(size_t bucketIdx = 0; bucketIdx < bucketCount; ++bucketIdx)
- {
- PNode pCur = _ht[bucketIdx];
- while(pCur)
- {
- // 将该节点从原哈希表中拆出来
- _ht[bucketIdx] = pCur->_pNext;
- // 将该节点插入到新哈希表中
- size_t bucketNo = newHt.HashFunc(pCur->_data);
- pCur->_pNext = newHt._ht[bucketNo];
- newHt._ht[bucketNo] = pCur;
- pCur = _ht[bucketIdx];
- }
- }
- newHt._size = _size;
- this->Swap(newHt);
- }
- }
4. 开散列的思考
1. 只能存储key为整形的元素,其他类型怎么解决?
- // 哈希函数采用处理余数法,被模的key必须要为整形才可以处理,此处提供将key转化为
- 整形的方法
- // 整形数据不需要转化
- template<class T>
- class DefHashF
- {
- public:
- size_t operator()(const T& val)
- {
- return val;
- }
- };
- // key为字符串类型,需要将其转化为整形
- class Str2Int
- {
- public:
- size_t operator()(const string& s)
- {
- const char* str = s.c_str();
- unsigned int seed = 131; // 31 131 1313 13131 131313
- unsigned int hash = 0;
- while (*str)
- {
- hash = hash * seed + (*str++);
- }
- return (hash & 0x7FFFFFFF);
- }
- };
- // 为了实现简单,此哈希表中我们将比较直接与元素绑定在一起
- template<class V, class HF>
- class HashBucket
- {
- // ……
- private:
- size_t HashFunc(const V& data)
- {
- return HF()(data.first)%_ht.capacity();
- }
- };
- {
- const int PRIMECOUNT = 28;
- static const size_t primeList[PRIMECOUNT] =
- {
- 53ul, 97ul, 193ul, 389ul, 769ul,
- 1543ul, 3079ul, 6151ul, 12289ul, 24593ul,
- 49157ul, 98317ul, 196613ul, 393241ul, 786433ul,
- 1572869ul, 3145739ul, 6291469ul, 12582917ul,
- 25165843ul,
- 50331653ul, 100663319ul, 201326611ul, 402653189ul,
- 805306457ul,
- 1610612741ul, 3221225473ul, 4294967291ul
- };
- size_t i = 0;
- for (; i < PRIMECOUNT; ++i)
- {
- if (primeList[i] > prime)
- return primeList[i];
- }return primeList[i];
- }
开散列:
负载因子越小,冲突越少,效率越高。
开散列采用挂起,如果新表扩容,那么当旧表释放,vector会将自己的释放,但是挂在vector的结点Node*不会自动释放,因为Node*是内置类型,需要手动释放。
字符串哈希算法链接:各种字符串Hash函数
5. 开散列与闭散列比较
应用链地址法处理溢出,需要增设链接指针,似乎增加了存储开销。事实上:
由于开地址法必须保持大量的空闲空间以确保搜索效率,如二次探查法要求装载因子a <=
0.7,而表项所占空间又比指针大的多,所以使用链地址法反而比开地址法节省存储空间。
3.哈希表的模拟实现
HashTable.h:
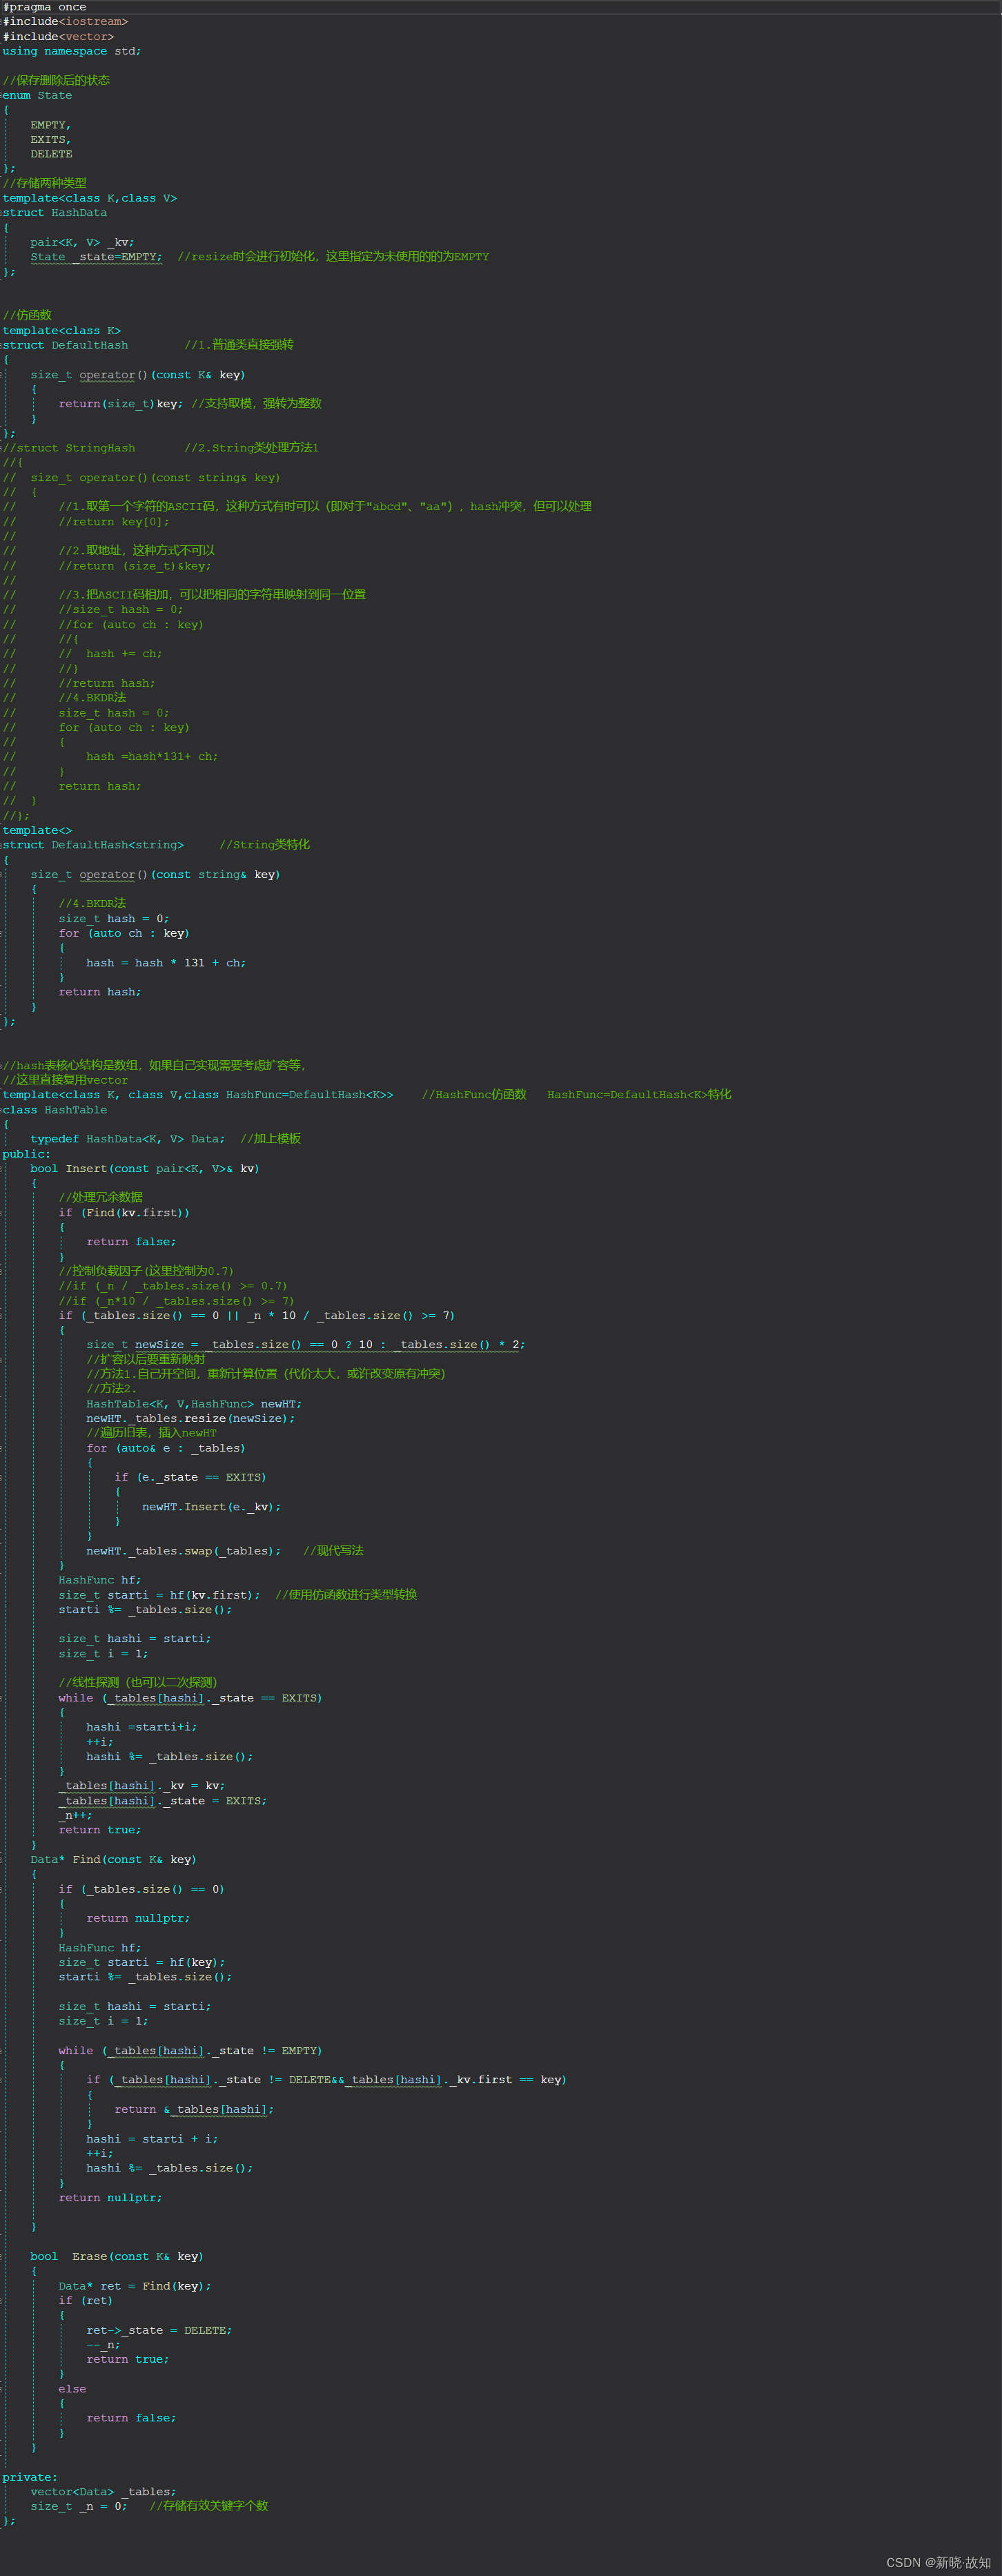
- #pragma once
- #include
- #include
- using namespace std;
- //保存删除后的状态
- enum State
- {
- EMPTY,
- EXITS,
- DELETE
- };
- //存储两种类型
- template<class K,class V>
- struct HashData
- {
- pair
- State _state=EMPTY; //resize时会进行初始化,这里指定为未使用的的为EMPTY
- };
- //仿函数
- template<class K>
- struct DefaultHash //1.普通类直接强转
- {
- size_t operator()(const K& key)
- {
- return(size_t)key; //支持取模,强转为整数
- }
- };
- //struct StringHash //2.String类处理方法1
- //{
- // size_t operator()(const string& key)
- // {
- // //1.取第一个字符的ASCII码,这种方式有时可以(即对于"abcd"、"aa"),hash冲突,但可以处理
- // //return key[0];
- //
- // //2.取地址,这种方式不可以
- // //return (size_t)&key;
- //
- // //3.把ASCII码相加,可以把相同的字符串映射到同一位置
- // //size_t hash = 0;
- // //for (auto ch : key)
- // //{
- // // hash += ch;
- // //}
- // //return hash;
- // //4.BKDR法
- // size_t hash = 0;
- // for (auto ch : key)
- // {
- // hash =hash*131+ ch;
- // }
- // return hash;
- // }
- //};
- template<>
- struct DefaultHash
//String类特化 - {
- size_t operator()(const string& key)
- {
- //4.BKDR法
- size_t hash = 0;
- for (auto ch : key)
- {
- hash = hash * 131 + ch;
- }
- return hash;
- }
- };
- //hash表核心结构是数组,如果自己实现需要考虑扩容等,
- //这里直接复用vector
- template<class K, class V,class HashFunc=DefaultHash
> //HashFunc仿函数 HashFunc=DefaultHash 特化 - class HashTable
- {
- typedef HashData
- public:
- bool Insert(const pair
- {
- //处理冗余数据
- if (Find(kv.first))
- {
- return false;
- }
- //控制负载因子(这里控制为0.7)
- //if (_n / _tables.size() >= 0.7)
- //if (_n*10 / _tables.size() >= 7)
- if (_tables.size() == 0 || _n * 10 / _tables.size() >= 7)
- {
- size_t newSize = _tables.size() == 0 ? 10 : _tables.size() * 2;
- //扩容以后要重新映射
- //方法1.自己开空间,重新计算位置(代价太大,或许改变原有冲突)
- //方法2.
- HashTable
- newHT._tables.resize(newSize);
- //遍历旧表,插入newHT
- for (auto& e : _tables)
- {
- if (e._state == EXITS)
- {
- newHT.Insert(e._kv);
- }
- }
- newHT._tables.swap(_tables); //现代写法
- }
- HashFunc hf;
- size_t starti = hf(kv.first); //使用仿函数进行类型转换
- starti %= _tables.size();
- size_t hashi = starti;
- size_t i = 1;
- //线性探测(也可以二次探测)
- while (_tables[hashi]._state == EXITS)
- {
- hashi =starti+i;
- ++i;
- hashi %= _tables.size();
- }
- _tables[hashi]._kv = kv;
- _tables[hashi]._state = EXITS;
- _n++;
- return true;
- }
- Data* Find(const K& key)
- {
- if (_tables.size() == 0)
- {
- return nullptr;
- }
- HashFunc hf;
- size_t starti = hf(key);
- starti %= _tables.size();
- size_t hashi = starti;
- size_t i = 1;
- while (_tables[hashi]._state != EMPTY)
- {
- if (_tables[hashi]._state != DELETE&&_tables[hashi]._kv.first == key)
- {
- return &_tables[hashi];
- }
- hashi = starti + i;
- ++i;
- hashi %= _tables.size();
- }
- return nullptr;
- }
- bool Erase(const K& key)
- {
- Data* ret = Find(key);
- if (ret)
- {
- ret->_state = DELETE;
- --_n;
- return true;
- }
- else
- {
- return false;
- }
- }
- private:
- vector _tables;
- size_t _n = 0; //存储有效关键字个数
- };
unordered_set、unordered_map使用测试:
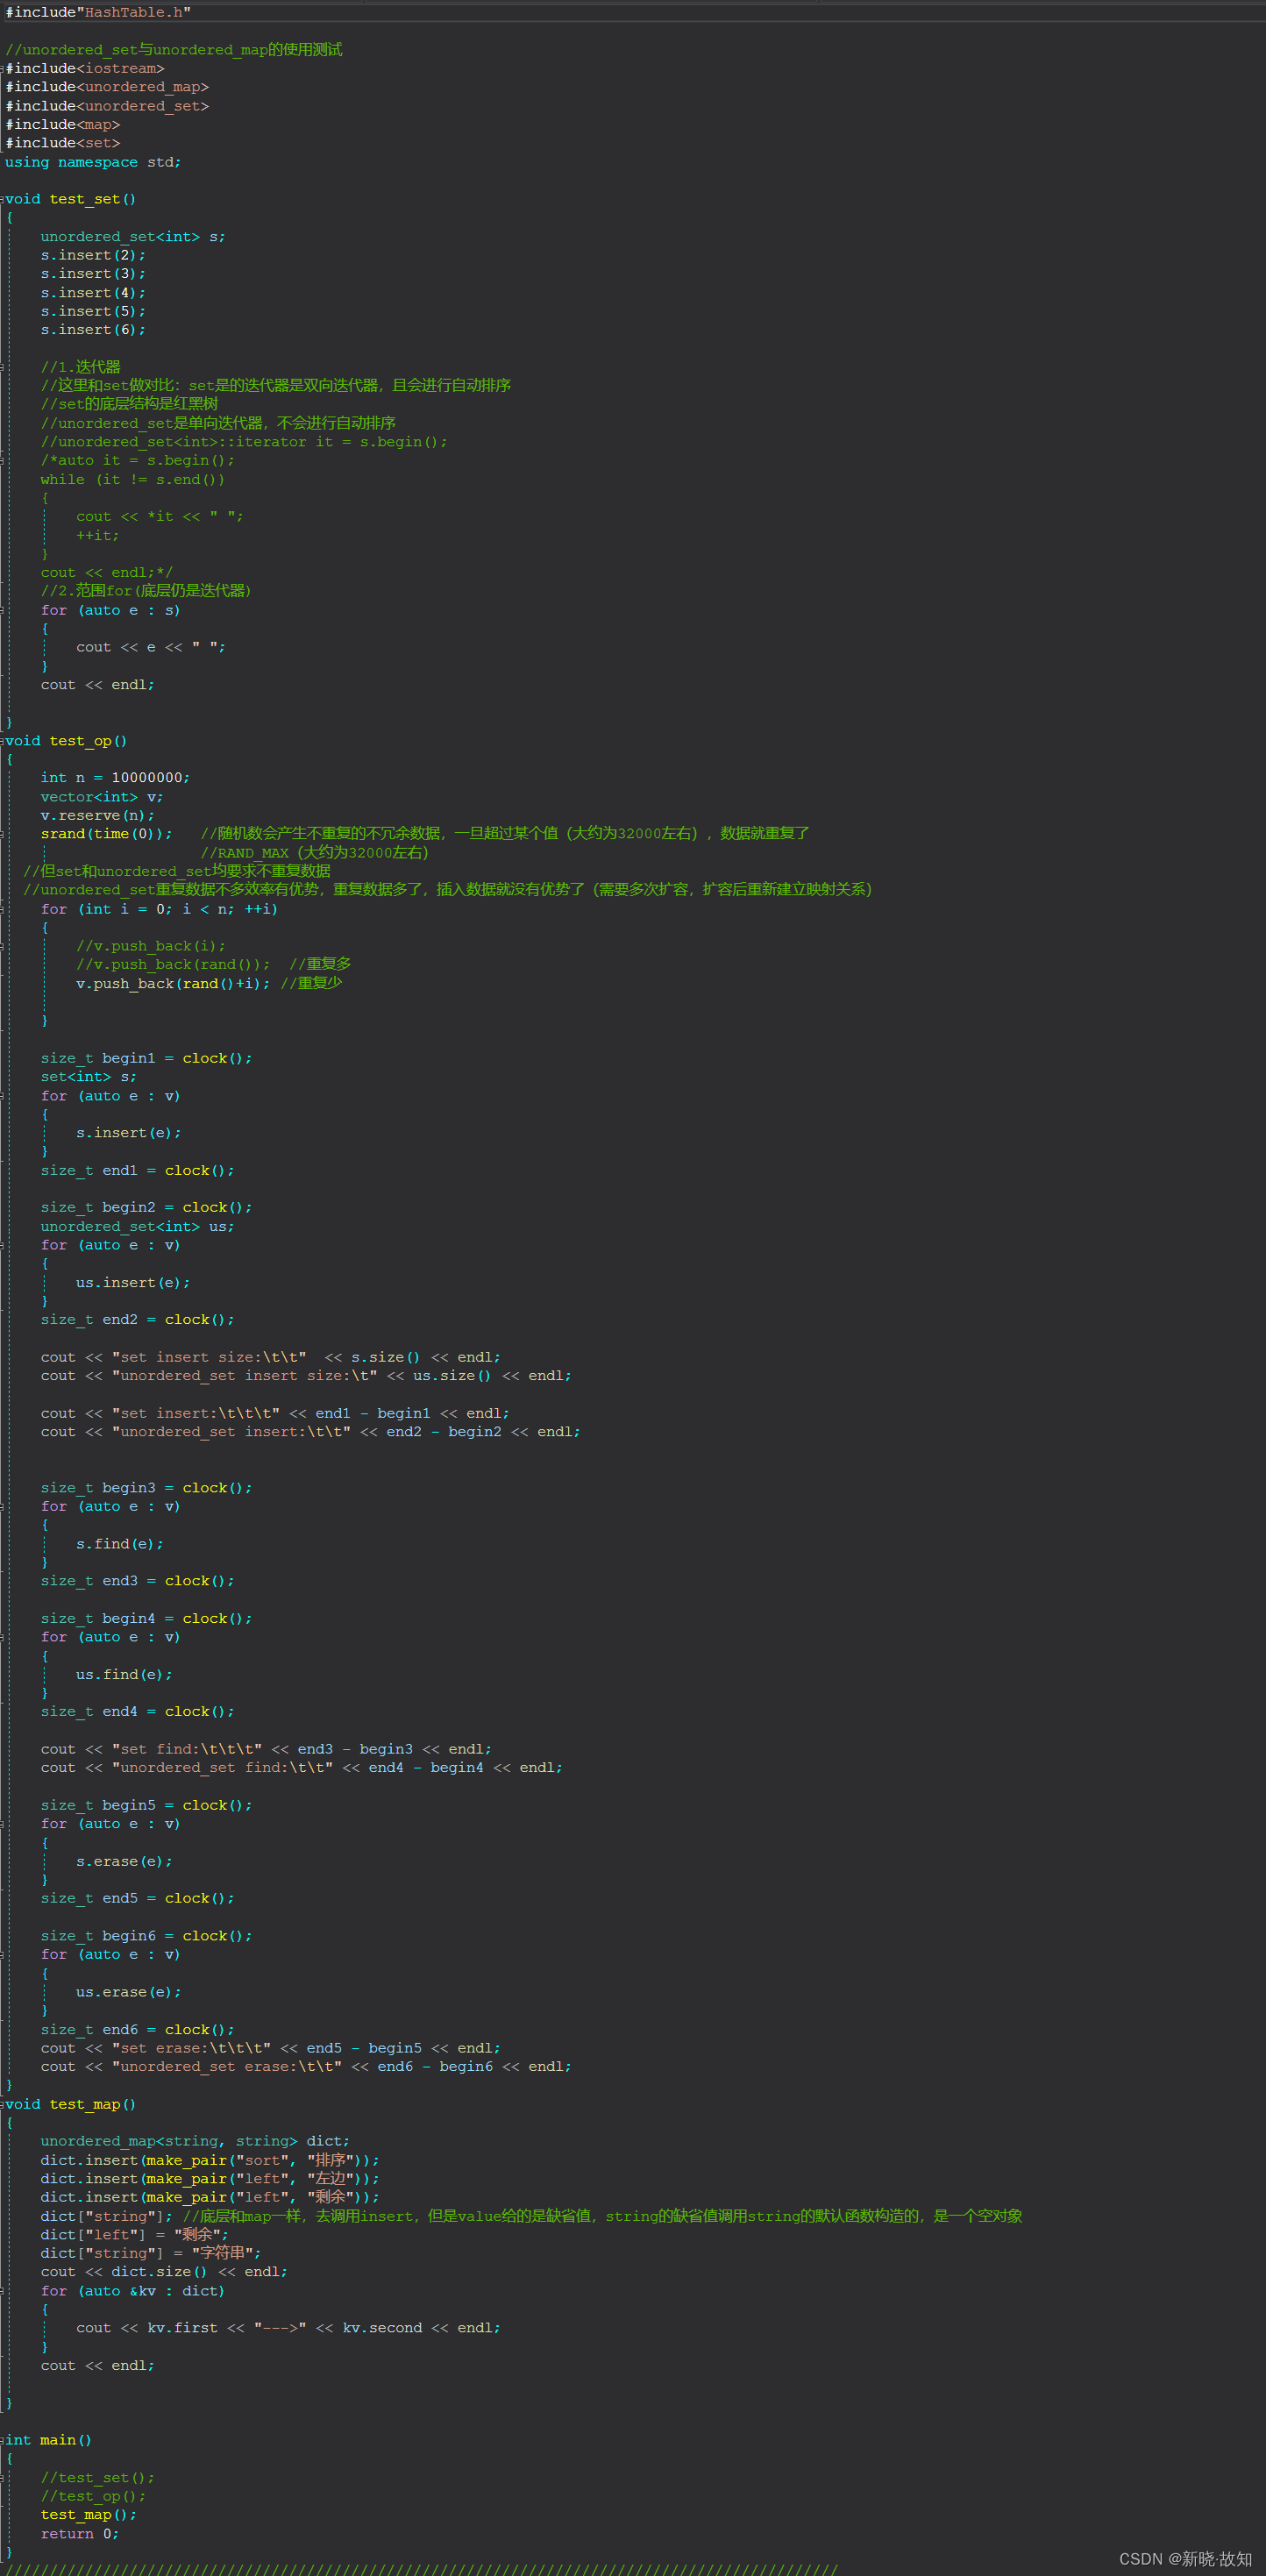
- #include"HashTable.h"
- //unordered_set与unordered_map的使用测试
- #include
- #include
- #include
- #include
- #include
- using namespace std;
- void test_set()
- {
- unordered_set<int> s;
- s.insert(2);
- s.insert(3);
- s.insert(4);
- s.insert(5);
- s.insert(6);
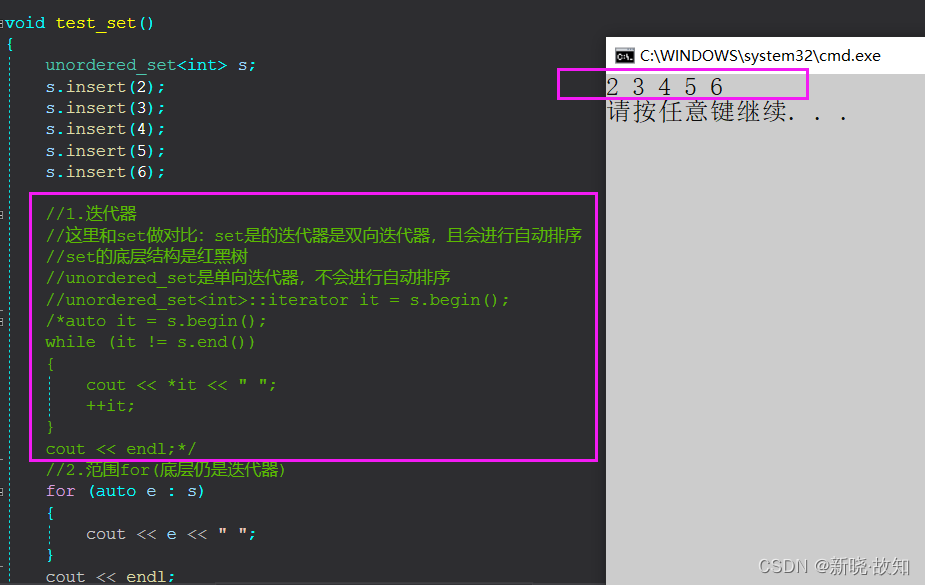
- //1.迭代器
- //这里和set做对比:set是的迭代器是双向迭代器,且会进行自动排序
- //set的底层结构是红黑树
- //unordered_set是单向迭代器,不会进行自动排序
- //unordered_set
::iterator it = s.begin(); - /*auto it = s.begin();
- while (it != s.end())
- {
- cout << *it << " ";
- ++it;
- }
- cout << endl;*/
- //2.范围for(底层仍是迭代器)
- for (auto e : s)
- {
- cout << e << " ";
- }
- cout << endl;
- }
- void test_op()
- {
- int n = 10000000;
- vector<int> v;
- v.reserve(n);
- srand(time(0)); //随机数会产生不重复的不冗余数据,一旦超过某个值(大约为32000左右),数据就重复了
- //RAND_MAX(大约为32000左右)
- //但set和unordered_set均要求不重复数据
- //unordered_set重复数据不多效率有优势,重复数据多了,插入数据就没有优势了(需要多次扩容,扩容后重新建立映射关系)
- for (int i = 0; i < n; ++i)
- {
- //v.push_back(i);
- //v.push_back(rand()); //重复多
- v.push_back(rand()+i); //重复少
- }
- size_t begin1 = clock();
- set<int> s;
- for (auto e : v)
- {
- s.insert(e);
- }
- size_t end1 = clock();
- size_t begin2 = clock();
- unordered_set<int> us;
- for (auto e : v)
- {
- us.insert(e);
- }
- size_t end2 = clock();
- cout << "set insert size:\t\t" << s.size() << endl;
- cout << "unordered_set insert size:\t" << us.size() << endl;
- cout << "set insert:\t\t\t" << end1 - begin1 << endl;
- cout << "unordered_set insert:\t\t" << end2 - begin2 << endl;
- size_t begin3 = clock();
- for (auto e : v)
- {
- s.find(e);
- }
- size_t end3 = clock();
- size_t begin4 = clock();
- for (auto e : v)
- {
- us.find(e);
- }
- size_t end4 = clock();
- cout << "set find:\t\t\t" << end3 - begin3 << endl;
- cout << "unordered_set find:\t\t" << end4 - begin4 << endl;
- size_t begin5 = clock();
- for (auto e : v)
- {
- s.erase(e);
- }
- size_t end5 = clock();
- size_t begin6 = clock();
- for (auto e : v)
- {
- us.erase(e);
- }
- size_t end6 = clock();
- cout << "set erase:\t\t\t" << end5 - begin5 << endl;
- cout << "unordered_set erase:\t\t" << end6 - begin6 << endl;
- }
- void test_map()
- {
- unordered_map
- dict.insert(make_pair("sort", "排序"));
- dict.insert(make_pair("left", "左边"));
- dict.insert(make_pair("left", "剩余"));
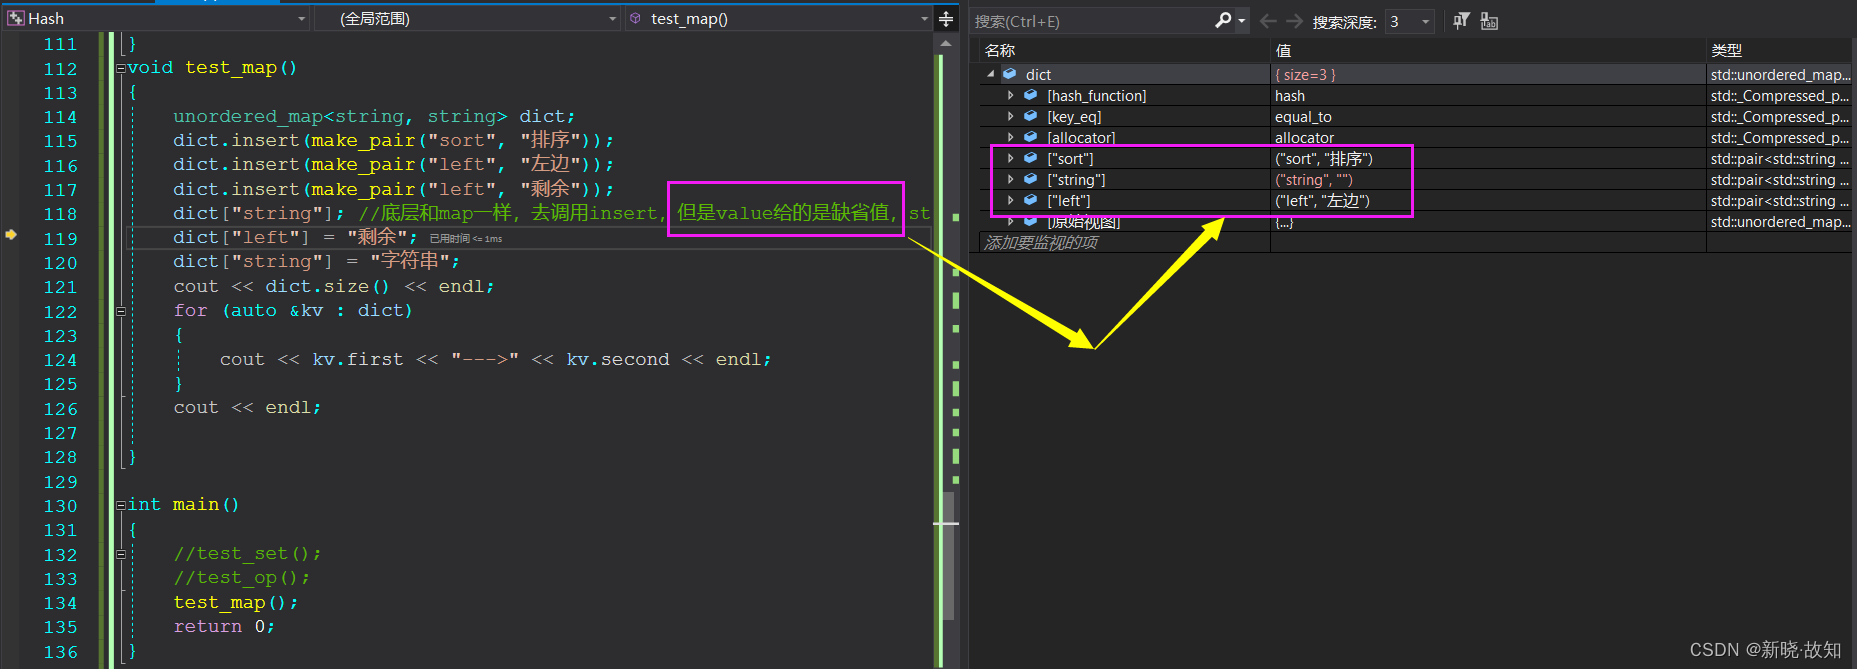
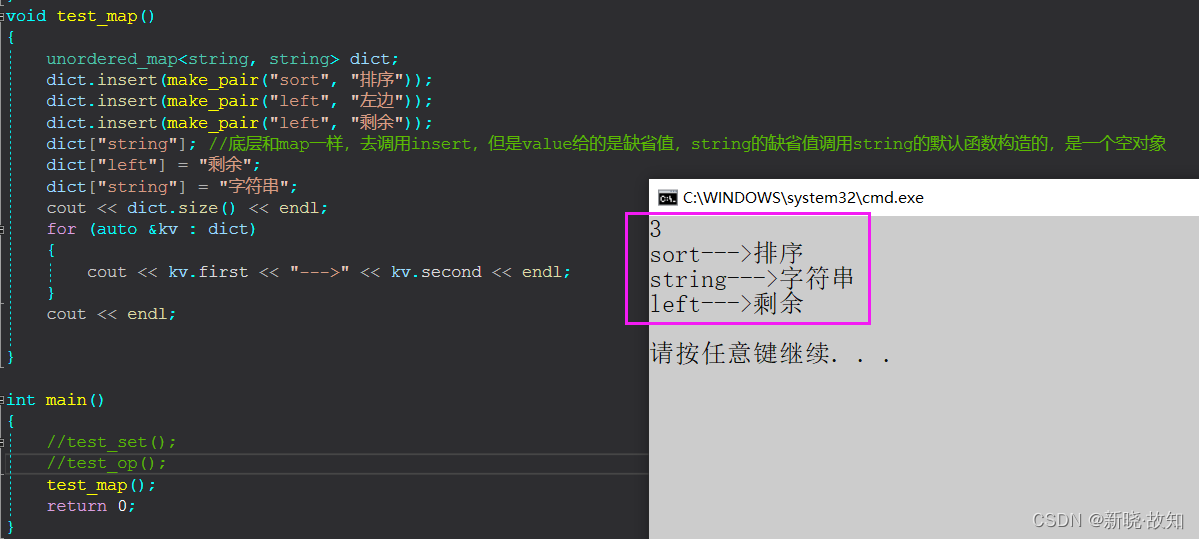
- dict["string"]; //底层和map一样,去调用insert,但是value给的是缺省值,string的缺省值调用string的默认函数构造的,是一个空对象
- dict["left"] = "剩余";
- dict["string"] = "字符串";
- cout << dict.size() << endl;
- for (auto &kv : dict)
- {
- cout << kv.first << "--->" << kv.second << endl;
- }
- cout << endl;
- }
- int main()
- {
- //test_set();
- test_op();
- //test_map();
- return 0;
- }
测试示例:
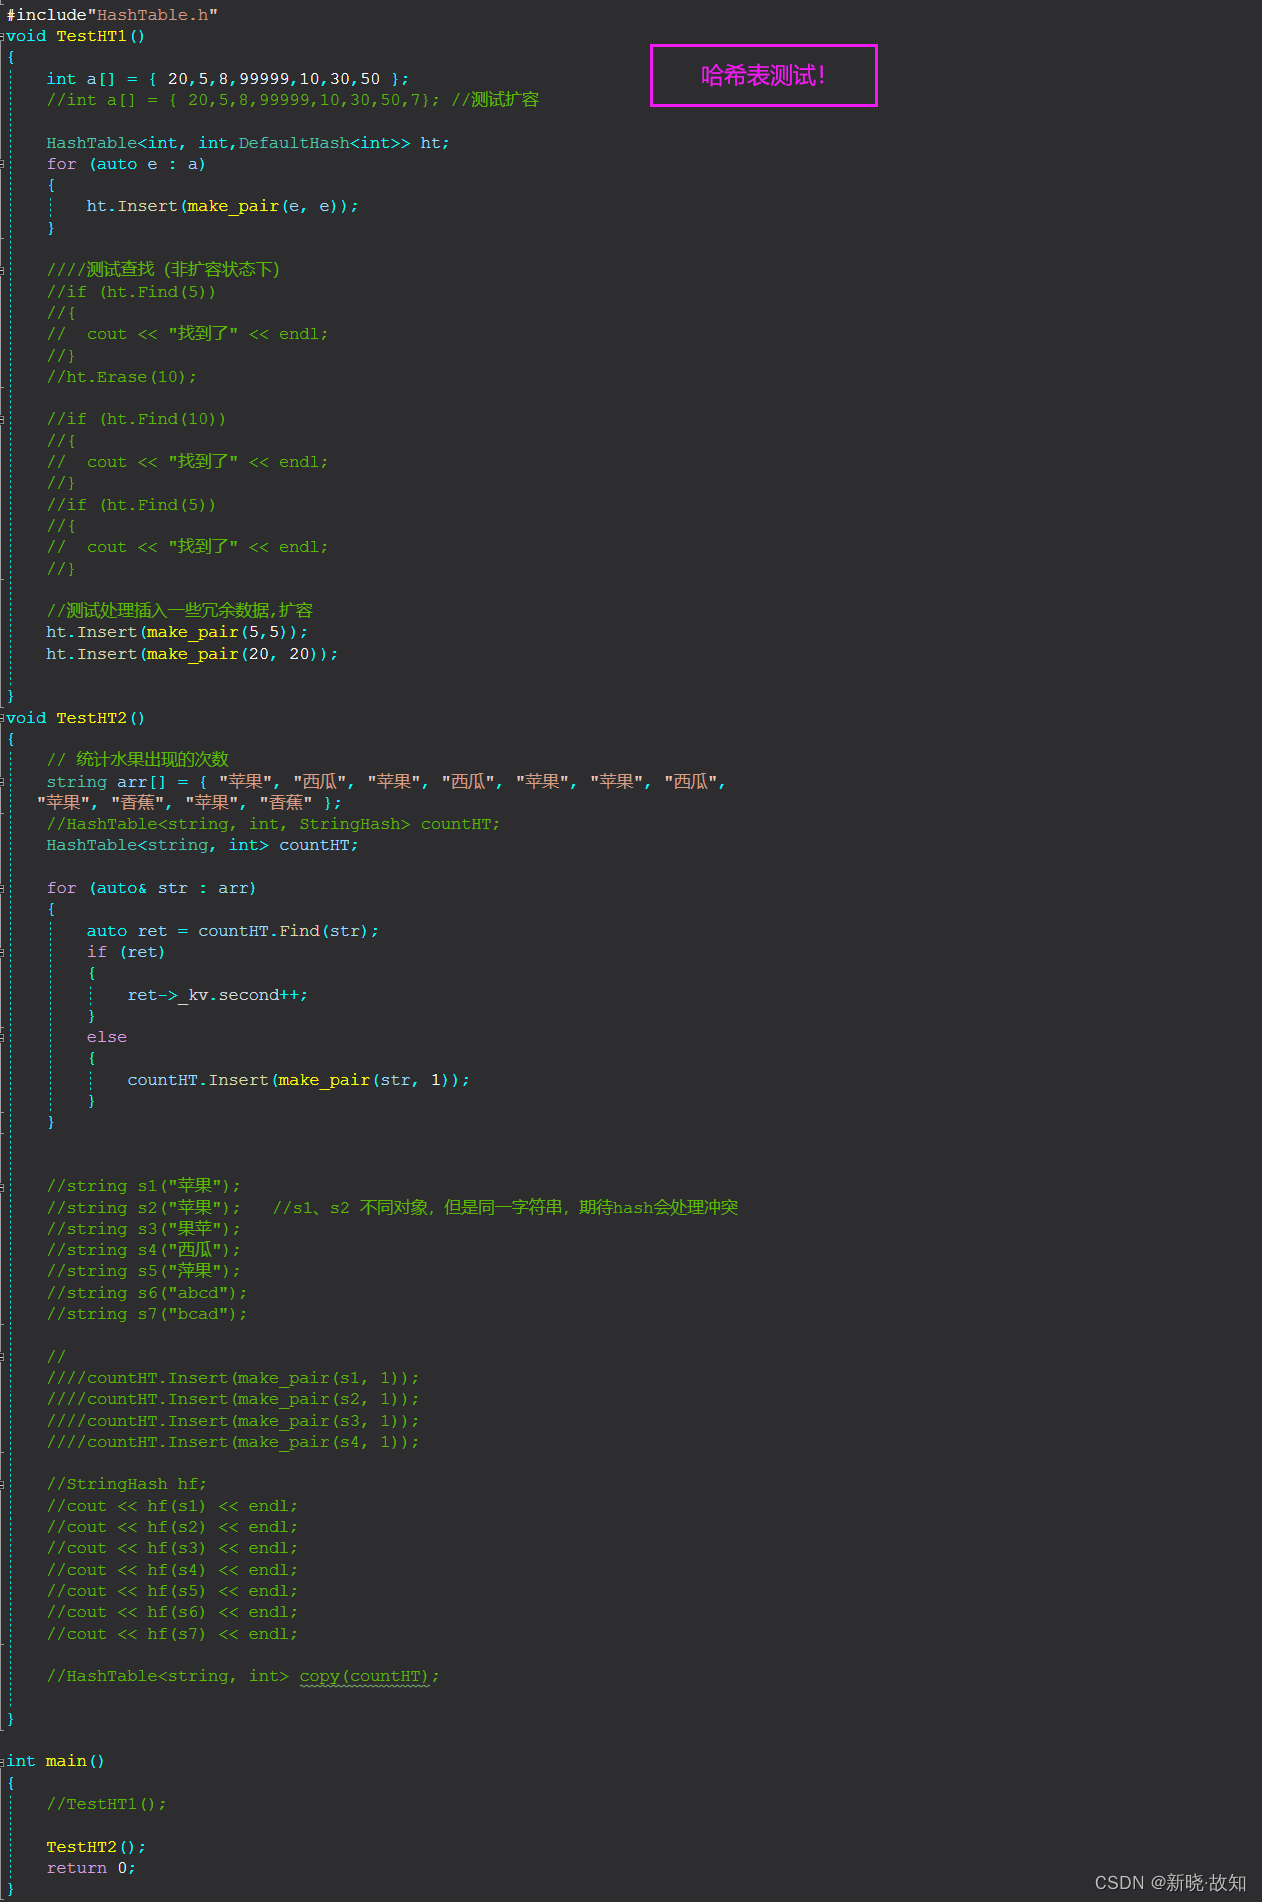
- #include"HashTable.h"
- void TestHT1()
- {
- int a[] = { 20,5,8,99999,10,30,50 };
- //int a[] = { 20,5,8,99999,10,30,50,7}; //测试扩容
- HashTable<int, int,DefaultHash<int>> ht;
- for (auto e : a)
- {
- ht.Insert(make_pair(e, e));
- }
- 测试查找(非扩容状态下)
- //if (ht.Find(5))
- //{
- // cout << "找到了" << endl;
- //}
- //ht.Erase(10);
- //if (ht.Find(10))
- //{
- // cout << "找到了" << endl;
- //}
- //if (ht.Find(5))
- //{
- // cout << "找到了" << endl;
- //}
- //测试处理插入一些冗余数据,扩容
- ht.Insert(make_pair(5,5));
- ht.Insert(make_pair(20, 20));
- }
- void TestHT2()
- {
- // 统计水果出现的次数
- string arr[] = { "苹果", "西瓜", "苹果", "西瓜", "苹果", "苹果", "西瓜",
- "苹果", "香蕉", "苹果", "香蕉" };
- //HashTable
- HashTable
- for (auto& str : arr)
- {
- auto ret = countHT.Find(str);
- if (ret)
- {
- ret->_kv.second++;
- }
- else
- {
- countHT.Insert(make_pair(str, 1));
- }
- }
- //string s1("苹果");
- //string s2("苹果"); //s1、s2 不同对象,但是同一字符串,期待hash会处理冲突
- //string s3("果苹");
- //string s4("西瓜");
- //string s5("萍果");
- //string s6("abcd");
- //string s7("bcad");
- //
- countHT.Insert(make_pair(s1, 1));
- countHT.Insert(make_pair(s2, 1));
- countHT.Insert(make_pair(s3, 1));
- countHT.Insert(make_pair(s4, 1));
- //StringHash hf;
- //cout << hf(s1) << endl;
- //cout << hf(s2) << endl;
- //cout << hf(s3) << endl;
- //cout << hf(s4) << endl;
- //cout << hf(s5) << endl;
- //cout << hf(s6) << endl;
- //cout << hf(s7) << endl;
- //HashTable
- }
- int main()
- {
- //TestHT1();
- TestHT2();
- return 0;
- }
后记:
●由于作者水平有限,文章难免存在谬误之处,敬请读者斧正,俚语成篇,恳望指教!——By 作者:新晓·故知
-
相关阅读:
解密IP分片与重组:数据传输中的关键技术
SAP RANGES定义及管理使用
Verilog HDL语言基础知识
Python------列表 集合 字典 推导式(本文以 集合为主)
JavaScript中异步函数async、await
1688搜索店铺列表 API
人工智能迷惑行为大赏
16-Mysql内核查询成本计算实战-08
用友BIP开发者生态亮相华为全联接大会
全局ID生成算法及使用场景,你用对了么?
- 原文地址:https://blog.csdn.net/m0_57859086/article/details/126861849

- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读