-
电商通用(二)
9.网站首页高可用 nginx+lua
导航:Lua脚本语言、nginx+Lua+redis实现缓存、nginx限流
9.1Lua简介
Lua是脚本语言,C语言编写,为了嵌入应用程序为程序提供灵活的扩展和定制功能。
Lua特性:
1.支持面向过程和函数式编程
2.自动内存管理,只提供一种通用的类型的表,用它实现数组,哈希表,集合,对象
3.语言内置模式匹配;闭包;函数也可以看作一个值;提供多线程
4.通过闭包和table支持面向对象编程所需要的一些机制,比如数据抽象,虚函数,继承和重载。
9.2nginx+lua+redis实现广告缓存
1.nginx有什么用?
1.负载均衡 2.反向代理 3.静态网页服务器
正向代理:浏览器找到首页服务器的真实ip
反向代理:找到nginx的ip,具体ip让nginx做
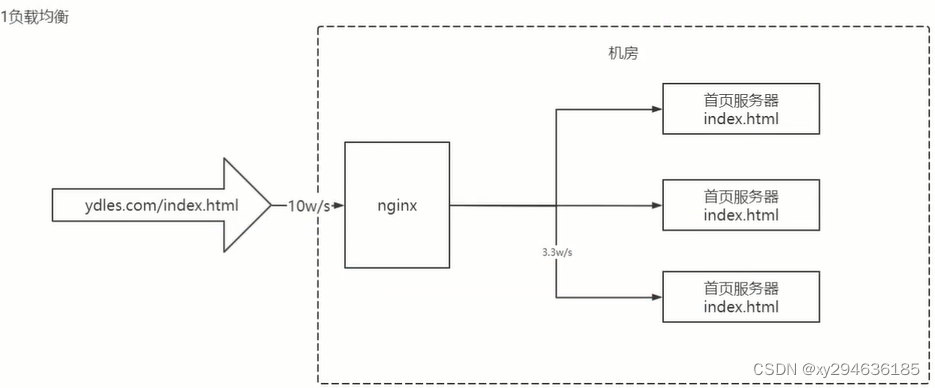
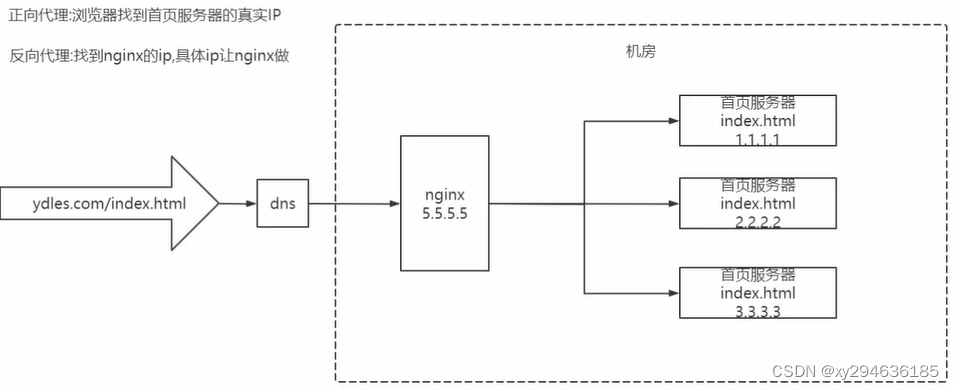
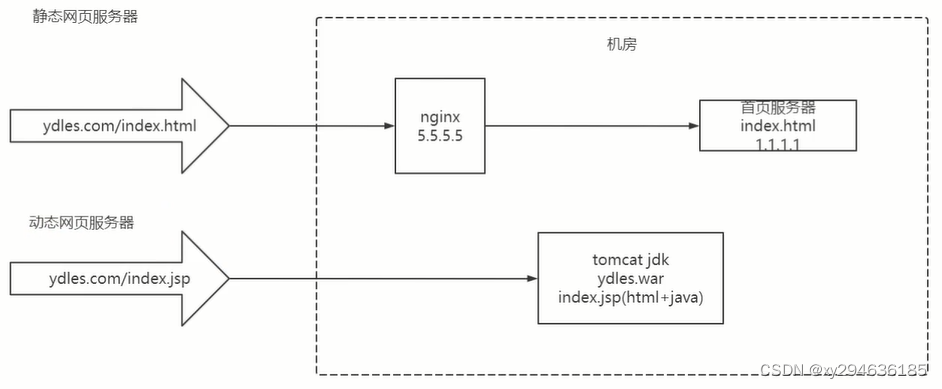
2.tomcat与nginx,网页服务器区别是什么?
1.从应用方面:tomcat一般是动态解析才会用到,支持jsp(html+java)解析,需要JDK。nginx一般是做静态html,负载均衡,反向代理,http服务器
2.性能方面:tomcat并发500;nginx上万tps。
9.3OpenResty
OpenResty简介
OpenResty(ngx_openresty)是一个基于nginx可伸缩的web应用服务器,web开发人员可以使用Lua脚本语言调动nginx支持的各种C以及Lua模块,更主要的是性能方面,OpenResty可以胜任10K乃至1000K以上并发连接响应的超高性能web应用系统。
前置:
需安装nginx、OpenResty在服务器
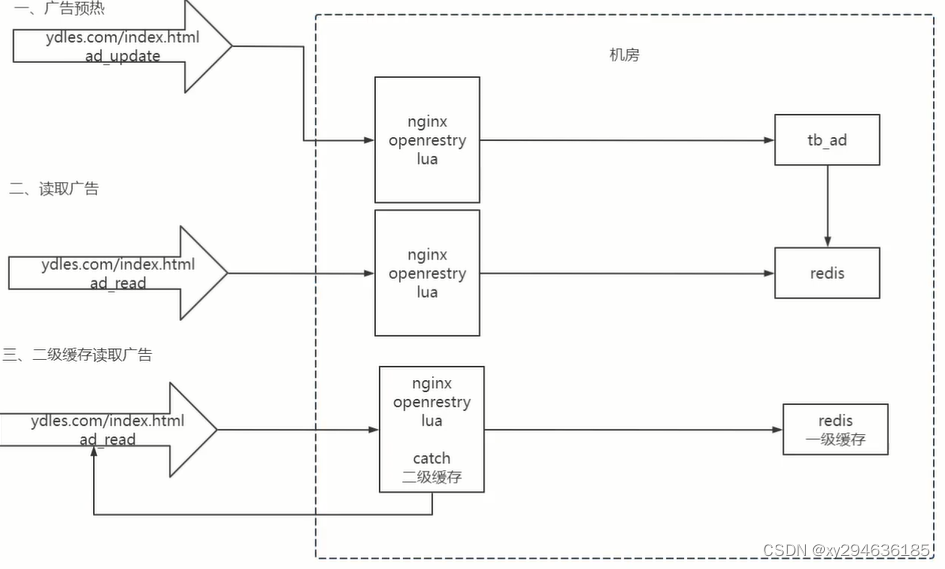
代码实现
数据库:changgou_business库下tb_ad表。
一、广告预热实现
实现:运维人员,脚本,每天凌晨2点。nginx发一个请求(http://127.0.0.1/ad_update?position=web_index_lb),让nginx来做。
实现思路:用于查询数据库中的数据更新到redis中
1.连接mysql:按照广告分类ID读取广告列表,转为json字符串
2.连接redis,将广告列表json字符串存入redis
定义请求:
请求:/ad_update 参数:position 返回值:json
1.编写vim /root/lua/ad_update.lua
- nginx.header.content_type="application/json;charset=utf8" #传递json数据
- local cjson = require("cjson") #引入json支持
- local mysql = require("resty.mysql") #引入mysql支持
- local uri_args = ngx.req.get_uri_args() #获取请求路径的参数 赋值给局部变量
- local position = uri_args["position"] #获取请求参数的特定字段 "position"
- local db = mysql:new() #开启mysql的新连接
- db:set_timeout(1000) #设置数据库连接超时时间
- local_props = {
- host = "192.168.200.128",
- port = 3306,
- database = "mall_business",
- user = "root",
- password = "root"
- }
- local res = db:connect(props) #基于四大参数连接mysql
- local select_sql = "select url, image from tb_ad status ='1' and position='"..position.."' and start_time<=NOW() AND end_time>=NOW()"
- res = db:query(select_sql) #传递执行的SQL语句
- db:close() #关闭连接池
- local redis = require("resty_redis") #引入redis模块
- local red = redis:new() #开启redis连接
- red:set_timeout(2000) #设置redis连接超时时间
- local ip = "192.168.200.128" #设置连接ip地址
- local port = 6379 #redis端口号
- red:connect(ip, port) #连接redis
- res:set("ad_"..position, cjson.encode(res)) #设置存入redis的内容
- res:close() #关闭redis连接
- ngx.say("{flag:true}") #返回信息
2.使nginx执行lua脚本
- vim /usr/local/openresty/nginx/conf/nginx.conf
- #在 server 80 localhost中添加转发
- #添加广告
- location /ad_update{
- content_by_lua_file /root/lua/ad_update.lua;
- }
注意:每次更改完需要重启nginx
- cd /usr/lcoal/openresty/nginx/sbin
- ./nginx -s reload
二、读取广告实现
用户访问首页,钩子方法里,请求(http://127.0.0.1/ad_read?position=web_index_lb)显示。
实现思路:通过lua脚本直接从redis中获取数据即可。
定义请求:请求/ad_read 参数:position 返回值:json
1.编写vim /root/lua/ad_read.lua
- ngx.header.content_type="application/json;charset=utf8
- local uri_args = ngx.req.get_uri_qrgs();
- local position = uri_args["position"];
- local redis = require("resty.redis");
- local red = redis:new()
- red:set_timeout(2000)
- local ok, err = red:connect("192.168.200.128", 6379)
- local rescontent = red:get("ad_"..position) #查询redis的广告数据存入变量
- nginx.say(rescontent) #输出变量
- red:close()
2.拦截请求,修改nginx读取lua脚本
- vim /usr/local/openresty/nginx/conf/nginx.conf
- locatoin /ad_read {
- content_by_lua_file /root/lua/ad_read.lua;
- }
三、二级缓存读取实现
问题:redis请求也上去了,我们直接采用多级缓存来减少下游系统的服务压力
解决方案:先查openresty本地缓存,如果没有再查redis中的数据,再放入本地缓存10min
1.修改root/lua目录下的ad_read文件
- #设置响应头
- ngx.header.content_type="application/json;charset=utf8
- #获取请求中的参数ID
- local uri_args = ngx.req.get_uri_qrgs();
- local position = uri_args["position"];
- local cache_ngx = ngx.shared.dis_cache; #开启本地缓存
- local adCache = cache_ngx:get('ad_cache_'..position); #在本地缓存中查询数据
- if(adCache==""or addCache==nil then #判断当前结果为空或无效
- local redis = require("resty.redis"); #引入redis库
- local red = redis:new() #创建redis对象
- red:set_timeout(2000) #设置超时时间
- local ok, err = red:connect("192.168.200.128", 6379) #连接
- local rescontent = red:get("ad_"..position) #获取key值
- nginx.say(rescontent) #输出返回信息
- red:close()
- cache_ngx:set('ad_cache_'..postition, rescontent, 10*60); #存入本地缓存10min
- else
- ngx.say(addCache)
- end
2.修改nginx配置 vi /usr/local/openresty/mginx/conf/nginx.conf,http节点下添加配置
- #包含redis初始化模块
- lua_shared_dict dis_cache 5m; #共享内存开启
9.4nginx限流
首页并发量大,即使有了多级缓存,如果有大量恶意请求,也会对系统造成影响,就需要限流。
nginx提供两种限流方式:
1.控制速率
2.控制并发链接数
9.4.1控制速率
采用漏桶算法。请求先进入漏桶中,漏桶以一定的速度出水,当水流速度大会直接溢出(访问频率超过接口响应速率),然后就拒绝。
与令牌桶的区别:
令牌桶控制的是进的速度。漏桶控制的出的速度。
漏桶算法nginx实现配置:
- vim conf/nginx.conf
- #设置限流配置
- #binary_remote_addr:key,表示基于remote_addr(客户端ip)来做限流,binary_的目的是压缩内存占用量
- #zone:定义共享内存区来访问存储信息,myRateLimit内存区域名称,1m能存储16000ip地址
- #rate:用于设置最大访问速率,10r/s表示每秒最多处理10个请求
- limit_req_zone $binary_remote_addr zone=myRateLimit:10m rate=2r/s; #漏桶大小:10m
- server {
- listen 8081;
- server_name local;
- charset utf-8;
- location / {
- limit_req zone=myRateLimit;
- root html;
- index index.html index.html;
- }
- }
9.4.2处理突发流量
如果有正常流量突然增大,超出请求将被拒绝,可以用burst参数来解决该问题。
burst表示超过设定的处理速率后能额外处理的请求数,当rate=2r/s时,将1s拆分成2份,即每500ms可处理一个请求。当burst=5时,同时有6个请求达到,nginx会处理第一个请求,剩余5个请求会放入队列,然后每隔500ms从队列中获取一个请求进行处理。若请求大于6,将拒绝多余请求,返回503.
- location / {
- limit_req zone=myRateLimit burst=5 nodelay;
- root html;
- index index.html index.html;
- }
10.数据同步解决方案-canal
定位:数据监控后端
导航:数据监控微服务,首页广告缓存,商品上架索引库导入,下架索引库删除数据功能实现。
10.1canal
早期阿里杭州和美国双机房部署,存在跨域机房同步部署业务需求,实现方式主要是基于业务trigger获取增量变更。从10年开始,业务逐步尝试数据库日志解析获取增量变更进行同步,由此衍生出大量的数据库增量订阅和消费业务。
MySql主备复制
MySQL master将数据变更写入二进制日志binlog。
MySQL slave将master的binlog events 拷贝到它的中继日志relay log
MySQL slave重放relay log中事件,将数据变更反映它自己的数据
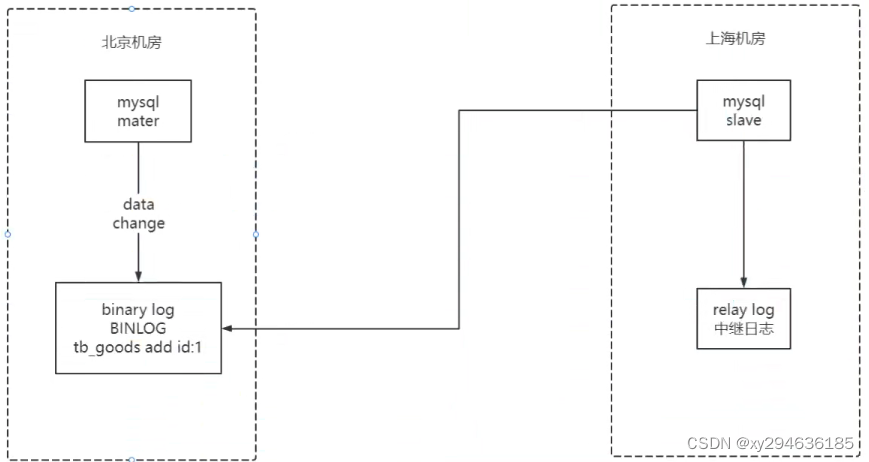
cancal工作原理:
1.canal模拟mysql slave的交互协议,伪装自己为mysql slave,向mysql master发送dump协议
2.mysql master收到dump请求,开始推送binary log给slave(canal)
3.canal解析binlog对象(byte流)
10.1.2mysql开启binlog
1.查看当前mysql是否开启binlog: show varibles like '%log_bin%'
2.修改/etc/my.cnf需要开启binlog模式
- [mysqld]
- log-bin=mysql-bin
- binlog-format=ROW
- server_id=1
3.进入mysql:mysql -h localhost -u root -p
4.创建账号
- create user canal@'%' IDENTIFIED by 'canal';
- GRANT SELECT,REPLICATION SLAVE,REPLICATION CLIENT,SUPER ON *.* TO 'canal'@'%';
- FLUSH PRIVILEGES;
10.1.3canal服务端安装配置
百度
10.2数据监控微服务
当用户执行数据库的操作的时候,binlog日志会被canal捕获到并解析出数据。
springboot与canal集成开源项目:https://github.com/chenqian56131/spring-boot-starter-canal
10.3首页广告缓存更新
需求:当tb_ad表数据变化时,更新redis中的广告数据。
实现:数据监控微服务canal监听到tb_ad数据库发生变化时,通过rabbitMQ发送异步请求到http://127.0.0.1/ad_update?position=web_index_lb 执行lua(openresty)脚本
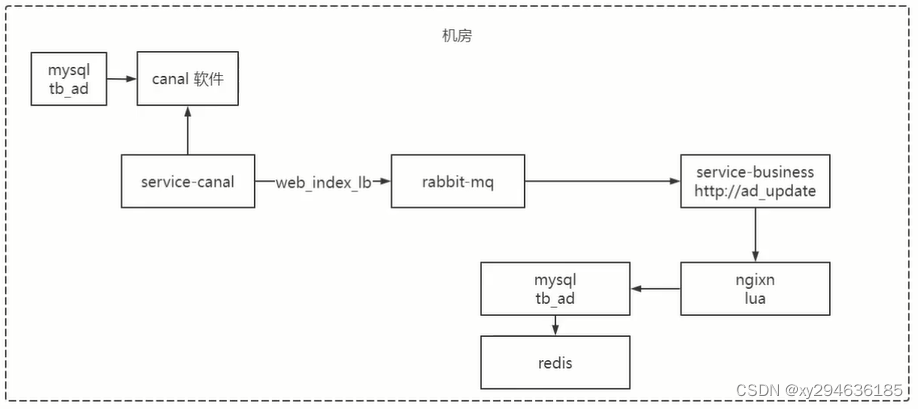
代码实现:
10.3.1发送消息到mq
1.在rabbitmq管理后台创建队列ad_update_queue,用于接收广告更新通知
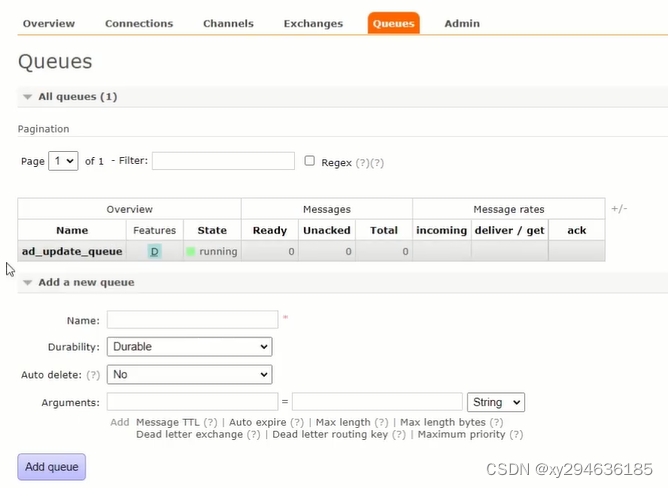
2.引入rabbitmq依赖
3.添加配置文件
4.新增rabbitmq配置类
5.测试重启canal,修改数据库,观察mq
10.3.2从mq中提取消息执行更新
mall_service_business工程中:
1.添加依赖
2.添加配置
3.添加监听类
代码:https://gitee.com/xuyu294636185/mall_parent.git
10.3商品上架索引库导入数据
需求:商品上架将商品的sku列表导入或更新索引库。
实现:
1.商品上架(spu.is_marktable 0变为1) --> canal监控 -->mq发送spuid
2.在rabbitmq管理后台创建商品上架交换机(fanout订阅发布模式)
3.spuid-》搜索服务-》feign商品服务获取skuList-》放入Es索引库。
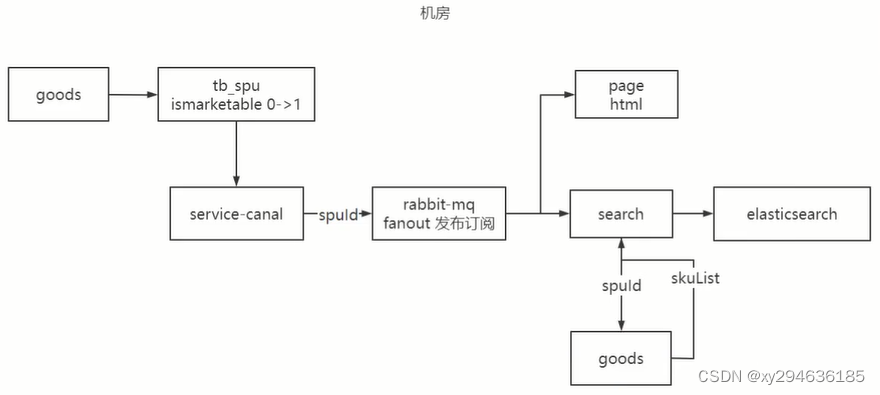
10.3.1发送消息到mq
1.在rabbitmq后台创建交换机goods_up_exchange(fanout),创建队列search_add_queue绑定交换器goods_up_exchange,更新rabbitmq配置类。
2.数据监控微服务新增canal.Listener.SpuListener代码。
10.3.2索引库环境准备(elasticsearch的docker镜像)
创建索引结构:新建mall_service_search_api模块,添加索引库实体类。
10.3.3搜索微服务搭建
1.创建mall_service_search模块,导依赖
2.添加配置文件
3.创建启动类
4.配置RabbitMQConfig
10.3.4视商品服务查询商品信息
1.skuController新增方法
2.mall_service_goods_api新增common依赖
3.定义skuFeign接口
10.3.5搜索微服务批量导入数据逻辑
1.创建com.mall.search.dao包,新增ESManagerMapper接口
2.创建com.mall.search.service包,创建接口ExManagerService
10.3.6接收mq消息执行导入
逻辑:canal监听到某个spu上架,发送到mq之后,搜索服务接受消息,将此spu对应的sku查出来,放到es索引库。
mall_service_search工程创建com.mall.search.listener包,创建GoodsUpListener
10.4商品下架索引库删除数据
1.在数据监控微服务中监控tb_spu表的数据,当is_marketable为0时,表示商品下架,将spu的id发送到rabbitmq。
2.在rabbitmq管理后台创建商品下架交换器(fanout)。使用分列模式的交换机是考虑商品下架会有很多种逻辑需要处理,索引库删除数据只是其中一项,另外还有删除商品详情页数等操作。
3.搜索微服务从rabbitmq的队列中提取spu的id,通过elasticsearch的高级restAPI将相关的sku列表从索引库删除。
10.4.1创建交换机与队列
1.完成商品下架交换机的创建,队列的创建于绑定,将spuId发送消息到mq
2.将rabbitmqConfig复制到搜索服务
10.4.2canal监听下架
修改mall_canal的SpuListener的SpuUpdate方法,添加下架判断发送消息逻辑
10.4.3根据spuId删除索引数据
ESManagerService新增删除方法。
10.4.4接收mq消息,执行索引库删除
从rabbitmq中提取消息,调动根据spuId删除索引库数据的方法mall_service_search新增监听类
代码:https://gitee.com/xuyu294636185/mall_parent.git
11.商品搜索-elastaicSearch
导航:搜索关键字查询,条件筛选,规格过滤,价格区间搜索,分页查询,排序查询,高亮查询
11.1关键字查询-构建搜索条件

- public class SearchServiceImpl implements SearchService {
- @Autowired
- ElasticsearchTemplate elasticsearchTemplate;
- @Override
- public Map search(Map<String, String> searchMap) {
- NativeSearchQueryBuilder nativeSearchQueryBuilder = new NativeSearchQueryBuilder();
- BoolQueryBuilder boolQueryBuilder = QueryBuilders.boolQuery();
- if (searchMap != null) {
- //多个搜索条件 bool
- if (StringUtils.isNotEmpty(searchMap.get("keywords"))) {
- MatchQueryBuilder matchQueryBuilder = QueryBuilders.matchQuery("name", searchMap.get("keywords"));
- boolQueryBuilder.must(matchQueryBuilder);
- }
- }
- nativeSearchQueryBuilder.withQuery(boolQueryBuilder);
- /**
- * nativeSearchQueryBuilder 能承接一些搜索的条件
- * SkuInfo 实体类对象
- * SearchResultMapper 结果集,对象 映射
- */
- AggregatedPage<SkuInfo> skuInfos = elasticsearchTemplate.queryForPage(nativeSearchQueryBuilder.build(), SkuInfo.class, new SearchResultMapper() {
- //把搜索结果和对象映射
- @Override
- public
AggregatedPage mapResults(SearchResponse searchResponse, Class aClass, Pageable pageable ) { - List
list = new ArrayList<>(); - SearchHits hits = searchResponse.getHits(); //大Hits ,含有页数信息的外层结构
- //总数
- long totalHits = hits.getTotalHits();
- SearchHit[] hits1 = hits.getHits();
- for (SearchHit hit : hits1) {
- //hit --> SkuInfo对象
- String sourceAsString = hit.getSourceAsString(); //拿到{id:123,name:xxx,price} json串
- SkuInfo skuInfo = JSON.parseObject(sourceAsString, SkuInfo.class);
- list.add((T) skuInfo);
- }
- return new AggregatedPageImpl<>(list, pageable, totalHits, searchResponse.getAggregations());
- }
- });
- Map resultMap = new HashMap();
- //总记录数
- resultMap.put("total", skuInfos.getTotalElements());
- //总页数
- resultMap.put("totalPages", skuInfos.getTotalPages());
- //数据集合
- resultMap.put("rows", skuInfos.getContent());
- return null;
- }
- }
11.2各种查询
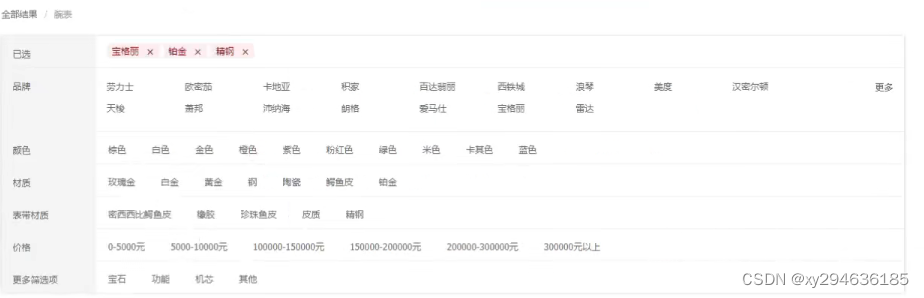
11.2.1品牌过滤查询
需求:search.mall.com/search?keywords=包&brand=prada
- //品牌查询
- if(StringUtils.isNotEmpty(searchMap.get("brand"))){
- //brandName在es中类型是keyword 需要使用trerm查询
- TermQueryBuilder termQueryBuilder = QueryBuilders.termQuery("brandName", searchMap.get("brand"));
- //term查询一般放在filter中
- boolQueryBuilder.filter(termQueryBuilder);
- }
11.2.2品牌聚合查询
需求:查看静态页面,品牌的显示要根据搜索结果不同展示。(在es中按照beandName进行聚合查询)
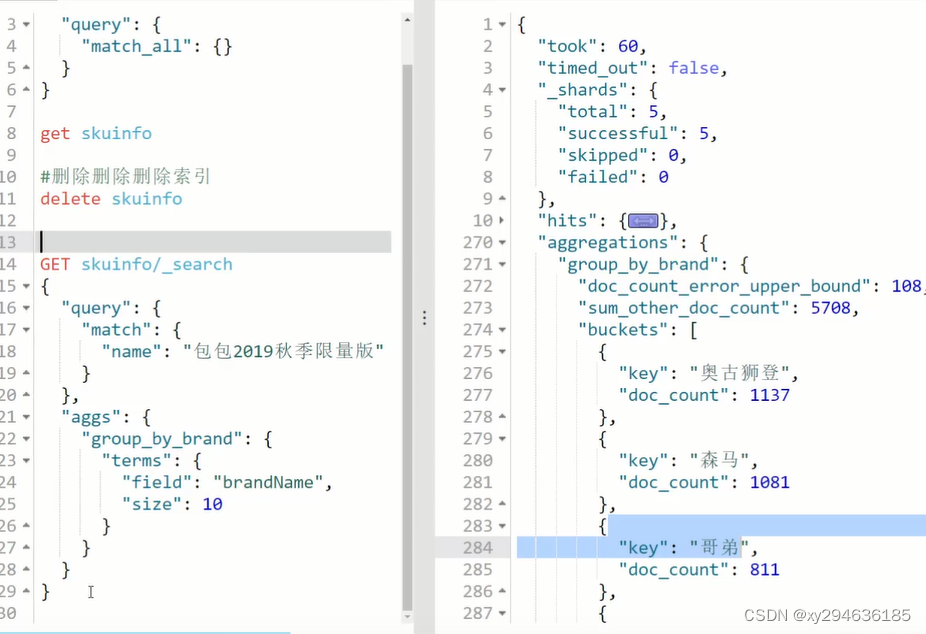
- //品牌查询
- if(StringUtils.isNotEmpty(searchMap.get("brand"))){
- //brandName在es中类型是keyword 需要使用trerm查询
- TermQueryBuilder termQueryBuilder = QueryBuilders.termQuery("brandName", searchMap.get("brand"));
- //term查询一般放在filter中
- boolQueryBuilder.filter(termQueryBuilder);
- }
- //聚合 品牌
- String skuBrand = "skuBrand";
- TermsAggregationBuilder brandTerms = AggregationBuilders.terms(skuBrand).field("brandName");
- nativeSearchQueryBuilder.addAggregation(brandTerms);
- //把品牌聚合的结果返回前端
- StringTerms brandStringTerms = (StringTerms) skuInfos.getAggregation(skuBrand);
- List
brandList = brandStringTerms.getBuckets().stream().map(bucket -> bucket.getKeyAsString()).collect(Collectors.toList()); - resultMap.put("brandList",brandList);
11.2.3按照规格过滤
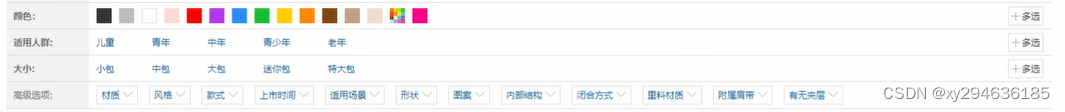
需求:前端发规格查询,后端接收到数据可以根据spec_来区分是否是规格,如果以spec_xxx开始的数据则为规格数据,需要根据指定规格找到信息。
http://localhost:9009/search?keywords=包&spec_颜色=黑色&spec_二手成都=九新
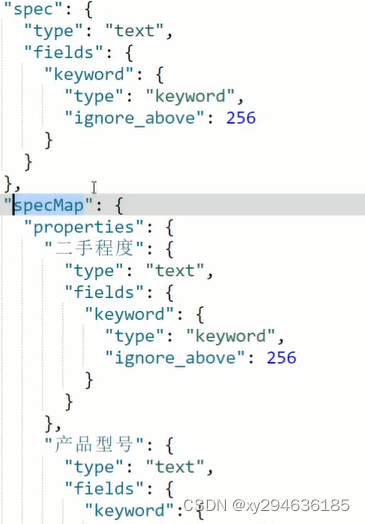
上图是规格的索引存储格式,真实数据在“specMap.二手成都.keyword”中,所以找数据也是按照如下格式去找。
- //规格查询 spec_有多个需要遍历
- for (String key : searchMap.keySet()) {
- if(key.startsWith("spec_")){
- String value = searchMap.get(key).replace("%2B","+"); //url特殊字符转换
- TermQueryBuilder termQueryBuilder = QueryBuilders.termQuery("searchMap." + key.substring(5) + ".keyword", value);
- boolQueryBuilder.filter(termQueryBuilder);
- }
- }
11.2.4按照规格聚合
text类型不能进行集合和排序,keyword可以进行聚合和排序

11.2.5价格区间查询
需求:前端传入后台price=0-500或者price=500-1000依次类推,最后一个是price=3000,后台可以根据-分割,如果分割得到的结果最多有2个,第1个表示x
- if(StringUtils.isNotEmpty(searchMap.get("price"))){
- String price = searchMap.get("price");
- String[] split = price.split("-");
- if(split.length==2){
- //price=0-5000
- RangeQueryBuilder rangeQueryBuilder = QueryBuilders.rangeQuery("price").gte(split[0]).lte(split[1]);
- boolQueryBuilder.filter(rangeQueryBuilder);
- }else{
- //price=5001
- RangeQueryBuilder rangeQueryBuilder = QueryBuilders.rangeQuery("price").gte(split[0]);
- boolQueryBuilder.filter(rangeQueryBuilder);
- }
- }
11.2.6分页
需求:pageNum=2&pageSize=20

- //分页
- String pageNum = searchMap.get("pageNum");
- String pageSize = searchMap.get("pageSize");
- if(StringUtils.isEmpty("pageNum")){
- pageNum = "1";
- }
- if(StringUtils.isEmpty("pageSize")){
- pageSize = "20";
- }
- PageRequest pageRequest = PageRequest.of(Integer.parseInt(pageNum) - 1, Integer.parseInt(pageSize));
- nativeSearchQueryBuilder.withPageable(pageRequest);
11.2.7排序
排序总共有根据价格排序,根据评价排序,根据新品排序,根据销量排序,想要排序只需要告知排序的域以及排序方式即可实现。
需求:sortField=price&sortRule=Desc
- //排序
- String sortField = searchMap.get("sortField");
- String sortRule = searchMap.get("sortRule");
- if (StringUtils.isNotEmpty(sortField) && StringUtils.isNotEmpty(sortRule)) {
- if(sortRule.equals("ASC")){
- nativeSearchQueryBuilder.withSort(SortBuilders.fieldSort(sortField).order(SortOrder.ASC));
- }else{
- nativeSearchQueryBuilder.withSort(SortBuilders.fieldSort(sortField).order(SortOrder.DESC));
- }
- }
11.2.8高亮
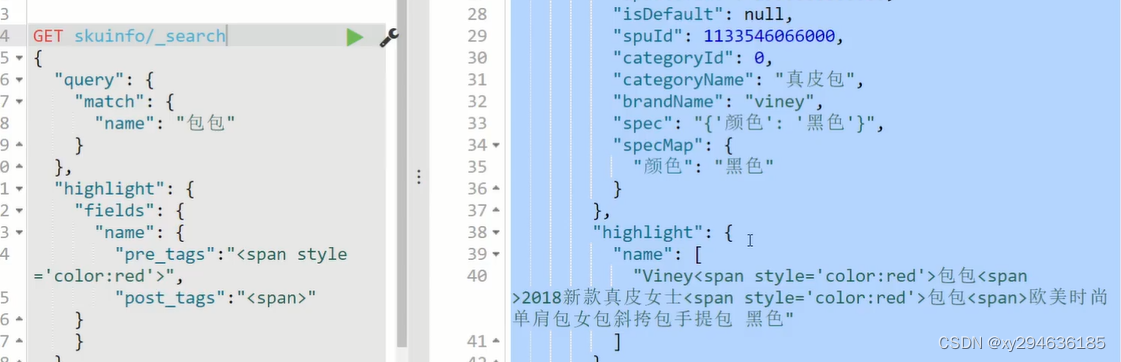
- //设置高亮
- HighlightBuilder field = new HighlightBuilder().field("name");
- //前签
- field.preTags("");
- //后签
- field.postTags("");
- nativeSearchQueryBuilder.withHighlightBuilder(field);
- //获取高亮,设置到name属性中
- Map<String, HighlightField> highlightFields = hit.getHighlightFields();
- HighlightField highlightField = highlightFields.get("name");
- Text[] fragments = highlightField.getFragments();
- String realName = "";
- for (Text fragment : fragments) {
- realName+=fragment; //jdk底层
- }
- skuInfo.setName(realName);
- list.add((T) skuInfo);
代码:https://gitee.com/xuyu294636185/mall_parent.git
12.Thymeleaf
导航:Thymeleaf入门,语法和标签,搜索页面渲染,商品详情页静态化功能实现。
12.1Thymeleaf简介
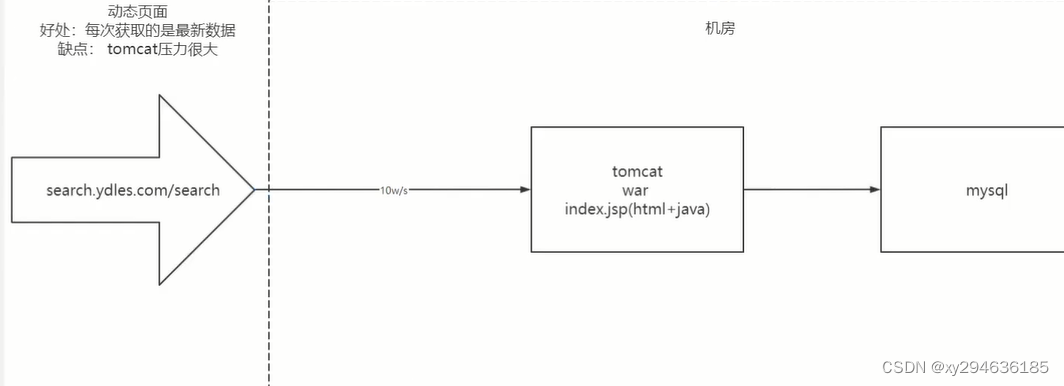
12.1.1动态页面
通过执行asp,php等程序生成客户端网页代码的网页。
12.1.2静态页面
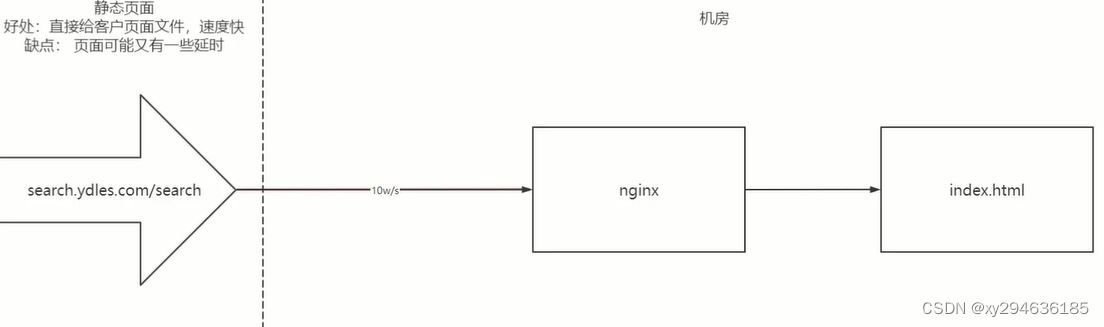
12.1.3为什么需要动态页面静态化
1.搜索引擎的优化
SEO优化,增加搜索访问量
2.提高程序性能
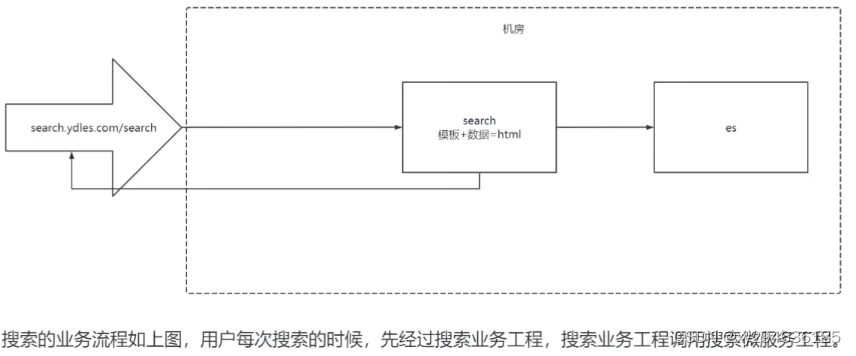
模板+数据=文本
12.1.4Thtmeleaf介绍
概念:XML/XHTML/HTML5模板引擎
其他模板引擎:Velocity,FreeMarker,jsp
使用:springboot内部支持
特点:开箱即用,Thymeleaf允许您处理六种模板,每种模板成为模板模式:
XML,有效的XML,XHTML,有效的XHTML,HTML5,旧版HTML5
12.2Springboot整合thymeleaf
使用springboot整合thymeleaf可以减少代码量。
1.创建springboot-thymeleaf工程。
- <parent>
- <groupId>org.springframework.bootgroupId>
- <artifactId>spring-boot-starter-parentartifactId>
- <version>2.1.4.RELEASEversion>
- parent>
- <dependencies>
- <dependency>
- <groupId>org.springframework.bootgroupId>
- <artifactId>spring-boot-starter-webartifactId>
- dependency>
- <dependency>
- <groupId>org.springframework.bootgroupId>
- <artifactId>spring-boot-starter-thymeleafartifactId>
- dependency>
- dependencies>
- @Controller
- @RequestMapping("test")
- public class TeatController {
- //model放值
- //view 放返回demo页面
- @GetMapping("demo")
- public String demo(Model model){
- //从数据库获取到真实的值
- model.addAttribute("hello","hello");
- return "demo";
- }
- }
- resource下创建template包存放模板:demo.html
- html>
- <html xmlns:th="http://www.thymeleaf.org">
- <head>
- <title>Thymeleaf 入门title>
- <meta http-equiv="Content-Type" content="text/html; charset=UTF-8"/>
- head>
- <body>
- <p th:text="${hello}">p>
- body>
- html>
12.3thymeleaf基本语法
百度
12.4搜索页面渲染
搜索页面要显示的内容主要分为:1.搜索的数据结果2.筛选出的数据搜索条件3.用户已经勾选的数据条件
12.4.1搜索工程搭建
1.mall_service_search导包
2.静态资源导入resource
3.更改配置文件:spring.thymeleaf.cache:false
4.修改Controller类RestController为@Controller,search方法添加@ResponseBody
5.搜索页面修改参数渲染
- xmlns:th="http://thymeleaf.org">
- //动态替换搜索参数
- <li class="active">
- <span th:text="${searchMap.keyword}">span>
- li>
- //条件参数判断替换
- <li class="with-x" th:if="${#maps.containsKey(searchMap,'brand')}">
- 品牌:<span th:text="${searchMap.brand}">span>
- <a th:href="@{${#strings.replace(url,'&brand='+searcMap.brand,'')}}">xa>
- li>
12.4.2品牌信息显示
- //显示聚合查询后的品牌图标
- class="type-wrap logo" th:unless="${#maps.contaionsKey(searchMap,'brand')}"><div class="fl key brand">品牌div><div class="value logos"><ul class="logo-list"><li th:each="brand,brandSate:${result.brandList}"><a th:text="${brand}" th:href="@{${url}(brand=${brand})}">a>li>ul>div>
12.4.3规格信息数据转换
- /**
- * 规格转换
- * "{'颜色':'黄色','版本':'4+64'}"
- * "{'颜色':'蓝色','版本':'4+64'}"
- * "{'颜色':'黄色','版本':'6+128'}"
- * "{'颜色':'蓝色','版本':'6+128'}"
- * *******************
- * 颜色:黄色,蓝色
- * 版本:4+64,6+128
- */
- public Map<String, Set<String>> formatSpec(List<String> specList){
- HashMap<String, Set<String>> resultMap = new HashMap<>();
- for (String specStr : specList) {
- //specStr:"{'颜色':'黄色','版本':'4+64'}"
- Map<String,String> specMap = JSON.parseObject(specStr, Map.class); //颜色:黄色 版本:4+64
- //遍历Map
- for (String key : specMap.keySet()) {
- //key:颜色 value:蓝色
- Set<String> valueSet = resultMap.get(key);
- if(valueSet == null){
- valueSet = new HashSet<>();
- }
- valueSet.add(specMap.get(key));
- resultMap.put(key,valueSet);
- }
- }
- return resultMap;
- }
- "type-wrap" th:each="spec,specStat:${result.specList}" th:unless="${#maps.containsKey(searchMap,'spec_'+spec.key)}">"fl key" th:text="${spec.key}">"fl value">
- "type-list">
- "op,opstat:${spec.value}">
"fl ext">
12.5条件搜索实现:
需求:用户搜索:拼接url/search/list?keywords=包包
点击新规格:拼接url/search/list?keywords=包包&spec_颜色=红色
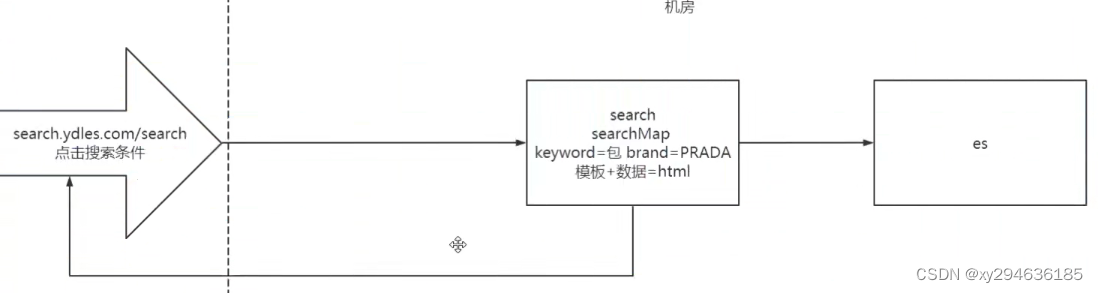
后端代码实现:
- @GetMapping("/list")
- public String List(@RequestParam Map<String, String> searchMap, Model model){
- handleSearchMap(searchMap);
- //搜索结果
- Map resultMap = searchService.search(searchMap);
- model.addAttribute("result",resultMap);
- //用户搜索条件
- model.addAttribute("searchMap",searchMap);
- //记录url 记录这次的搜索条件,前端不会丢失上一次的条件
- StringBuilder url = new StringBuilder("/search/list");
- //判断有没有搜索条件
- if(searchMap!=null && searchMap.size()>0){
- url.append("?");
- for (String key : searchMap.keySet()) {
- //排除一些不需要的搜索条件
- if(!key.equals("sortField")&&!key.equals("sortRule")&&!key.equals("pageNum")&&!key.equals("pageSize")) {
- //searchMap keywords=包包 spec_颜色=黑色
- url.append(key).append("=").append(searchMap.get(key)).append("&");
- }
- }
- String urlString = url.toString();
- urlString.substring(0,urlString.length()-1);//去掉最后的&字符
- model.addAttribute("url",urlString);
- }else{
- model.addAttribute("url",url);
- }
- return "search";
- }
前端url拼接跳转:用户点击相应品牌,规格,价格,跳转请求后端接口。
12.6移除搜索条件
需求:用户点击x去除刚才的搜索条件
- <li class="with-x" th:if="${#maps.containsKey(searchMap,'brand')}">
- 品牌:<span th:text="${searchMap.brand}">span>
- <a th:href="@{${#strings.replace(url,'&brand='+searchMap.brand,'')}}">xa>
- li>
- <li class="with-x" th:if="${#maps.containsKey(searchMap,'price')}">
- 价格:<span th:text="${searchMap.price}">span>
- <a th:href="@{${#strings.replace(url,'&price='+searchMap.price,'')}}">xa>
- li>
- <li class="with-x" th:each="sm,mapStat:${searchMap}" th:if="${#strings.startWith(sm.key,'spec_')}">
- <span th:text="${#strings.replace(sm.key,'sepc_','')}">span> : <span th:text="${#strings.replace(sm.value,'%2B','')}">span>
- <a th:href="@{${#strings.replace(url,'&'+sm.key+'='+sm.value,'')}}">xa>
- li>
12.7排序
需求:用户点击排序字段,返回排好序的内容
修改search.html页面:
- >
12.8分页
基于thymeleaf前后端实现分页
代码:https://gitee.com/xuyu294636185/mall_parent.git
13.商品详情页
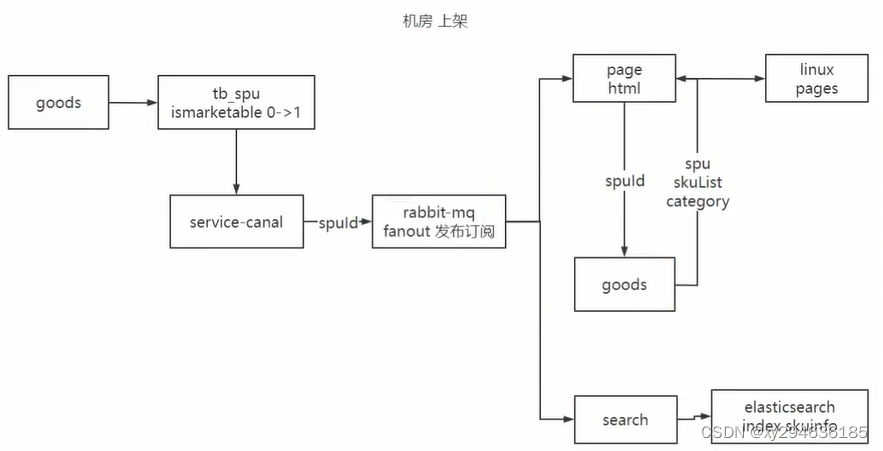
流程:
1.商品上架-》商品服务发送spuid->mq
2.mq->静态页微服务
3.静态页服务->调用商品服务获取spu->生成静态页面
13.1商品静态化微服务创建
该微服务只用于生成视商品静态页。
1.创建静态页服务mall_service_page
2.依赖
3.配置文件
13.2生成静态页
13.2.1需求分析
页面发送请求后,传递要生成的静态页的商品SpuId,后台controller接受请求,调用thymeleaf的原生API生成商品静态页。
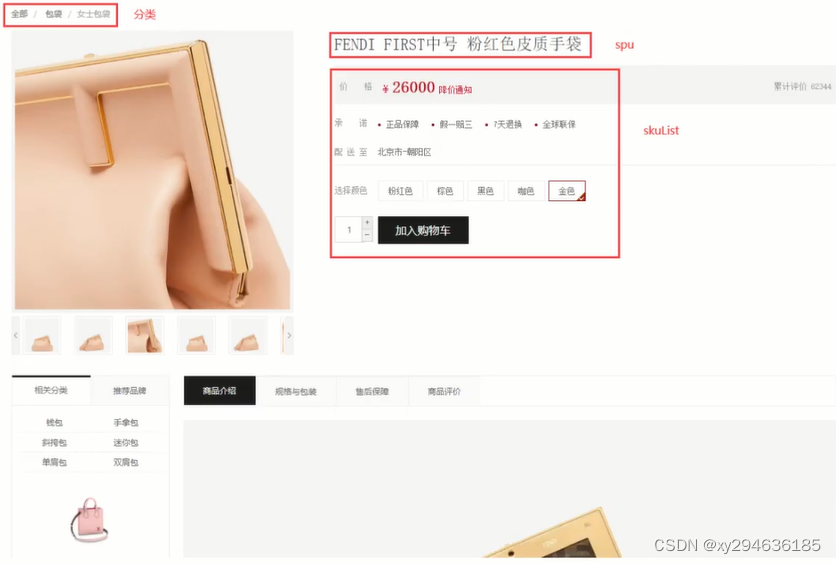
上图是生成的商品详情页,从图片上可看出需要查询SPU的3个分类作为“面包屑”显示,同时还需要查询SKU和SPU信息。
13.2.2Feign创建
需求:查询3部分数据(分类、spu、sku) 资源/静态原型/前台/item.html
1.在goods-api中创建好3个feign。
2.静态页面生成代码
将item.html放到template下。
page模块service层com.mall.page.service
实现com.mall.page.service.impl
- public class PageServiceImpl implements PageService {
- @Autowired
- TemplateEngine templateEngine;
- @Value("${pagepath}")
- String pagepath;
- @Override
- public void generateHtml(String spuId) {
- //1构建上下文,包含模板+数据
- Context context = new Context();
- Map<String, Object> data = getData(spuId);
- context.setVariables(data);
- //2.处理文件
- File dir = new File(pagepath); //文件夹 d:/item
- //如果文件夹不存在,创建
- if (!dir.exists()) {
- dir.mkdirs();
- }
- //d://item/spuid.html
- File file = new File(pagepath + "/" + spuId + ".html");
- Writer writer = null;
- try {
- writer = new FileWriter(file);
- templateEngine.process("item", context, writer);
- } catch (IOException e) {
- e.printStackTrace();
- } finally {
- //关闭流
- try {
- writer.close();
- } catch (IOException e) {
- e.printStackTrace();
- }
- }
- }
- @Autowired
- SpuFeign spuFeign;
- @Autowired
- SkuFeign skuFeign;
- @Autowired
- CategoryFeign categoryFeign;
- //获取数据方法
- public Map<String, Object> getData(String spuId) {
- HashMap<String, Object> resultMap = new HashMap<>();
- //1.spu
- Spu spu = spuFeign.findSpuById(spuId).getData();
- resultMap.put("spu", spu);
- //4.imageList
- String images = spu.getImages();
- if (StringUtils.isNotEmpty(images)) {
- String[] imageList = images.split(",");
- resultMap.put("imageList", imageList);
- }
- //5.specificationList
- String specs = spu.getSpec_items();
- if (StringUtils.isNotEmpty(specs)) {
- Map specMap = JSON.parseObject(specs, Map.class);
- resultMap.put("specificationList", specMap);
- }
- //1.sku
- List<Sku> skuList = skuFeign.findSkuListBySpuId(spuId);
- resultMap.put("skuList", skuList);
- //3.category
- Integer category1_id = spu.getCategory1_id();
- Integer category2_id = spu.getCategory2_id();
- Integer category3_id = spu.getCategory3_id();
- Category category1 = categoryFeign.findById(category1_id).getData();
- Category category2 = categoryFeign.findById(category2_id).getData();
- Category category3 = categoryFeign.findById(category3_id).getData();
- resultMap.put("category1", category1);
- resultMap.put("category2", category2);
- resultMap.put("category3", category3);
- return resultMap;
- }
- }
3.静态页服务监听
config.mall.page.config粘贴canal服务中的配置
- //创建静态页面的队列
- public static final String PAGE_CRATE_QUEUE = "page_create_queue";
- //定义静态页面的队列
- @Bean(PAGE_CRATE_QUEUE)
- public Queue PAGE_CREATE_QUEUE(){
- return new Queue(PAGE_CRATE_QUEUE);
- }
- //创建静态页面的队列和上架交换机关系构建
- @Bean
- public Binding GOODS_UP_EXCHANGE_PAGE_CREATE_QUEUE(
- @Qualifier(PAGE_CRATE_QUEUE)Queue queue,
- @Qualifier(GOODS_UP_EXCHANGE)Exchange exchange
- ){
- return BindingBuilder.bind(queue).to(exchange).with("").noargs();
- }
com.mall.page.listener
- @Component
- public class PageListener {
- @Autowired
- PageService pageService;
- @RabbitListener(queues = RabbitMQConfig.PAGE_CRATE_QUEUE)
- public void receiveMsg(String spuId){
- System.out.println("监听到商品上架了,生成静态页面:"+spuId);
- pageService.generateHtml(spuId);
- }
- }
-
相关阅读:
java学习--day22(进程&线程)
Jumpserver安全一窥:Sep系列漏洞深度解析
Hbase2.4.11安装
AP51656 PWM和线性调光 LED车灯电源驱动IC 兼容替代PT4115 PT4205
计算机视觉 CV 八股分享 [自用](更新中......)
基于多模态视觉模型和图文向量模型的工业图像知识库研究与应用
Jmeter的接口自动化测试
Linux使用tab补全时报没有空间的错
sgu 176 Flow construction (有源汇的上下界最小流)
AutoJs学习-MC我的世界自动钓鱼
- 原文地址:https://blog.csdn.net/xy294636185/article/details/125224561

- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读