-
机器学习实战(3)——分类
目录
1 MNIST数据集
MNIST数据集是一组由美国高中生和人口调查员手写的70 000个数字的图片,每张图像都用其代表的数字标记。
获取MNIST数据集:
- from sklearn.datasets import fetch_openml
- mnist = fetch_openml('mnist_784', version=1, cache=True, as_frame=False)
- mnist["data"],mnist["target"]
运行结果如下:
- (array([[0., 0., 0., ..., 0., 0., 0.],
- [0., 0., 0., ..., 0., 0., 0.],
- [0., 0., 0., ..., 0., 0., 0.],
- ...,
- [0., 0., 0., ..., 0., 0., 0.],
- [0., 0., 0., ..., 0., 0., 0.],
- [0., 0., 0., ..., 0., 0., 0.]]),
- array(['5', '0', '4', ..., '4', '5', '6'], dtype=object))
Scikit-Learm加载的数据集通常具有类似的字典结构,包括:
- DESCR键:描述数据集
- data键:包含一个数组,每个实例为一行,每个特征为一列
- target键:包含一个带有标记的数组
我们来看看这些数组:
- X, y = mnist["data"], mnist["target"]
- X.shape, y.shape
运行结果如下:
((70000, 784), (70000,))共有7万张图片,每张图片有784个特征。图片是28×28像素,每个特征代表一个像素点的强度。
我们随便抓取一个实例的特征向量:
- import matplotlib as mpl
- import matplotlib.pyplot as plt
- # 抓取一个实例的特征向量
- # 提取行数据
- #方法一:
- import numpy as np
- some_digit = np.array(X[36000,])
- #方法二:
- # some_digit = X[36000]
- some_digit_image = some_digit.reshape(28, 28)
- #可视化
- plt.imshow(some_digit_image, cmap = mpl.cm.binary,
- interpolation="nearest")
- plt.axis("off")
- plt.show()
- #查看手写字标签
- y[36000]
运行结果如下:
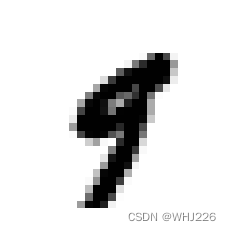
'9'此处运行结果与书上的“5”不一样是由于fetch_openml()返回给我们的是未排序的数据。
这里我们不需要创建测试集,因为MNIST数据集已经分成训练集(前6万张图像)和测试集(后1万张图像)了:
X_train, X_test, y_train, y_test = X[:60000], X[60000:], y[:60000], y[60000:]同样,我们需要先将训练数据洗牌,这样能保证交叉验证时所有的折叠都差不多(避免机器学习算法对训练实例的顺序敏感)。
- import numpy as np
- # 训练集随机重新排列
- shuffle_index = np.random.permutation(60000)
- X_train,y_train = X_train[shuffle_index], y_train[shuffle_index]
2 训练一个二元分类器
现在,我们先简化问题,只尝试识别一个数字——比如数字9。那么这个“数字9检测器” 就是一个二元分类器的例子,它只能区分两个类别:9和非9。先为此分类任务创建目标向量:
- # 先尝试识别一个数字
- y_train_9 = (y_train == '9')
- y_test_9 = (y_test == '9')
接着挑选一个分类器并开始训练。一个好的初始选择是随机梯度下降(SGD(stochastic gradient descend))分类器, 使用 Scikit-Learn的SGDClassifier类即可。这个分类器的优势是,能够有效处理非常大型的数据集。这部分是因为SGD独立处理训练实例,一次一个(这也使得SGD非常适合在线学习)。此时先创建一个SGDClassifier并在整个训练集上进行训练:
- from sklearn.linear_model import SGDClassifier
- # sgd_clf = SGDClassifier(max_iter=9, tol=-np.infty, random_state=42)
- # sgd_clf.fit(X_train, y_train_9)
- sgd_clf = SGDClassifier(random_state=42)
- sgd_clf.fit(X_train, y_train_9)
运行结果如下:
SGDClassifier(random_state=42)由于SGDClassifier在训练时是完全随机的,如果我们每次运行想要得到相同的结果,需要设置随机数种子该参数random_state。max_iter=9, tol=-np.infty与random_state作用相同。
现在我们检验一下:
sgd_clf.predict([some_digit])运行结果如下:
array([False])分类器不认为这个图像是5,显然预测错了,下面评估一下这个模型的性能。
3 性能考核
3.1 使用交叉验证测量精度
交叉验证是一个评估模型的好办法。我们先看一下cross_val_score验证后的模型得分,采用K-flod交叉验证法,3个折叠(将训练集分成3个折叠,每次留其中一个折叠进行预测,剩余折叠用于训练):
- from sklearn.model_selection import cross_val_score
- cross_val_score(sgd_clf, X_train, y_train_9, cv=3, scoring="accuracy")
运行结果如下:
array([0.948 , 0.93885, 0.91695])虽然准确率都超过了90%,但是准确率通常不能作为分类器的首要性能指标。下面让我们看一下蠢笨的分类器(它将每张图都分类成“非9”):
- from sklearn.base import BaseEstimator
- class Never9Classifier(BaseEstimator):
- def fit(self, X, y=None):
- pass
- def predict(self, X):
- return np.zeros((len(X), 1), dtype=bool)
- never_9_clf = Never9Classifier()
- cross_val_score(never_9_clf, X_train, y_train_9, cv=3, scoring="accuracy")
运行结果如下:
array([0.90075, 0.90135, 0.90045])没错,准确率都在90%以上,因为只有大约10%的图像数字是9。
拓展:
实施交又验证
相比于cross_val_score()这一类交叉验证的函数,有时我们可能希望自己能控制得多一些。在这种情况下,可以自行实施交叉验证,操作也简单明了。下面这段代码与前面的cross_val_score()大致相同:
- from sklearn.model_selection import StratifiedKFold
- from sklearn.base import clone
- skfolds = StratifiedKFold(n_splits=3, random_state=42, shuffle=True)
- for train_index, test_index in skfolds.split(X_train, y_train_9):
- clone_clf = clone(sgd_clf)
- X_train_folds = X_train[train_index]
- y_train_folds = (y_train_9[train_index])
- X_test_fold = X_train[test_index]
- y_test_fold = (y_train_9[test_index])
- clone_clf.fit(X_train_folds, y_train_folds)
- y_pred = clone_clf.predict(X_test_fold)
- n_correct = sum(y_pred == y_test_fold)
- print(n_correct / len(y_pred))
运行结果如下:
- 0.91665
- 0.94065
- 0.94005
每个折叠由StratifiedKFold执行分层抽样产生,其所包含的各个类的比例符合整体比例。每个迭代会创建一个分类器的副本,用训练集对这个副本进行训练,然后用测试集进行预测。最后计算正确预测的次数,输出正确预测的比率。
3.2 混淆矩阵
混淆矩阵是评估分类器性能最好的方法。要计算混淆矩阵,需要先有一组预测才能将其与实际目标进行比较。当然可以通过测试集来进行预测,但是我们现在最好不要动测试集(测试集最好留在项目最后,准备启动分类器时再使用),这里我们使用cross_val_predict()函数:
- from sklearn.model_selection import cross_val_predict
- y_train_pred = cross_val_predict(sgd_clf, X_train, y_train_9, cv=3)
与cross_val_score()函数一样,cross_val_predict()函数同样执行K-fold交叉验证,但是返回的不是评估分数而是每个折叠的预测,这意味着对于每个实例都可以得到一个干净的预测(“干净”的意思是模型预测时使用的数据是训练期间从未出现过的)。
现在,我们可以使用confusion_matrix()函数来获取混淆矩阵,只需要给出目标类别(y_train_9)和预测类别(y_train_pred):
- from sklearn.metrics import confusion_matrix
- confusion_matrix(y_train_9, y_train_pred)
运行结果如下:
- array([[53463, 588],
- [ 3204, 2745]], dtype=int64)
混淆矩阵 预测结果 正例 假例 真实结果 正例 53463 588 假例 3204 2745 混淆矩阵的行表示实际类别、列表示预测类别。从结果看,本例中第一行表示所有“非9”(负类即表中正例)的图片中:53463张被正确地划分为“非9”类别(真负类),588张被错误地分类成“9”(假正类);第二行表示所有“9”(正类及表中假例)的图片中:3204张被错误地划分为“非9”类别(假负类),2745张被正确地分类成“9”(真正类)。一个完美的分类器只有真正类和真负类,所以它的混淆矩阵只会在其对角线上有非零值:
- y_train_perfect_predictions = y_train_9
- confusion_matrix(y_train_9, y_train_perfect_predictions)
运行结果如下:
- array([[54051, 0],
- [ 0, 5949]], dtype=int64)
-
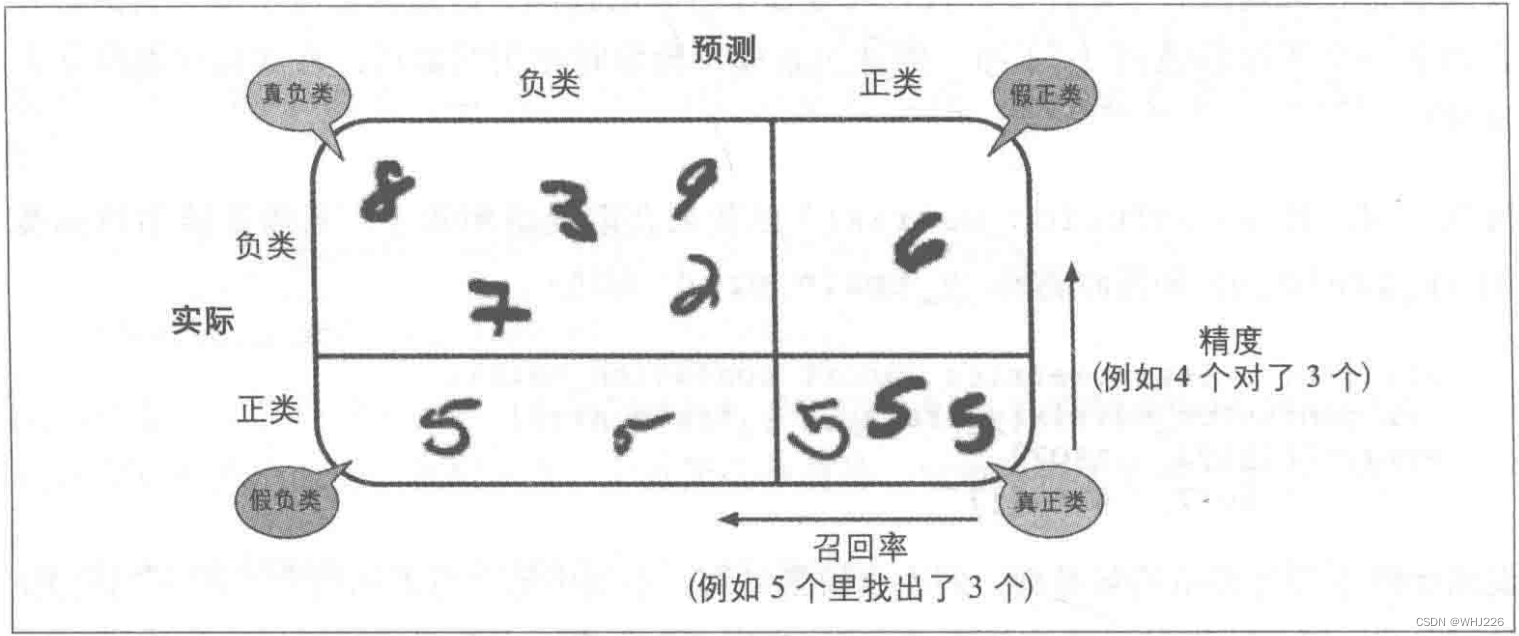
正类预测的准确率是一个很有意思的指标,它也称为分类器的精度:
精度 = TP/(TP+FP)
TP是真正类的数量,FP是假正类的数量。
而精度通常与另一个指标一起使用,这个指标就是召回率,也称灵敏度或者真正类率:它是分类器正确检测到的正类实例的比率。
召回率 = TP/(TP+FN)
FN是假负类的数量。
我们可以通过下图加深对混淆矩阵的理解。(图中是识别数字“5”)
3.3 精度和召回率
- from sklearn.metrics import precision_score, recall_score
- precision_score(y_train_9, y_train_pred)#2745 / (2745 + 588)
运行结果如下:
0.8235823582358236recall_score(y_train_9, y_train_pred)#2745 / (2745 + 3204)运行结果如下:
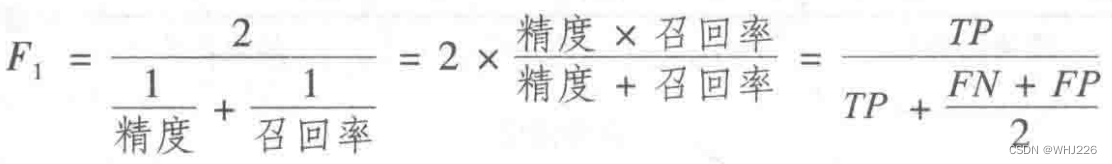
0.46142208774583965现在看来,当它说一张图片是9时,只有82%的时间是准确的,并且只有46%的数字9被它检测出来。因此,我们可以将精度和召回率组合成一个单一的指标,成为F1分数。F1分数是精度和召回率的谐波平均值。正常的平均值平等对待所有的值,而谐波平均值会给予较低的值更高的权重。
F1分数:
计算F1分数,只需要调用f1_score()即可:
- from sklearn.metrics import f1_score
- f1_score(y_train_9, y_train_pred)
运行结果如下:
0.7306867872760011F1分数对那些具有相近的精度和召回率的分类器更为有利。在某些情况下,我们更关心的是精度,而另一些情况下,我们可能更关心召回率。例如,假设你训练一个分类器来检测儿童可以放心观看的视频,那么你可能更青昧那种拦截了很多好视频(低召回率),但是保留下来的视频都是安全(高精度)的分类器,而不是召回率虽高,但是在产品中可能会出现一些非常糟糕的视频的分类器(这种情况下,你甚至可能会添加一个人工流水线来检查分类器选出来的视频)。反过来说,如果你训练一个分类器通过图像监控来检测小偷:你大概可以接受精度只有30%,只要召回率能达到99%(当然,安保人员会收到一些错误的警报,但是几乎所有的窃贼都在劫难逃)。但是我们呢不能同时增加精度并减少召回率,反之亦然。这称为精度/召回率权衡。
3.4 精度/召回率权衡
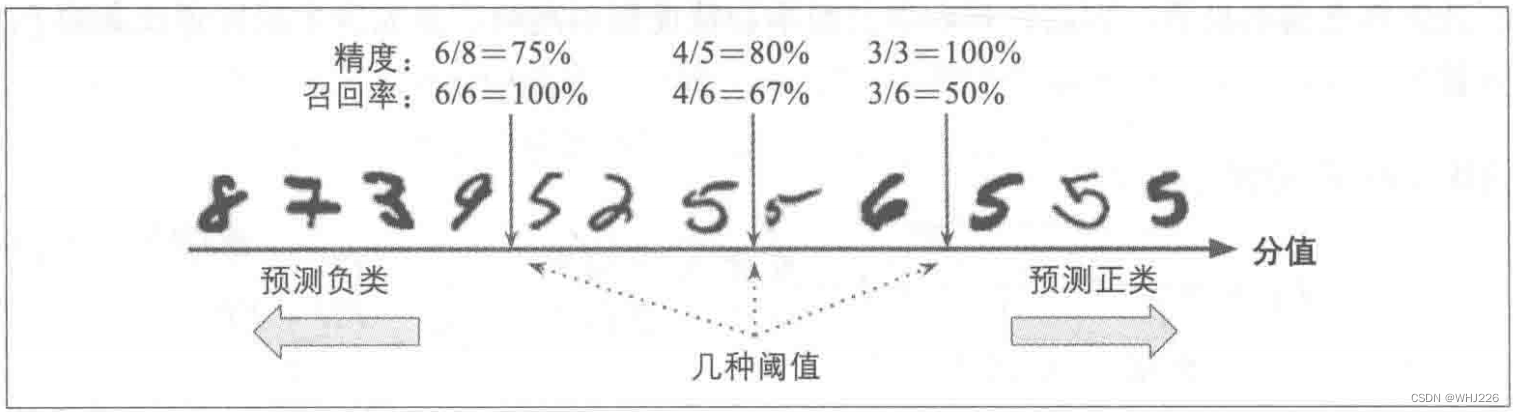
要理解这个权衡过程,我们来看看SGDClassifier如何进行分类决策。对于每个实例,它会基于决策函数计算出一个分值,如果该值大于阈值,则将该实例判为正类,否则便将其判为负类。下图显示了从左边最低分到右边最高分的几个数字。假设决策阈值位于中间箭头位置(两个5之间):在阈值的右侧可以找到4个真正类(真的5),一个假正类(实际上是6)。因此,在该阈值下,精度为80%(4/5)。但是在6个真正的5中, 分类器仅检测到了4个,所以召回率为67%(4/6)。现在,如果提高阈值(将其挪动到右边箭头的位置),假正类(数字6)变成了真负类,因此精度得到提升(本例中提升到 100%),但是一个真正类变成一个假负类,召回率降低至50%。反之,降低阈值则会在增加召回率的同时降低精度。
Scikit-Learn不允许直接设置阈值,但是可以访问它用于预测的决策分数。不是调用分类器的predict()方法,而是调用decision_function()方法,这个方法返回每个实例的分数,然后就可以根据这些分数,使用任意阈值进行预测了:
- y_scores = sgd_clf.decision_function([some_digit])
- y_scores
运行结果如下:
array([-1351.48415721])SGDClassifier分类器使用的阈值是0,所以前面的代码返回结果与predict()方法一样:
- threshold = 0
- y_some_digit_pred = (y_scores > threshold)
- y_some_digit_pred
运行结果如下:
array([False])我们试试来改变阈值:
- threshold = -10000
- y_some_digit_pred = (y_scores > threshold)
- y_some_digit_pred
运行结果如下:
array([ True])我们这张图确实是数字9,但是当阈值为0时,分类器没有检测出来,当阈值为-10000时却检测出来了(通常提高阈值可以降低召回率,与我们本例中降低阈值提升召回率是一致的),那么我们该如何决定使用什么阈值呢?
首先,使用cross_val_predict()函数获取训练集中所有实例的分数,但是这次需要它返回的是决策分数而不是预测结果:
- y_scores = cross_val_predict(sgd_clf, X_train, y_train_9, cv=3,
- method="decision_function")
注意:在Scikit-Learn 0.19.0中有一个问题(在0.19.1中修复),当使用method="decision_function"时,在二进制分类情况下cross_val_predict()的结果是不正确的,就像上面的代码一样。得到的数组有一个额外的第一个维度,全是0。
如果在Scikit-Learn 0.19.0中,我们需要添加一些代码来解决这个问题:
- # hack to work around issue #9589 in Scikit-Learn 0.19.0
- if y_scores.ndim == 2:
- y_scores = y_scores[:, 1]
有了这些分数,我们可以使用precision_recall_curve()函数来计算所有可能的阈值的精度和召回率:
- from sklearn.metrics import precision_recall_curve
- precisions, recalls, thresholds = precision_recall_curve(y_train_9, y_scores)
我们可以使用Matplotlib绘制精度和召回率相对于阈值的函数图:
- def plot_precision_recall_vs_threshold(precisions, recalls, thresholds):
- plt.plot(thresholds, precisions[:-1], "b--", label="Precision", linewidth=2)
- plt.plot(thresholds, recalls[:-1], "g-", label="Recall", linewidth=2)
- plt.xlabel("Threshold", fontsize=16)
- plt.legend(loc="upper left", fontsize=16)
- plt.ylim([0, 1])
- plt.figure(figsize=(8, 4))
- plot_precision_recall_vs_threshold(precisions, recalls, thresholds)
- plt.xlim([-700000, 700000])
- plt.show()
运行结果如下:
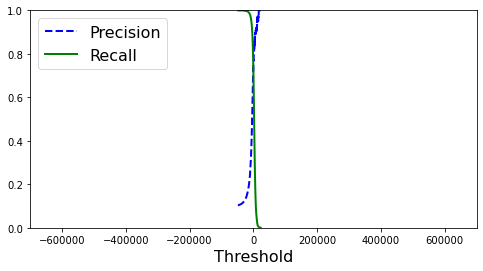
这个图不能体现精度和召回率之间的相对关系,我们看一下书中对数字5预测的图:
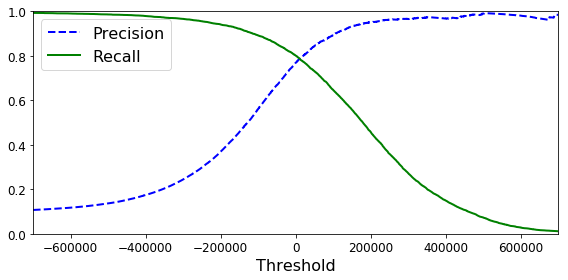
为什么在上图中精度曲线比召回率曲线要崎呕一些?原因在于,当你提高阈值时,精度有时也有可能会下降(尽管总体趋势是上升的)。要理解原因,可以回头看图3.4的图,注意,当把阈值从中间箭头往右移动一位数时:精度从4/5(80%)下降到3/4(75%)。另一方面,当阈值上升时,召回率只会下降,这就解释了为什么召回率的曲线看起来很平滑。
我们还有一种找到好的精度/召回率权衡的方法是直接绘制精度和召回率函数图:
- def plot_precision_vs_recall(precisions, recalls):
- plt.plot(recalls, precisions, "b-", linewidth=2)
- plt.xlabel("Recall", fontsize=16)
- plt.ylabel("Precision", fontsize=16)
- plt.axis([0, 1, 0, 1])
- plt.figure(figsize=(8, 6))
- plot_precision_vs_recall(precisions, recalls)
- plt.show()
运行结果如下:
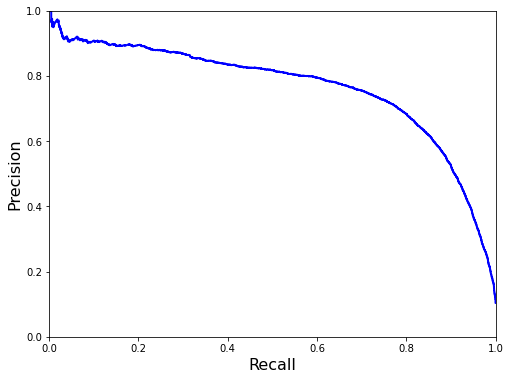
从图中可以看到,从80%的召回率往右,精度开始急剧下降。我们可能尽量在这个陡降之前选择一个精度/召回率权衡——比如召回率70%,具体如何选择还是取决于我们的项目。
假设你决定瞄准90%的精度目标。通过放大图像,得出需要使用的阈值大概是10 000。要进行预测(现在是在训练集上),除了调用分类器的predict()方法,我们还可以运行这段代码:
y_train_pred_90 = (y_scores > 10000)我们检测一下预测结果的精度和召回率:
precision_score(y_train_9, y_train_pred_90)运行结果如下:
0.9075907590759076召回率:
recall_score(y_train_9, y_train_pred_90)运行结果如下:
0.046226256513699784如你所见,创建任意一个我们想要精度的分类器是相当容易的:只要阈值足够高即可(在范围内)。然而召回率太低的话,精度再高,也不怎么有用。
因此,如果有人说:“我们需要99%的精度”。我们就问:“召回率是多少?”
3.5 ROC曲线
还有一种经常与二元分类器一起使用的工具,叫作受试者工作特征曲线(ROC)。它与精度/召回率曲线非常相似,但绘制的不是精度和召回率,而是真正类率(召回率的另一名称)和假正类率(FPR)。FPR是被错误分为正类的负类实例比率。它等于1减去真负类率(TNR),后者是被正确分类为负类的负类实例比率,也称为特异度。因此,ROC曲线绘制的是灵敏度和(1-特异度)的关系。
绘制ROC曲线,首先需要使用roc_curve()函数计算多种阈值的TPR和FPR:
- from sklearn.metrics import roc_curve
- fpr, tpr, thresholds = roc_curve(y_train_9, y_scores)
然后,使用Matplotlib绘制FPR对TPR的曲线。
- def plot_roc_curve(fpr, tpr, label=None):
- plt.plot(fpr, tpr, linewidth=2, label=label)
- plt.plot([0, 1], [0, 1], 'k--')
- plt.axis([0, 1, 0, 1])
- plt.xlabel('False Positive Rate', fontsize=16)
- plt.ylabel('True Positive Rate', fontsize=16)
- plt.figure(figsize=(8, 6))
- plot_roc_curve(fpr, tpr)
- plt.show()
运行结果如下:
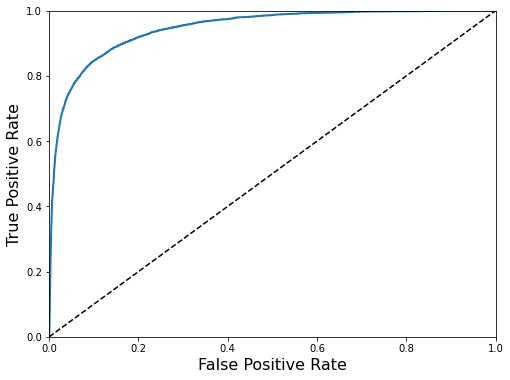
这里我们再次面临一个折中权衡:召回率(TPR)越高,分类器产生的假正类(FPR)就越多。虚线表示纯随机分类器的ROC曲线,一个优秀的分类器应该离这条线越远越好。有一种比较分类器的方法是测量曲线下面积(AUC)。完美的分类器的ROC AUC等于1,而纯随机分类器的ROC AUC等于0.5。
- from sklearn.metrics import roc_auc_score
- roc_auc_score(y_train_9, y_scores)
运行结果如下:
0.9458988166231964注意:由于ROC曲线与精度/召回率(或PR)曲线非常相似,如何决定使用哪种曲线。有一个经验法则是,当正类非常少见或者你更关注假正类而不是假负类时,你应该选择PR曲线,反之则是ROC曲线。例如,看前面的ROC曲线图(以及ROC AUC分数),你可能会觉得分类器真不错。但这主要是因为跟负类(非9)相比,正类(数字9)的数量真得很少。相比之下,PR曲线清楚地说明分类器还有改进的空间(曲线还可以更接近右上角)。
训练一个RandomForestClassifier分类器,并比较它和SGDClassifier分类器的ROC曲线和ROC AUC分数。首先,获取训练集中每个实例的分数。但是由于它的工作方式不同,RandomForestClassifier类没有decision_function()方法,相反,它有dict_proba()方法。dict_proba()方法会返回一个数组,其中每一行为一个实例,每列代表一个类别,意思是某个给定实例属于某个给定类别的概率(例如,这张图片有70%的可能是数字9):
- from sklearn.ensemble import RandomForestClassifier
- forest_clf = RandomForestClassifier(n_estimators=10, random_state=42)
- y_probas_forest = cross_val_predict(forest_clf, X_train, y_train_9, cv=3,
- method="predict_proba")
但是绘制ROC曲线需要的是分数值不是概率大小,这里可以使用正类的概率作为分数值:
- y_scores_forest = y_probas_forest[:, 1] # score = proba of positive class
- fpr_forest, tpr_forest, thresholds_forest = roc_curve(y_train_9,y_scores_forest)
现在我们看一下对比结果:
- plt.figure(figsize=(8, 6))
- plt.plot(fpr, tpr, "b:", linewidth=2, label="SGD")
- plot_roc_curve(fpr_forest, tpr_forest, "Random Forest")
- plt.legend(loc="lower right", fontsize=16)
- plt.show()
运行结果如下:
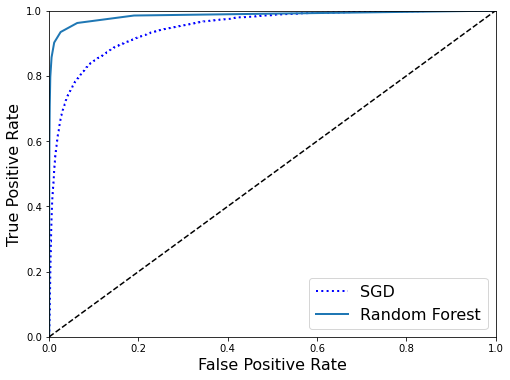
RandomForestClassifier的ROC曲线看起来比SGDClassifier好,因为离左上角更近,我们看一下它的ROC AUC分数:
roc_auc_score(y_train_9, y_scores_forest)运行结果如下:
0.9854689201269508精度:
- y_train_pred_forest = cross_val_predict(forest_clf, X_train, y_train_9, cv=3)
- precision_score(y_train_9, y_train_pred_forest)
0.9727123512515388召回率:
recall_score(y_train_9, y_train_pred_forest)0.7969406622961842从结果看,还不错!
4 多类别分类器
多类别分类器(多项分类器)可以区分两个以上的类别。有一些算法(如随机森林分类器或朴素贝叶斯分类器)可以直接处理多个类别,也有一些严格的二元分类器(支持向量机分类器或线性分类器)。但是,我们也可以使用多个二元分类器实现多类别分类的目的。
例如,要创建一个系统将数字图片分为10类(0到9),一种方法是训练10个二元分类器,每个数字一个。然后,当我们需要对一张图片进行检测分类时,获取每个分类器的决策分数,哪个分类器给分最高,就将其分为哪个类,这称为一对多策略(OvA)。
另一种方法是,为每一对数字训练一个二元分类器:一个用于区分0和1,一个区分0和2,一个区分1和2,以此类推。这称为一对一策略(OvO)。如果存在N个类别,那么这需要训练N×(N-1)/2个分类器。该方法的主要优点在于,每个分类器只需要用到部分训练集对其必须区分的两个类别进行训练。
Scikit-learn可以检测到我们尝试使用二元分类算法进行多类别分类任务,它会自动运行OvA。我们用SGDClassifier试试:
- sgd_clf.fit(X_train, y_train) #y_train,not y_train_5
- sgd_clf.predict([some_digit])
运行结果如下:
array(['4'], dtype='这段代码使用原始目标类别0到9(y_train)在训练集上对SGDClassifier进行训练,而不是以“9”和“剩余”作为目标类别(y_train_9)。然后做出预测(在本例中预测错误)。在内部,Scikit-learn实际上训练了10个二元分类器,获得它们对图片的决策分数,然后选择了分数最高的类别。
我们可以调用decision_function()方法。它会返回10个分数,每个类别1个,而不再是每个实例返回一个分数:
- some_digit_scores = sgd_clf.decision_function([some_digit])
- some_digit_scores
运行结果如下:
- array([[-29325.59971196, -17810.72422839, -19628.01026959,
- -2228.45212524, -131.91063058, -8234.45547888,
- -35566.19680838, -8869.8020588 , -6810.76461902,
- -2122.93093924]])
但是最高分数对应的类别是4这个类别:
np.argmax(some_digit_scores)运行结果如下:
4如果想要强制Scikit-Learn使用一对一或者一对多策略,可以使用OneVsOneClassifier或 OneVsRestClassifier类。只需要创建一个实例,然后将二元分类器传给其构造函数。例如,下面这段代码使用Ovo策略,基于SGDClassifier创建 了一个多类别分类器:
- from sklearn.multiclass import OneVsOneClassifier
- ovo_clf = OneVsOneClassifier(SGDClassifier(random_state=42))
- ovo_clf.fit(X_train, y_train)
- ovo_clf.predict([some_digit])
运行结果如下:
array(['9'], dtype=object)len(ovo_clf.estimators_)运行结果如下:
45训练RandomForestClassifier 同样简单:
- forest_clf.fit(X_train, y_train)
- forest_clf.predict([some_digit])
运行结果如下:
array(['9'], dtype=object)这次Scikit-Learn不必运行OvA或者OvO了,因为随机森林分类器直接就可以将实例分为多个类别。调用 predict_proba()可以获得分类器将每个实例分类为每个类别的概率列表:
forest_clf.predict_proba([some_digit])运行结果如下:
array([[0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]])数组中1意味着该模型估计图片代表数字9的概率为100%。
这时,你当然想要评估这些分类器。跟之前一样,使用交叉验证。我们来试试使用 cross_val_score()函数评估一下SGDClassifier的准确率:
cross_val_score(sgd_clf, X_train, y_train, cv=3, scoring="accuracy")运行结果如下:
array([0.8768 , 0.8659 , 0.87845])在所有的测试折叠上都超过了86%。如果是一个纯随机分类器,准确率大概是10%,所以这个结果不是太糟,但是依然有提升的空间。例如,,将输入进行简单缩放可以将准确率提到90%以上:
- from sklearn.preprocessing import StandardScaler
- scaler = StandardScaler()
- X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
- cross_val_score(sgd_clf, X_train_scaled, y_train, cv=3, scoring="accuracy")
运行结果如下:
array([0.8986, 0.9021, 0.8993])5 错误分析
假设你已经找到了一个有潜力的模型,现在你希望找到一些方法对其进一步改进。方法之一就是 分析其错误类型。首先,看看混淆矩阵。就像之前做的,使用cross_val_predict()函数进行预测, 然后调用confusion_matrix()函数:
- y_train_pred = cross_val_predict(sgd_clf, X_train_scaled, y_train, cv=3)
- conf_mx = confusion_matrix(y_train, y_train_pred)
- conf_mx
运行结果如下:
- array([[5602, 0, 16, 7, 7, 40, 34, 7, 209, 1],
- [ 1, 6411, 46, 18, 3, 42, 4, 7, 196, 14],
- [ 21, 28, 5258, 89, 71, 25, 66, 39, 349, 12],
- [ 25, 19, 115, 5232, 1, 197, 29, 38, 407, 68],
- [ 11, 14, 38, 8, 5247, 11, 40, 22, 302, 149],
- [ 29, 21, 35, 157, 53, 4430, 80, 19, 533, 64],
- [ 26, 16, 52, 3, 43, 87, 5553, 7, 131, 0],
- [ 20, 16, 52, 27, 49, 7, 5, 5711, 178, 200],
- [ 18, 62, 42, 95, 2, 123, 32, 7, 5427, 43],
- [ 23, 20, 26, 63, 125, 29, 1, 178, 355, 5129]],
- dtype=int64)
数字有点多,使用Matplotlib的matshow()函数来查看混涌矩阵的图像表示:
- plt.matshow(conf_mx, cmap=plt.cm.gray)
- plt.show()
运行结果如下:
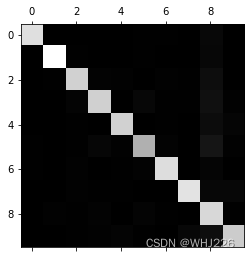
混淆矩阵看起来很不错,因为大多数图片都在主对角线上,这说明它们被正确分类。数字9看起来比其他数字稍稍暗一些,这可能意味着数据集中数字5的图片较少,也可能是分类器在数字9上的执行效果不如在其他数字上好。实际上,你可能会验证这两者都属实。让我们把焦点放在错误上。首先,你需要将混清矩阵中的每个值除以相应类别中的图片数量,这样你比较的就是错误率而不是错误的绝对值(后者对图片数量较多的类别不公平):
- row_sums = conf_mx.sum(axis=1, keepdims=True)
- norm_conf_mx = conf_mx / row_sums
用0填充对角线,只保留错误,重新绘制结果:
- np.fill_diagonal(norm_conf_mx, 0)
- plt.matshow(norm_conf_mx, cmap=plt.cm.gray)
- plt.show()
运行结果如下:
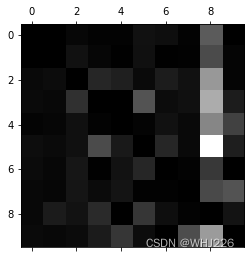
现在可以清晰地看到分类器产生的错误种类了。每行代表实际类别,而每列表示 预测类别。第8列和整体看起来非常亮,说明有许多图片被错误地分类为数字8了。
分析混淆矩阵通常可以帮助你深入了解如何改进分类器。通过上面那张图来看,你的精力可以花在改进数字8分类。例如,可以试着收集更多这些数字的训练数据。或者,也可以开发一些新特征来改进分类器举个例子,写一个算法来计算闭环的数量(例如,数字8有两个,数字6有一个,数字5没有)。再或者,还可以对图片进行预处理(例如,使用Scikit-Image, Pillow或 OpenCV)让某些模式更为突出,比如闭环之类的。
分析单个的错误也可以为分类器提供洞察:它在做什么?它为什么失败?但这通常更加困难和耗时。例如,我们来看看数字3和数字5的例子:- import matplotlib as mpl
- def plot_digits(instances,images_per_row=10,**options):
- size=28
- # 每一行有一个
- image_pre_row=min(len(instances),images_per_row)
- images=[instances.reshape(size,size) for instances in instances]
- # 有多少行
- n_rows=(len(instances)-1) // image_pre_row+1
- row_images=[]
- n_empty=n_rows*image_pre_row-len(instances)
- images.append(np.zeros((size,size*n_empty)))
- for row in range(n_rows):
- # 每一次添加一行
- rimages=images[row*image_pre_row:(row+1)*image_pre_row]
- # 对添加的每一行的图片左右连接
- row_images.append(np.concatenate(rimages,axis=1))
- # 对添加的每一列图片 上下连接
- image=np.concatenate(row_images,axis=0)
- plt.imshow(image,cmap=mpl.cm.binary,**options)
- plt.axis("off")
- cl_a, cl_b = '3', '5'
- X_aa = X_train[(y_train == cl_a) & (y_train_pred == cl_a)]
- X_ab = X_train[(y_train == cl_a) & (y_train_pred == cl_b)]
- X_ba = X_train[(y_train == cl_b) & (y_train_pred == cl_a)]
- X_bb = X_train[(y_train == cl_b) & (y_train_pred == cl_b)]
- plt.figure(figsize=(8,8))
- # np.array()
- plt.subplot(221); plot_digits(np.array(X_aa[:25]), images_per_row=5)
- plt.subplot(222); plot_digits(np.array(X_ab[:25]), images_per_row=5)
- plt.subplot(223); plot_digits(np.array(X_ba[:25]), images_per_row=5)
- plt.subplot(224); plot_digits(np.array(X_bb[:25]), images_per_row=5)
- plt.show()
运行结果如下:
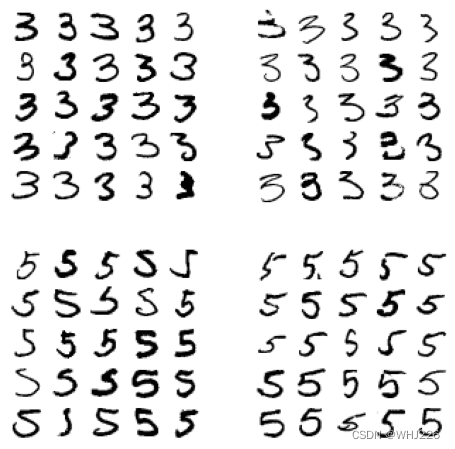
左侧的两个5×5矩阵显示了被分类为数字3的图片,右侧的两个5×5矩阵显示了被分类为数字5的图片。分类器弄错的数字(即左下方和右上方的矩阵)里,确实有一些写得非常糟糕,即便是人类也很难做出区分(例如,第10行第2列的数字5看起来真的很像数字3)。然而,对我们来说,大多数错误分类的图片看起来还是非常明显的错误,我们很难理解分类器为什么会弄错。原因在于,我们使用的简单的SGDClassifier 模型是一个线性模型。它所做的就是为每个像素分配一个各个类别的权重,当它看到新的图像时,将加权后的像素强度汇总,从而得到一个分数进行分类。而数字3和数字5只在一部分像素位上有区别,所以分类器很容易将其弄混。
数字3和数字5之间的主要区别是在于连接顶线和下方弧线的中间那段小线条的位置。如果你写的数字3将连接点略往左移,分类器就可能将其分类为数字5,反之亦然。换言之,这个分类器对图像移位和旋转非常敏感。因此,减少数字3和数字5混淆的方法之一,就是对图片进行预处理,确保它们位于中心位置并且没有旋转。这也同样有助于减少其他错误。6 多标签分类
在某些情况下,你希望分类器为每个实例产出多个类别。例如,人脸识别的分类器:如果在一张照片里识别出多个人怎么办?当然,应该为识别出来的每个人都附上一个标签。假设分类器经过训练,已经可以识别出三张脸——小明、小红和小李,那么当看到一小明丝和小李的照片时,它应 该输出[1, 0, 1],这种输出多个二元标签的分类系统称为多标签分类系统。让我们来看一个更为简单的例子:
- from sklearn.neighbors import KNeighborsClassifier
- # 是否大于7
- y_train_large = ((y_train == '7')|(y_train=='8')|(y_train=='9'))
- # 是否为奇数
- y_train_odd = ((y_train =='1')|(y_train =='3')|(y_train =='5')|(y_train =='7')|(y_train =='9'))
- # 创建一个KNeighborsClassifier 实例,然后使用多个目标对它进行训练
- y_multilabel = np.c_[y_train_large,y_train_odd]
- knn_clf=KNeighborsClassifier()
- knn_clf.fit(X_train,y_multilabel)
这段代码会创建一个y_multilabel数组,其中包含两个数字图片的目标标签:第一个表示数字是否是大数(7、8、9),第二个表示是否为奇数。下一行创建一个 KNeighborsClassifier实例(它支持多标签分类,不是所有的分类器都支持),然后使用多个目标数组对它进行训练。现在用它做一个预测,注意它输出的两个标签:
knn_clf.predict([some_digit])运行结果如下:
array([[ True, True]])就结果来看是正确的,因为数字9是大数且为奇数。
评估多标签分类器的方法很多,如何选择正确的度量指标取决于你的项目。比如方法之一是测量每个标签的F1分数(或者是之前讨论过的任何其他二元分类器指标),然后简单地平均。下面这段代码计算所有标签的平均F1分数:
- y_train_knn_pred = cross_val_predict(knn_clf, X_train, y_multilabel, cv=3, n_jobs=-1)
- f1_score(y_multilabel, y_train_knn_pred, average="macro")
运行结果如下:
0.97709078477525这里假设了所有的标签都同等重要,但实际可能不是这样。特别是,如果训练的照片里小明比小李和小红要多很多,你可能想给区分小明的分类器更高的权重。一个简单的办法是给每个标签设置一个等于其自身支持的权重(也就是具有该目标标签的实例的数量)。只需要在上面的代码中设置average="weighted"即可。
7 多输出分类
多输出-多类别分类(多输出分类),它是多标签分类的泛化,其标签也可以是多种类别的(比如它可以有两 个以上可能的值)。为了说明这一点,构建一个系统去除图片中的噪声。给它输人一张有噪声的图片,它将 (希望)输出一张干净的数字图片,跟其他MNIST图片一样,以像素强度的一个数组作为呈现方式。注意,这个分类器的输出是多个标签(一个像素点一个标签),每个标签可以有多个值(像素强度范围为0到225)。所以这是个多输出分类器系统的例子。
还先从创建训练集和测试集开始,使用NumPy的randint()函数为MNIST 图片的像素强度增加噪声。目标是将图片还原为原始图片:
- def plot_digit(data):
- data=np.array(data)
- image = data.reshape(28, 28)
- plt.imshow(image, cmap = matplotlib.cm.binary,
- interpolation="nearest")
- plt.axis("off")
- noise = np.random.randint(0, 100, (len(X_train), 784))
- X_train_mod = X_train + noise
- noise = np.random.randint(0, 100, (len(X_test), 784))
- X_test_mod = X_test + noise
- y_train_mod = X_train
- y_test_mod = X_test
- some_index = 5500
- plt.subplot(121); plot_digit(X_test_mod[some_index])
- plt.subplot(122); plot_digit(y_test_mod[some_index])
- plt.show()
运行结果如下:(程序未跑出结果,日后补上)
左边是有噪声的输入图片,右边是干净的目标图片。现在通过训练分类器,清洗这张图片:
- knn_clf.fit(X_train_mod, y_train_mod)
- clean_digit = knn_clf.predict([X_test_mod[some_index]])
- plot_digit(clean_digit)
- save_fig("cleaned_digit_example_plot")
运行结果如下:(程序未跑出结果,日后补上)
学习笔记——《机器学习实战:基于Scikit-Learn和TensorFlow》
-
相关阅读:
力扣(LeetCode)882. 细分图中的可到达节点(C++)
前端框架海洋:如何破浪前行,寻找你的“黄金舟”
vue3中组件没有被调用,没进去也没报错
基于SuperMap iObjects C++之最佳路径分析
dashboard报错 错误:无法获取网络列表、dashboard报错 错误:无法获取云主机列表 解决流程
2022年《一生一系统作业》python练习题
Pan-cancer image-based detection of clinically actionable genetic alternations
jieba
【机器学习】符号主义类模型:解码智能的逻辑之钥
ubuntu 22.04 图文安装
- 原文地址:https://blog.csdn.net/WHJ226/article/details/126295282

- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读