-
Spark 源码分析-FIFO/FAIR调度策略
一、前提描述
spark runJob作业提交的时候有两种调度策略:FIFO/FAIR 。
这两种调度可以通过sparkConf配置进行选择,那么这两个调度作用是啥呢?
在DAGScheluer对job划分好stage并以TaskSet的形式提交给TaskScheduler后,TaskScheduler的实现类TaskSchedulerImpl会为每个TaskSet创建一个TaskSetMagager对象,并将该对象添加到调度池中:
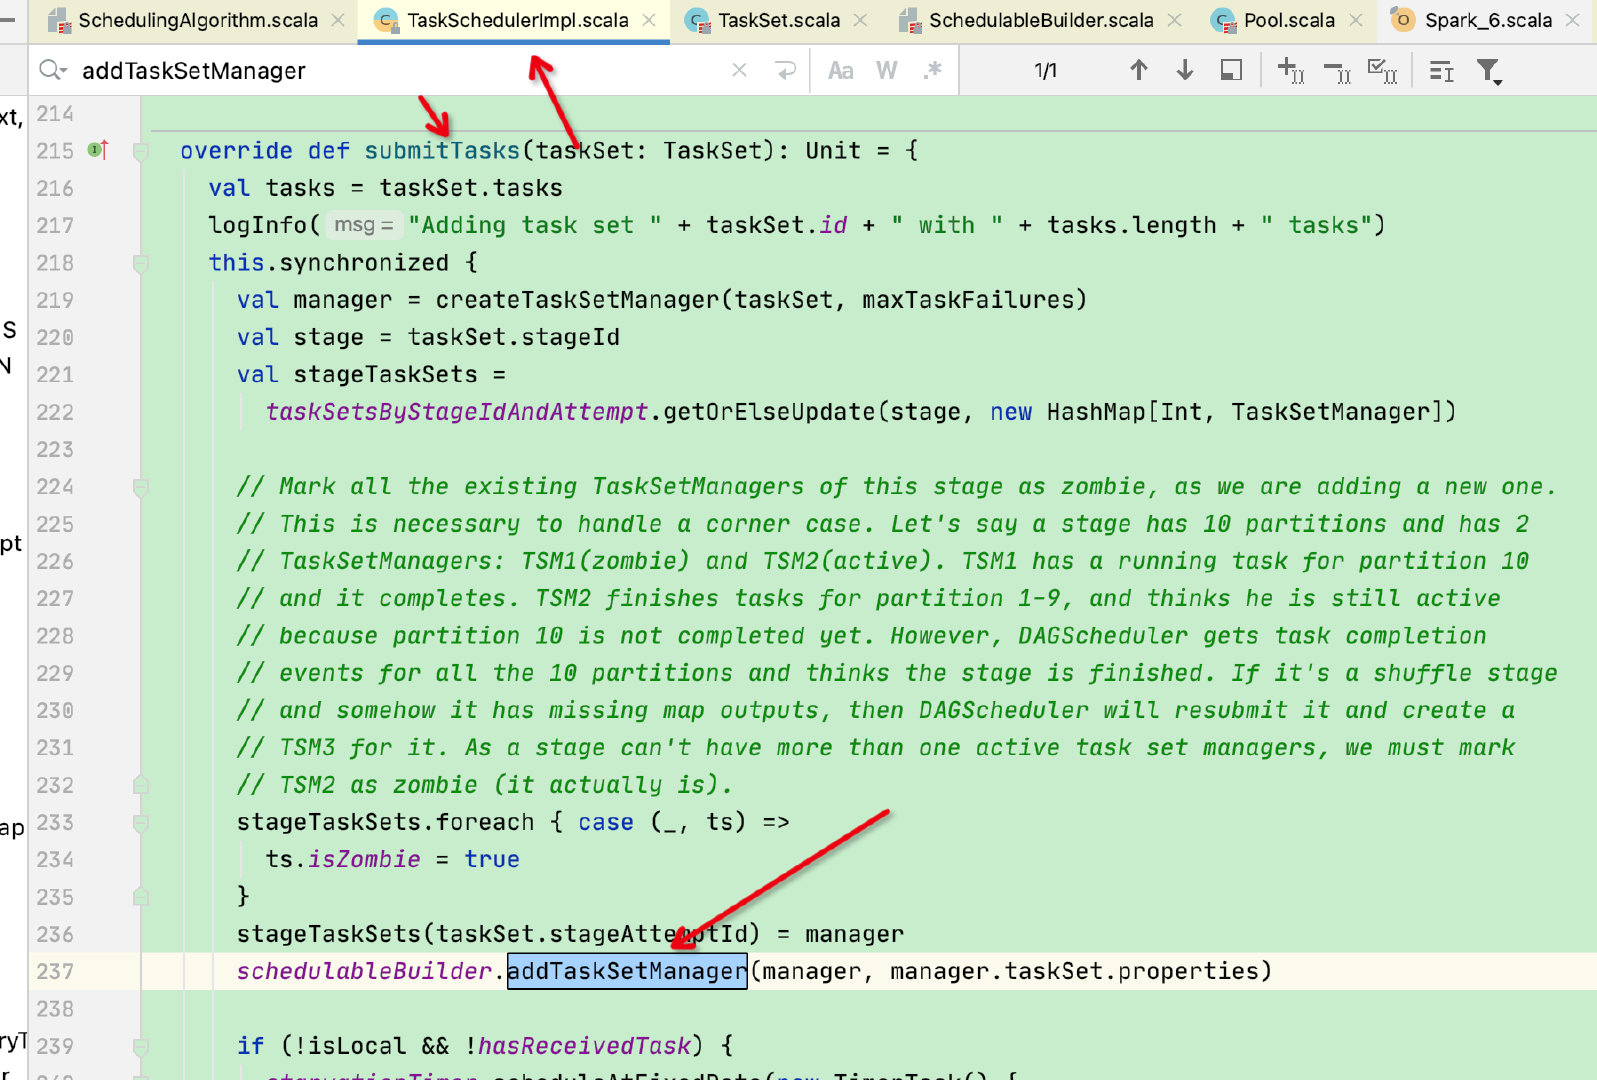
可以看出这里有一个schedulableBuilder变量,此变量是在创建TaskSchedulerImpl对象的时候通过initialize函数创建的:
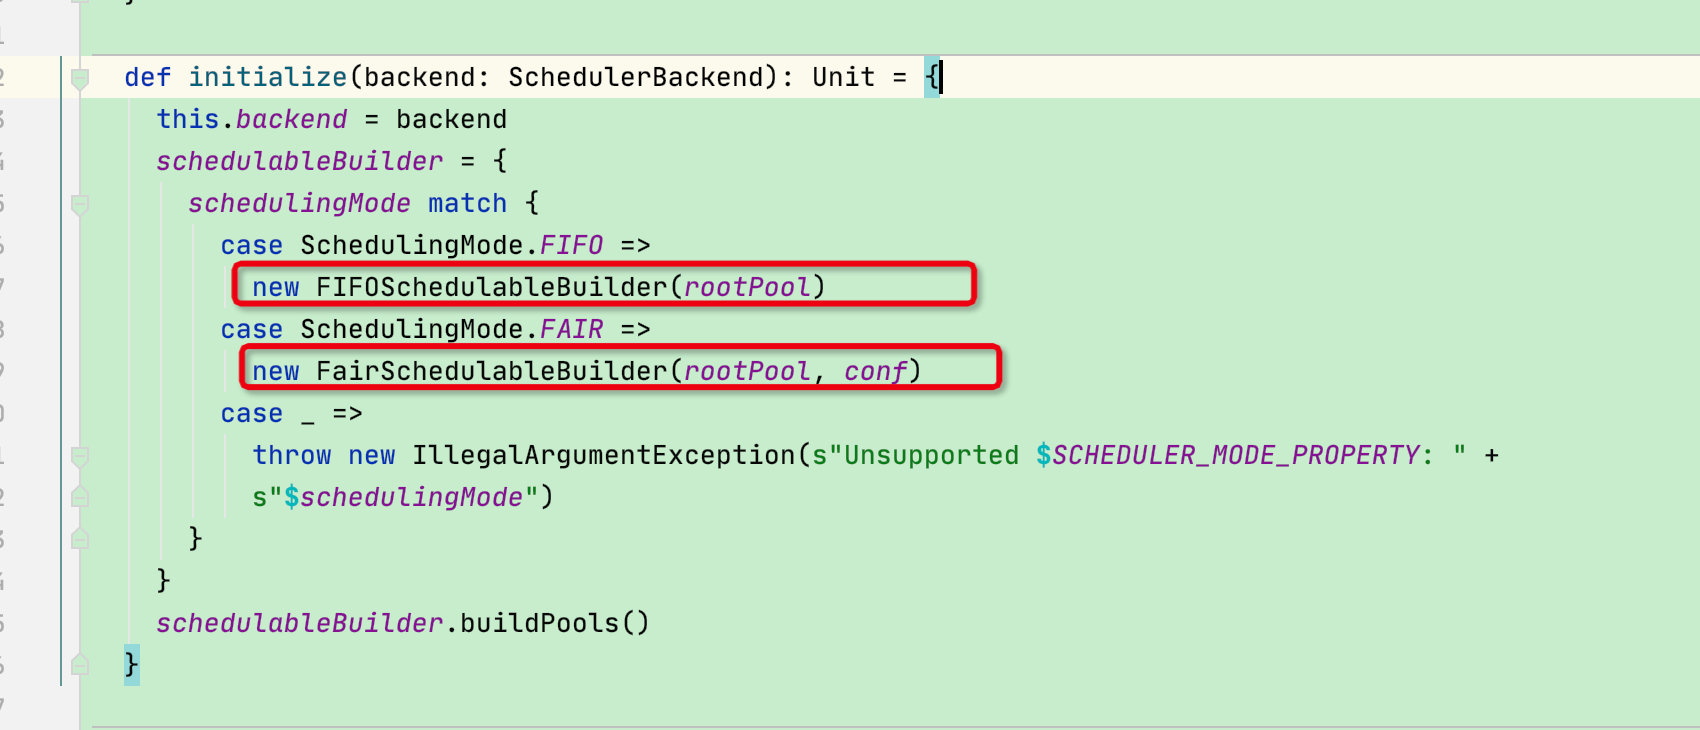
根据代码可以看出会根据conf配置的schedulingMode来创建不同的调度模式
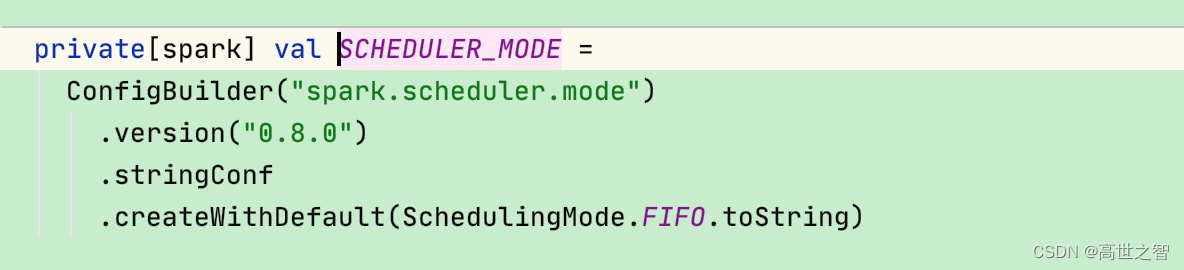
而schedulingMode是根据spark.scheduler.mode配置得到的,不设置默认是FIFO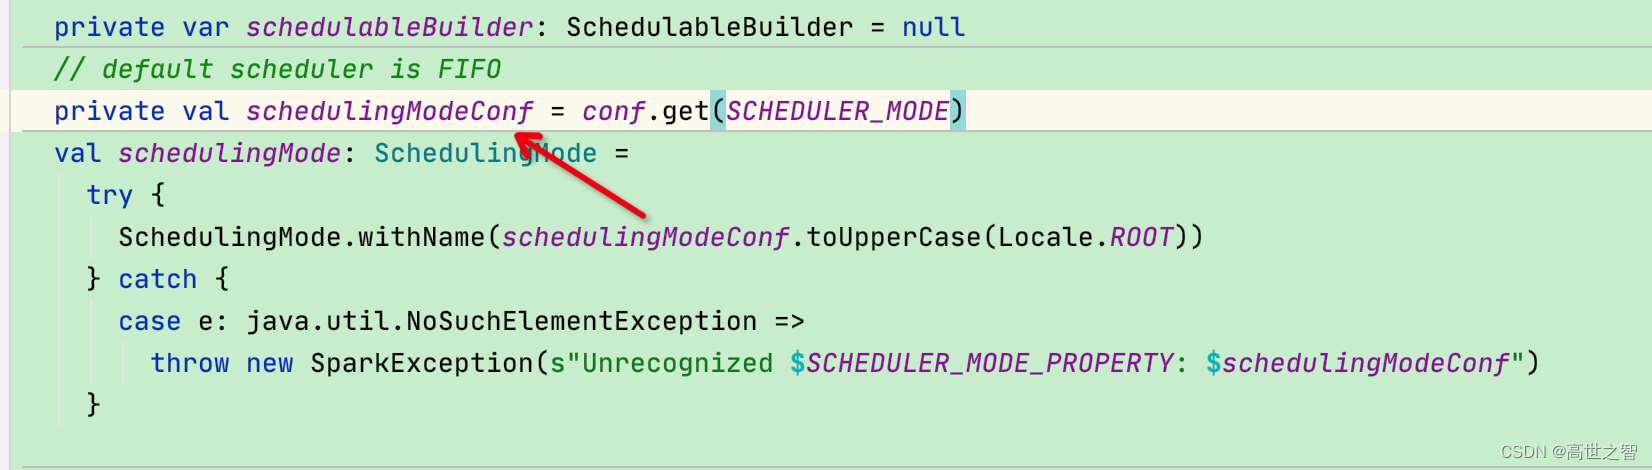
那么为什么要有两个调度策略呢?这是因为在spark程序中一旦执行action操作,主线程就会等待此次runjob的执行结果,直到获取到结果后才会进行下一个action操作,那假设我们要根据业务执行不同的action操作,不希望阻塞在这里,那么就需要新建一个线程来action操作,但即便我们新建一个线程提交作业,最终都是汇总到一个sparkcontext的TaskManager中,这个阶段都是将taskSet放到一个调度策略池里,如果不设置调度策略,那么默认就是FIFO,先进先出,故当我们在业务层面上需要用到多个线程提交不同的action作业时,就需要使用fair调度策略了
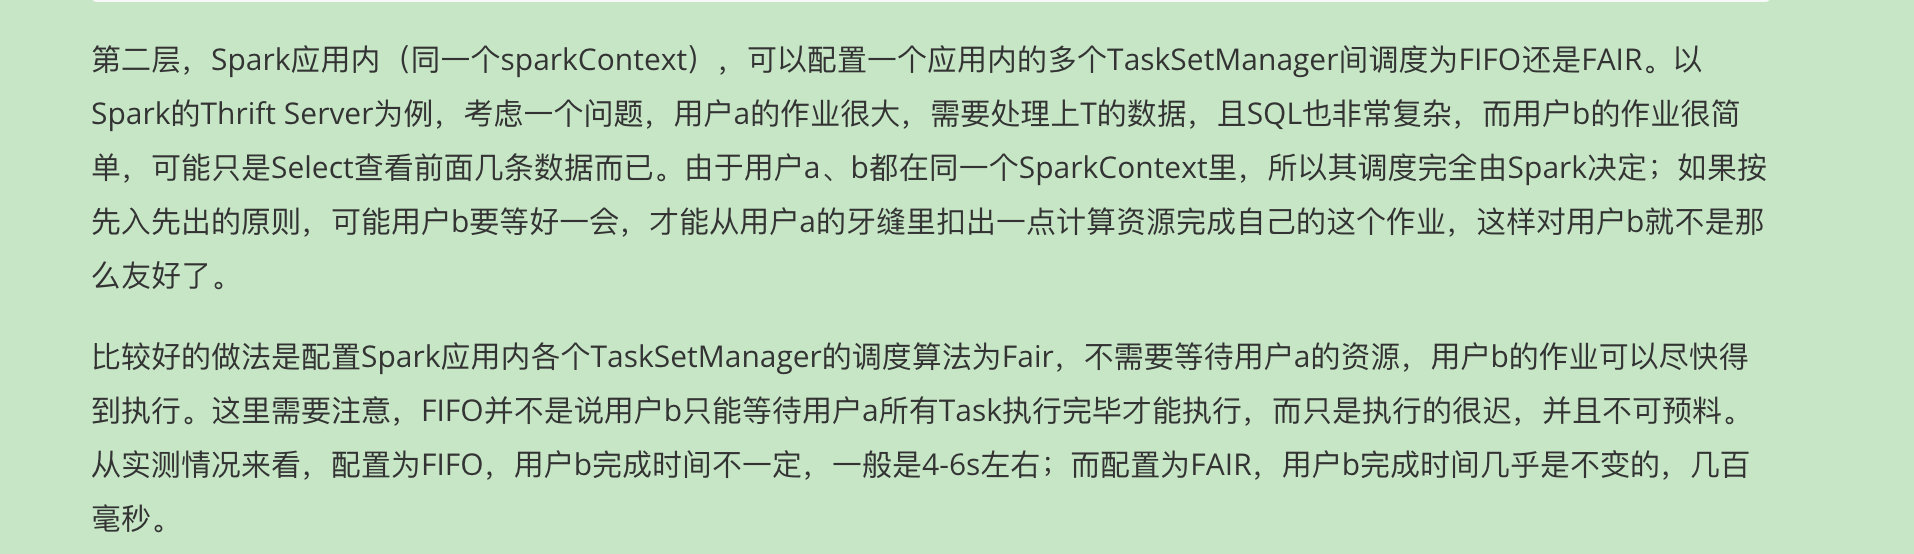
这就是两种调度的作用,所以即便我们在程序中通过新建一个线程后执行action,看似是异步提交两个action作业,但到了runjob后面到taskSchduler后,spark默认是FIFO调度,所以就还是一个一个taskSet执行。
注意:这种调度是spark-driver端sparkContext的调度,并不是yarn上的调度!
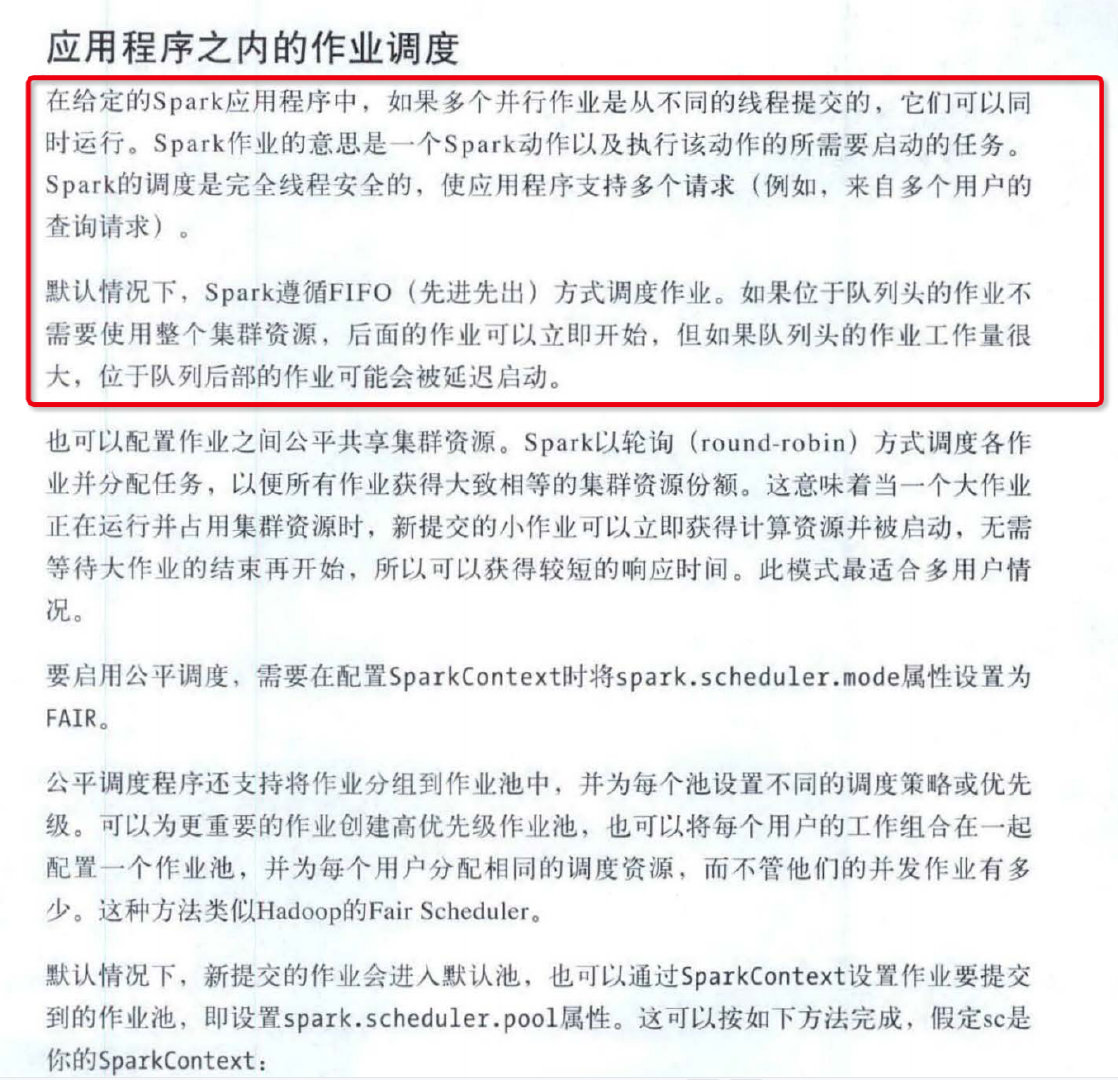
若想配置公平调度器,参考官网:https://spark.apache.org/docs/3.2.1/job-scheduling.html#fair-scheduler-pools
使用FAIR公平调度器注意事项:
1、fair公平调度器默认是读取fairscheduler.xml 配置文件,根据配置来创建多个pool,因为fair公平就是对多个池子、taskSetManager之间公平,如果使用默认的fairscheduler.xml配置文件则默认会有三个池子:production 、 test、 还有一个默认的defualt池子。

默认的defualt池子是FIFO的模型,创建这个池子的目的是当用户代码中没有指定使用哪个池子的时候,就会放入默认池子中,注意:要防止出现这种情况,因为这将会是FIFO的模式,相当于fair公平调度器完全没有发挥出作用。
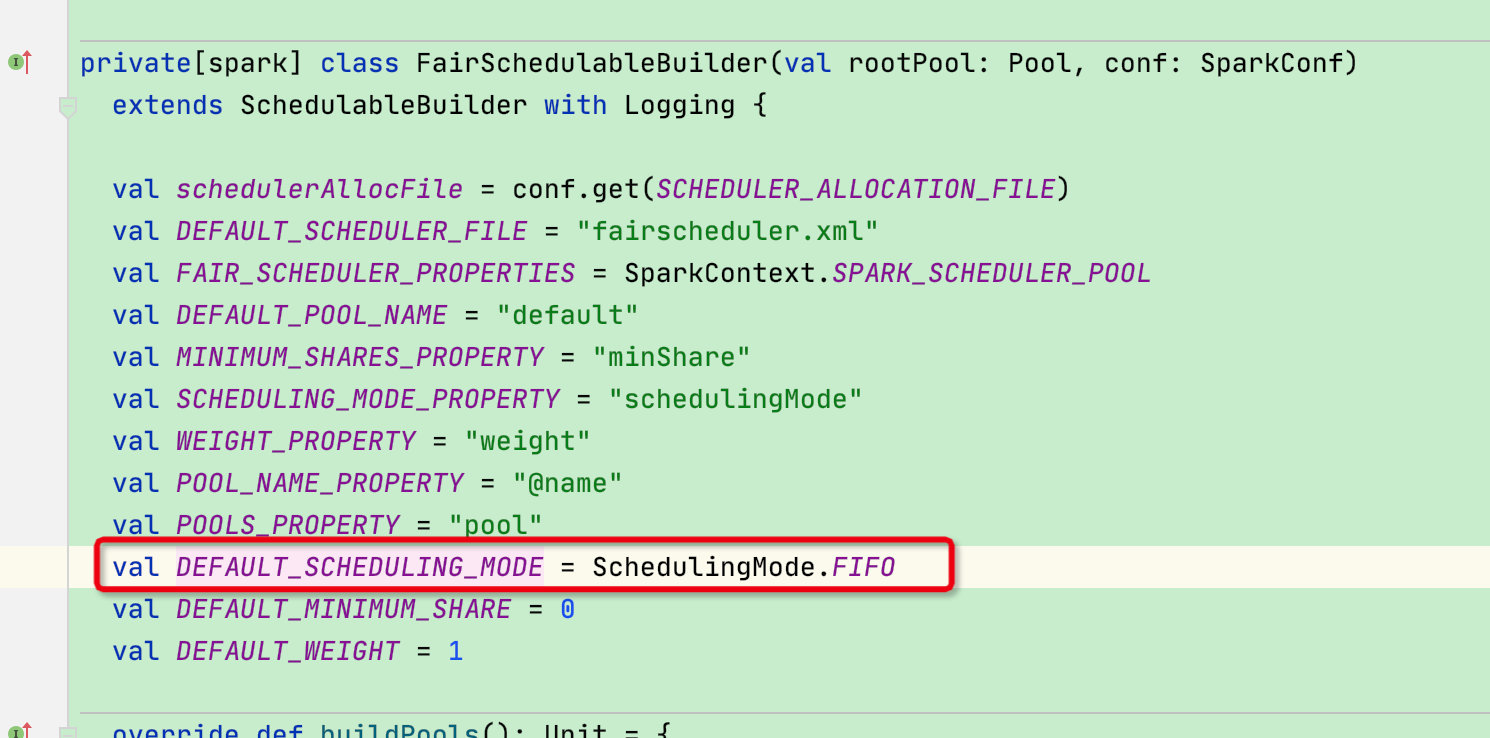
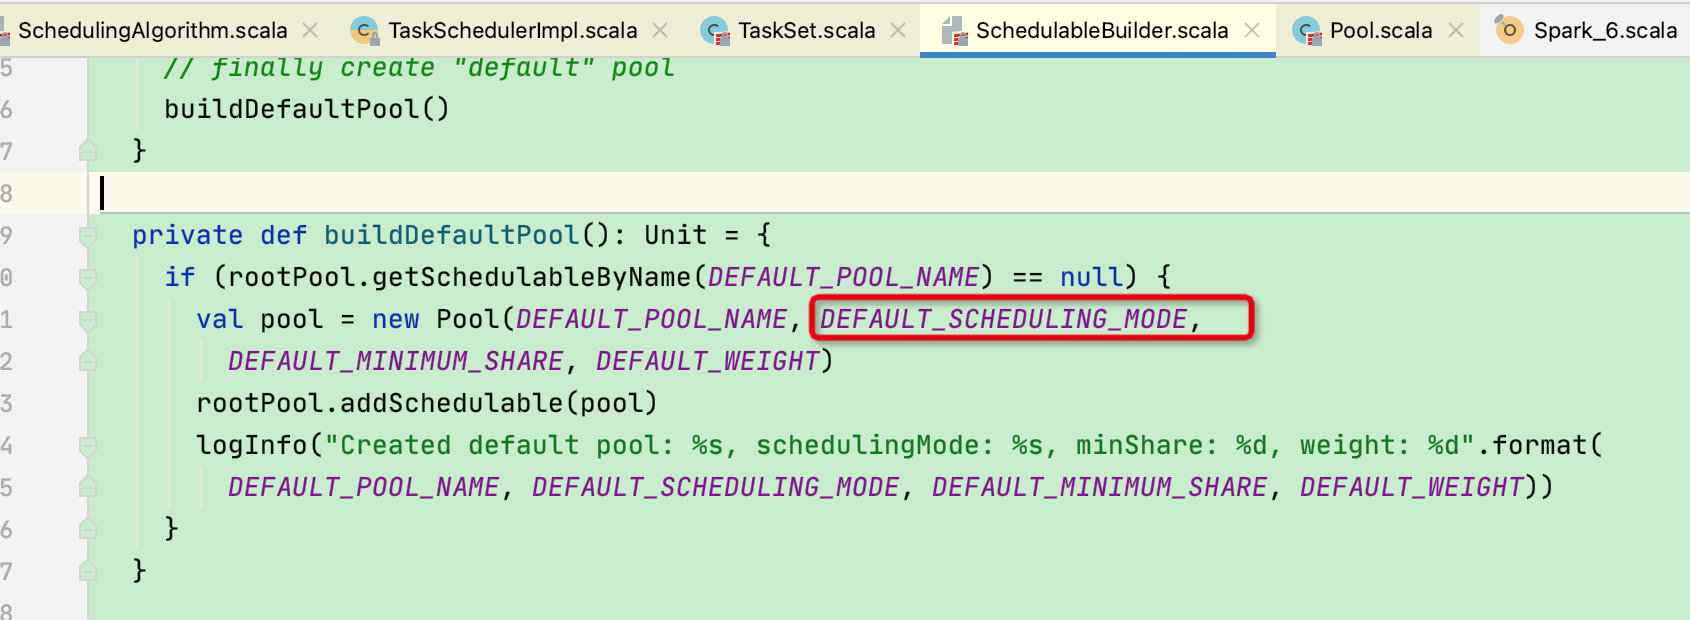
看了fairscheduler.xml配置文件大家可能会疑惑,我既然已经使用了公平调度器了,那为何配置上的test池子可以设置为FIFO的模式呢?
这是因为公平调度器允许:一个池子内部也可以根据不同的模型进行排序,比方上图中的两个调度池:test/producetion,这两个池子之间可以通过weight和minShare来进行比较的,production的优先级高于test,但test池子内部则按照先进先出的优先级进行排序,而production内部按照TaskSet参数来进行公平调度规则比较
2、spark要开启公平调度器:

3、用户代码中要手动设置线程使用的池名称,如下图:如果不设置池名称,则默认所有任务都提交给defualt调度池!那么只有一个default池子有作业,而default池子默认是FIFO, 至此公平调度器就成了一个摆设,无法发挥作用
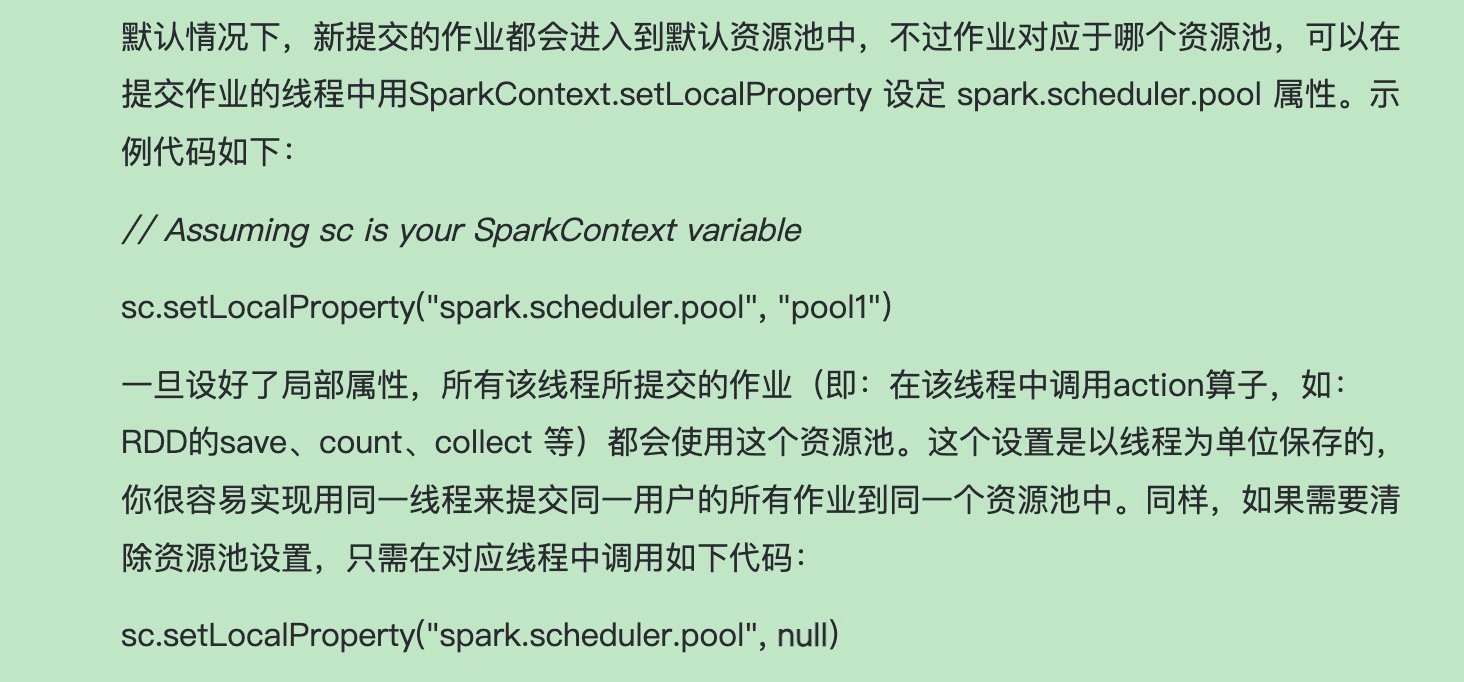

示例
val sparkConf = new SparkConf() .setMaster("local[*]") .setAppName("sparkSQL") .set("spark.scheduler.mode", "FAIR") // 开启Fair调度 val spark = SparkSession.builder().config(sparkConf).getOrCreate() // 设置main线程使用test调度池 spark.sparkContext.setLocalProperty("spark.scheduler.pool", "test") // 设置新的线程使用production调度池 new Thread(() => { spark.sparkContext.setLocalProperty("spark.scheduler.pool", "production") // 下面三个操作会进入production调度池 spark.sql("xxxxxxxx") spark.sql("xxxxxxxx") spark.sql("xxxxxxxx") }) // 下面两个sql操作会进入test调度池 spark.sql("xxxxxx") spark.sql("xxxxxx")- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
源码
1、通过上面initialize函数可以看出scheduler.initialize(backend)的initialize方法对schedulableBuilder进行了实例化。可以看到程序会根据配置来创建不同的调度池,schedulableBuilder有两种实现,分别是FIFOSchedulableBuilder和FairSchedulableBuilder,接着后面调用了schedulableBuilder.buildPools(),我们来看两者都是怎么实现的。

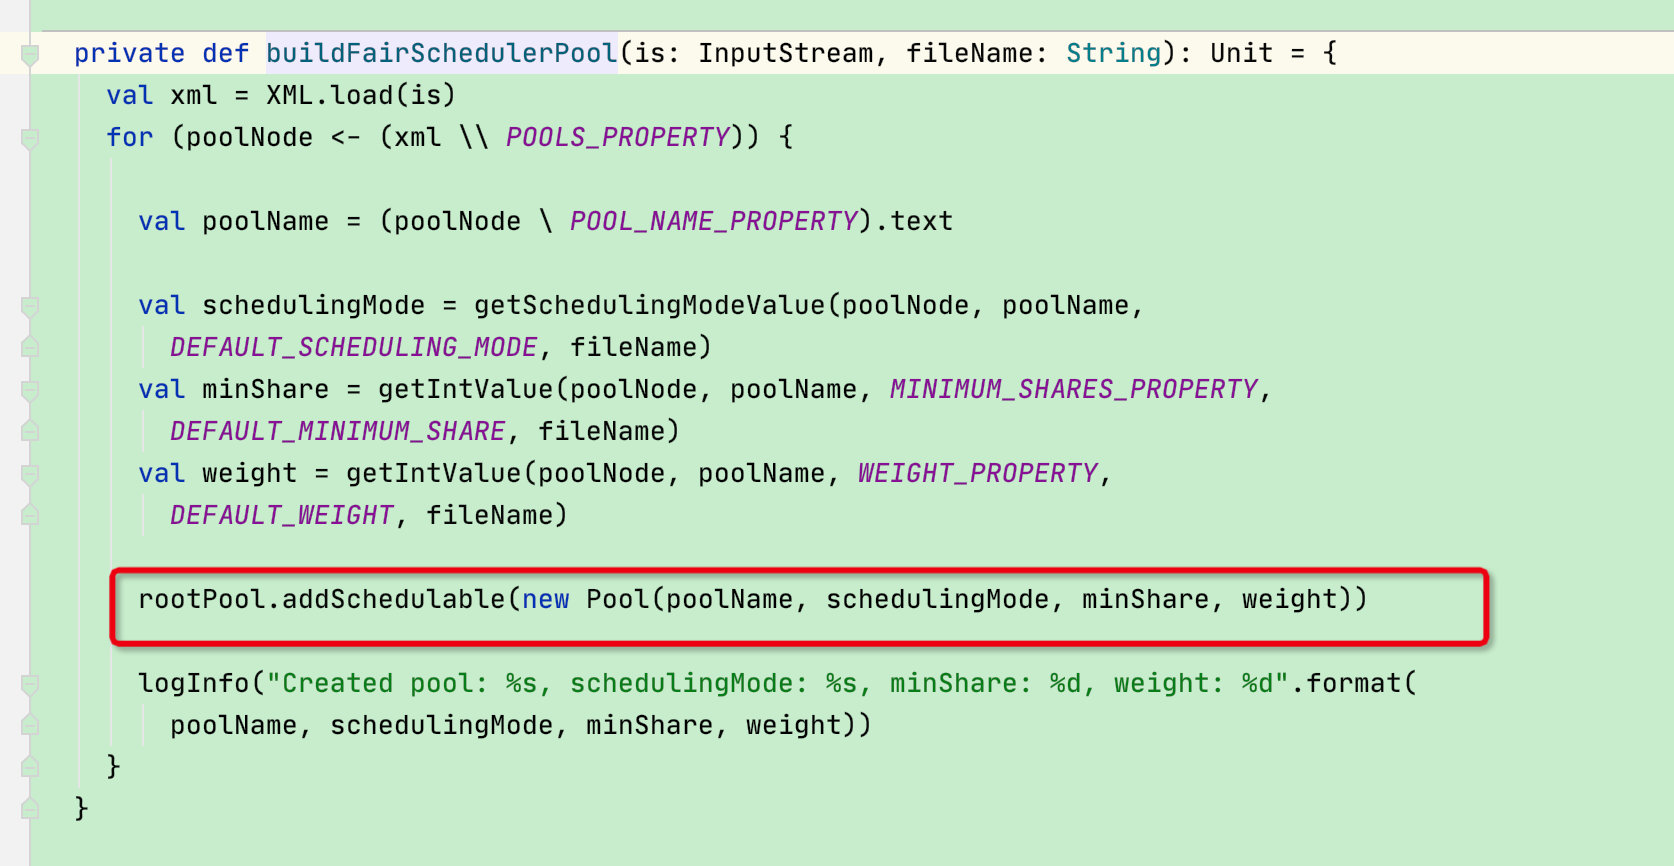
可以看出其构建过程就是可以看到FairSchedulableBuilder的buildPools方法中会先去读取FAIR模式的配置文件默认位于SPARK_HOME/conf/fairscheduler.xml,也可以通过参数spark.scheduler.allocation.file设置;
然后根据配置文件中的pool标签构件好pool池子并放入到rootPool池子中,rootPool是所有调度策略必须有的顶层池,在TaskSchedulerImpl类初始化时就会创建
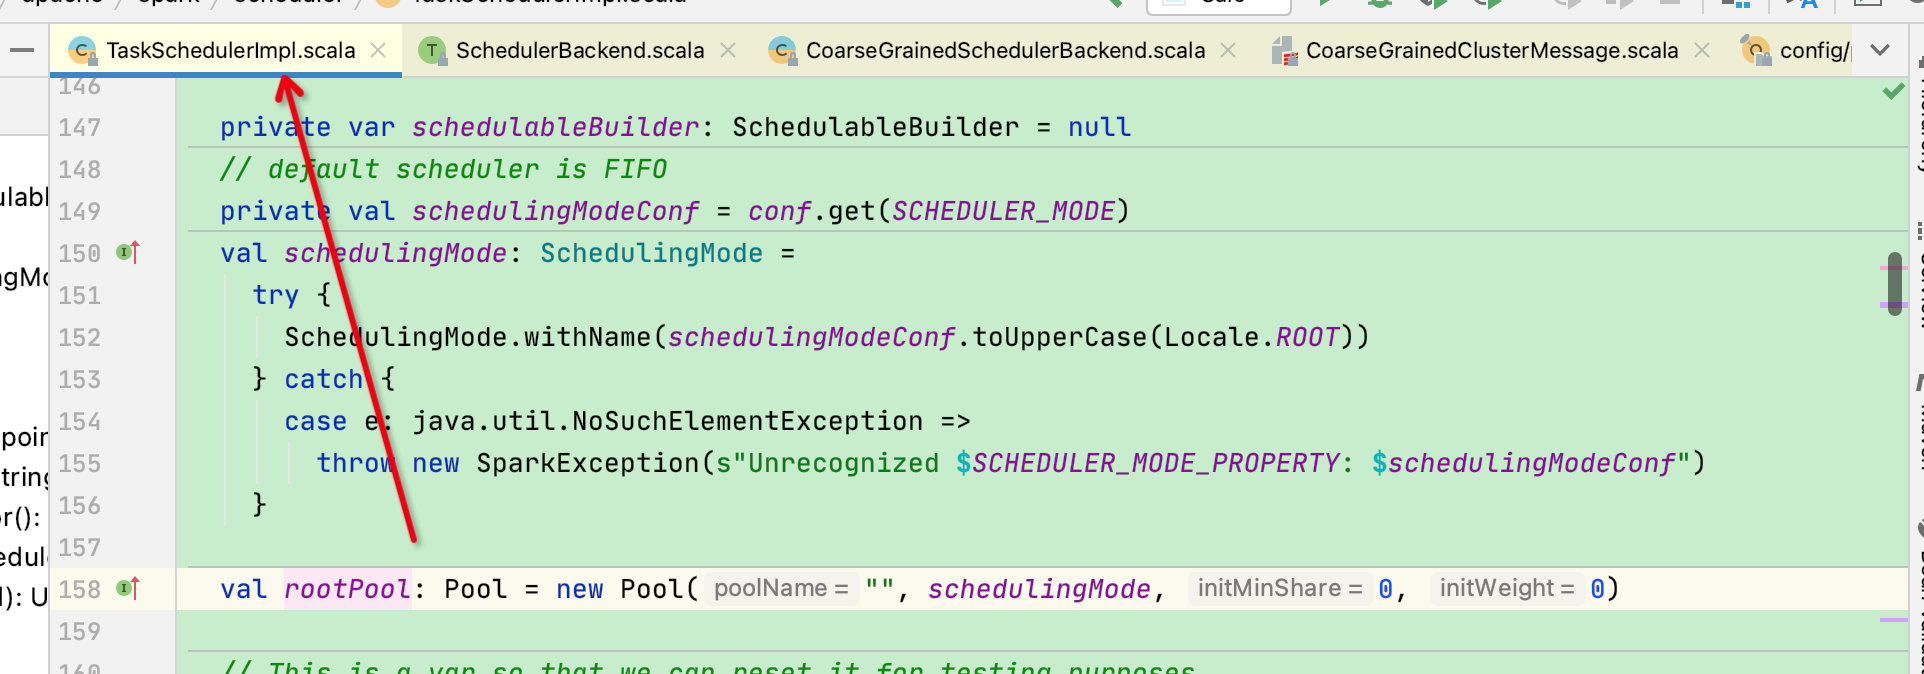
用户自定义配置文件FAIR可以配置多个调度池,即rootPool里面还是一组Pool,每个Pool中都可以放很多作业
从上到下看池子应该是这样的:
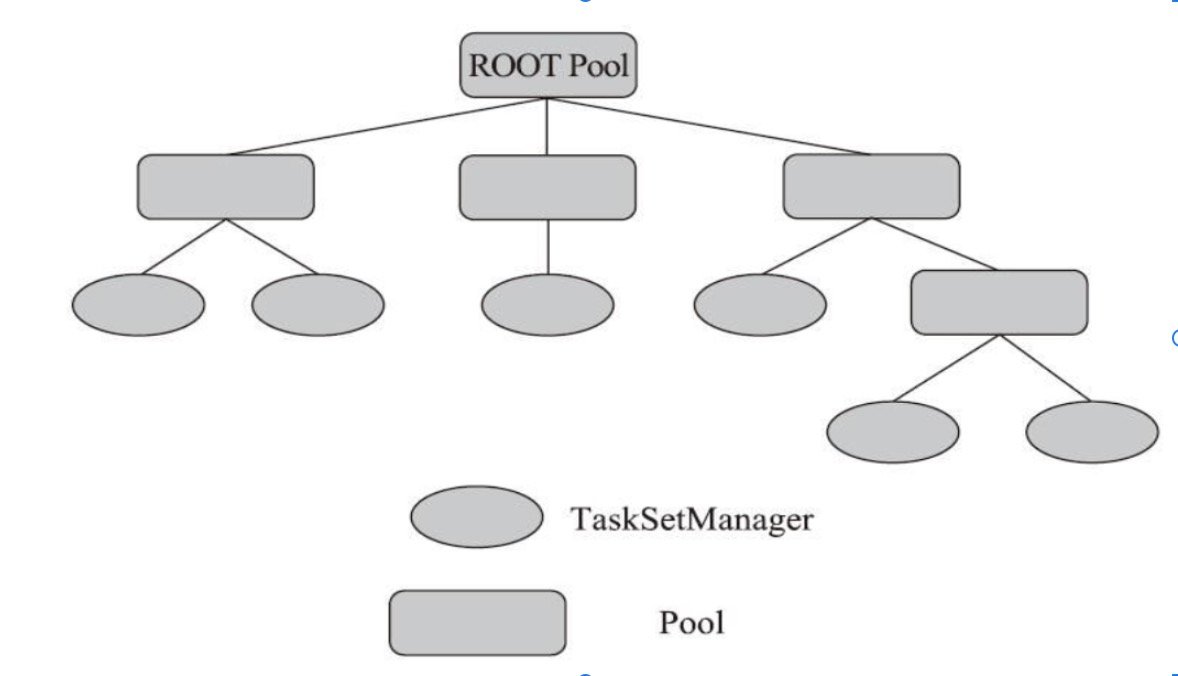
图片上可以看出Pool中包含着TaskSetManagr作业,那么是如何包含的呢?,如下图
在Pool中有一个队列,队列泛型是Schedulable类,而Schedulable类是Pool和TaskManager的父类,故有了上图的结构
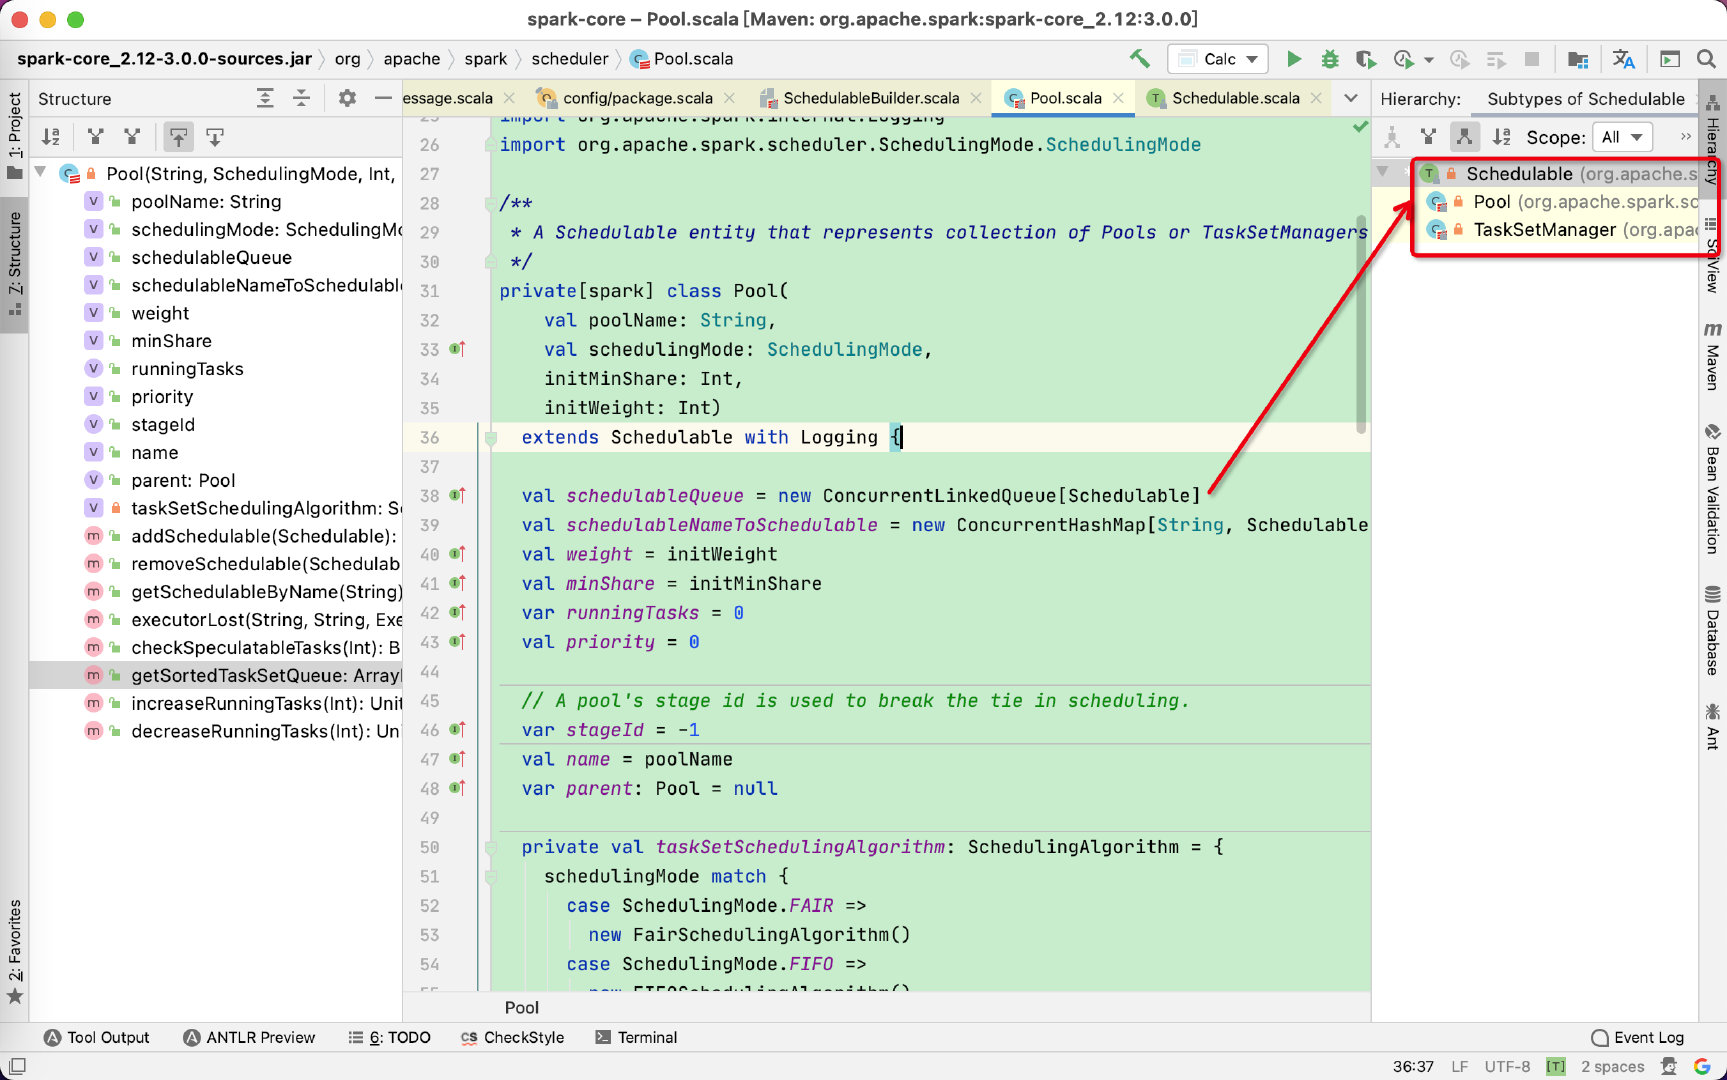
不过一般来讲rootPool下面只有一层的pool,如果按照默认的fairscheduler.xml配置文件的话,rootPool下面只有三个pool: 一个test调度池,一个默认default调度池和一个production调度池
了解了这个以后我们再来看看任务是如何放进pool中的,如下图:task通过addTaskSetManager函数放入
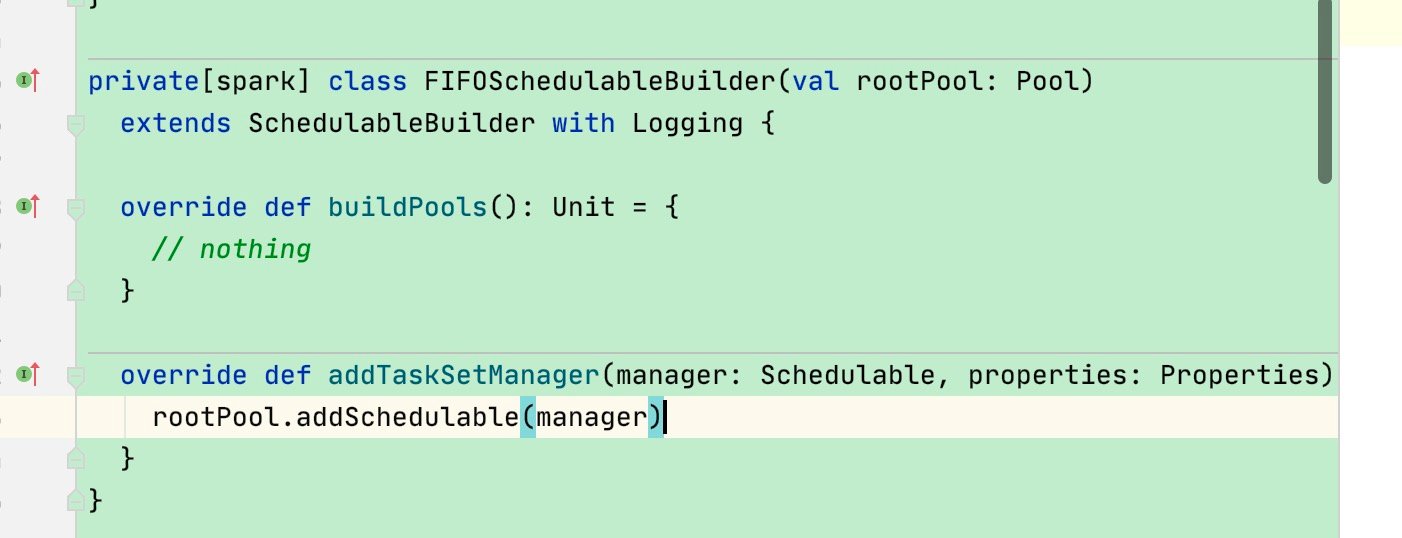
然后看addTaskSetManager函数:FIFO就是直接放到RootPool里面了,可想而知FIFO就只有一层,但FAIR则会根据用户的配置[sc.setLocalProperty(“spark.scheduler.pool”, “test”)]来选择放入哪个Pool中
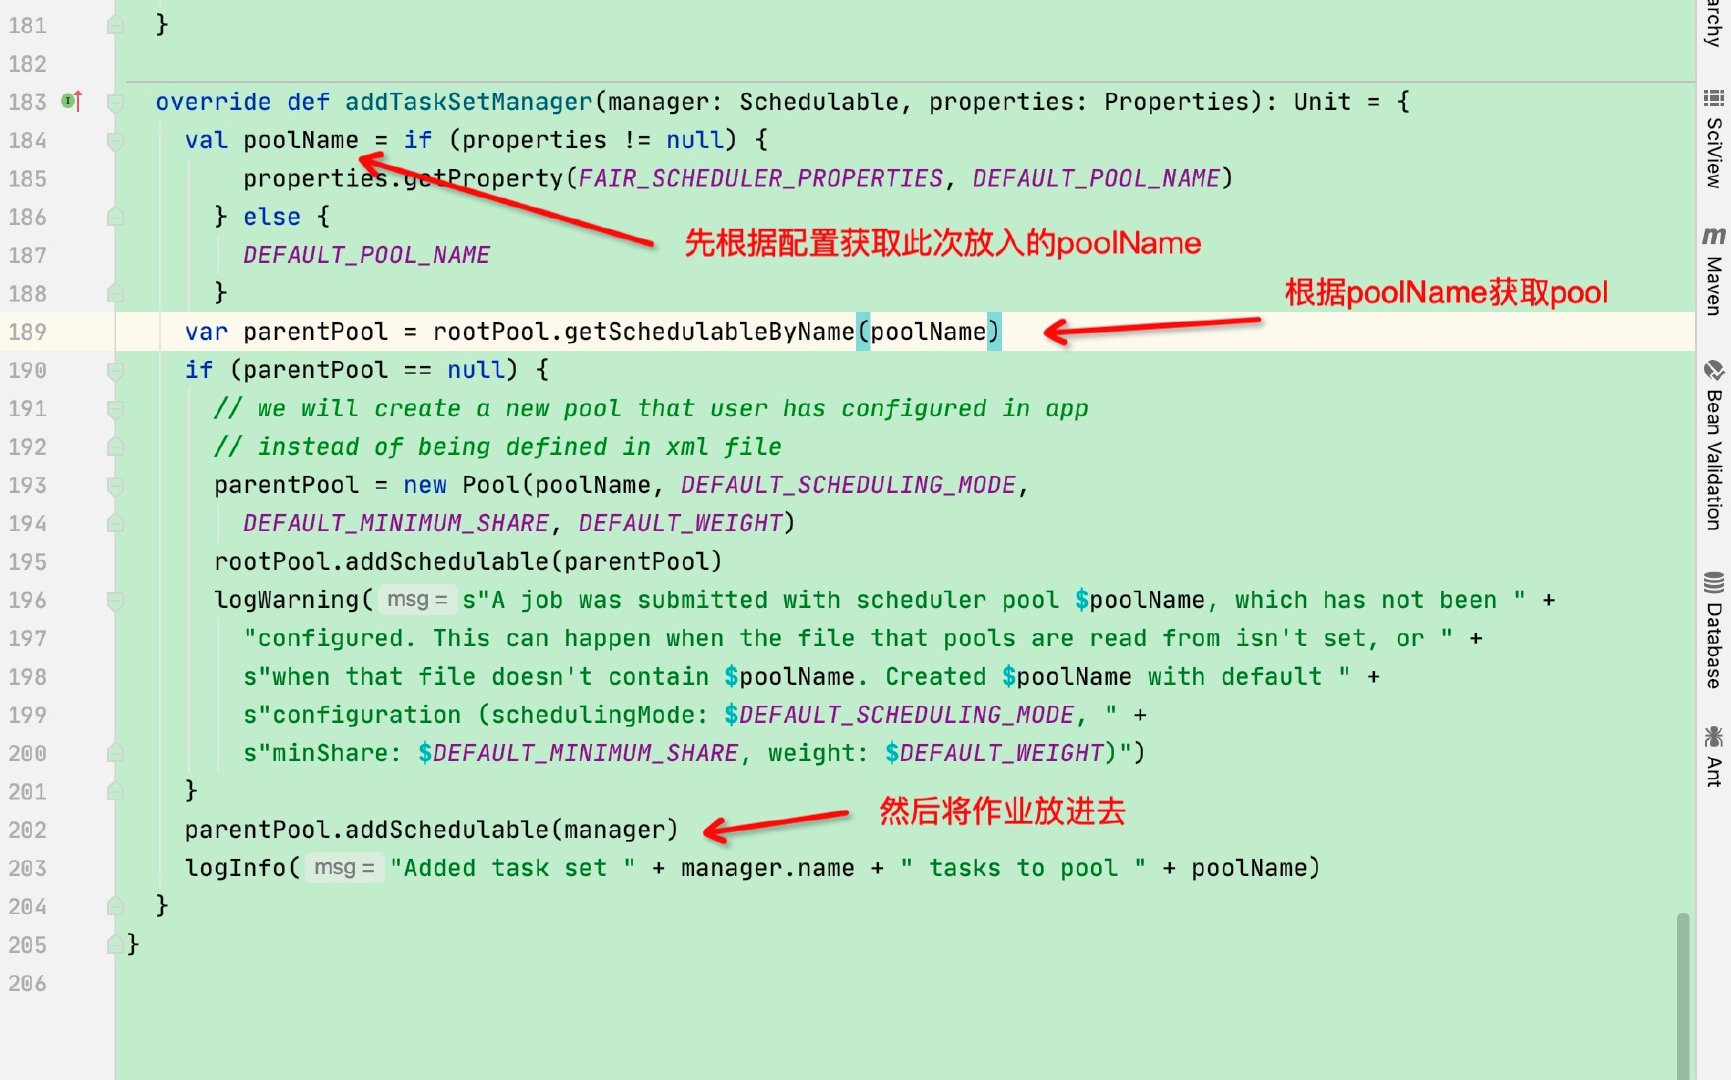
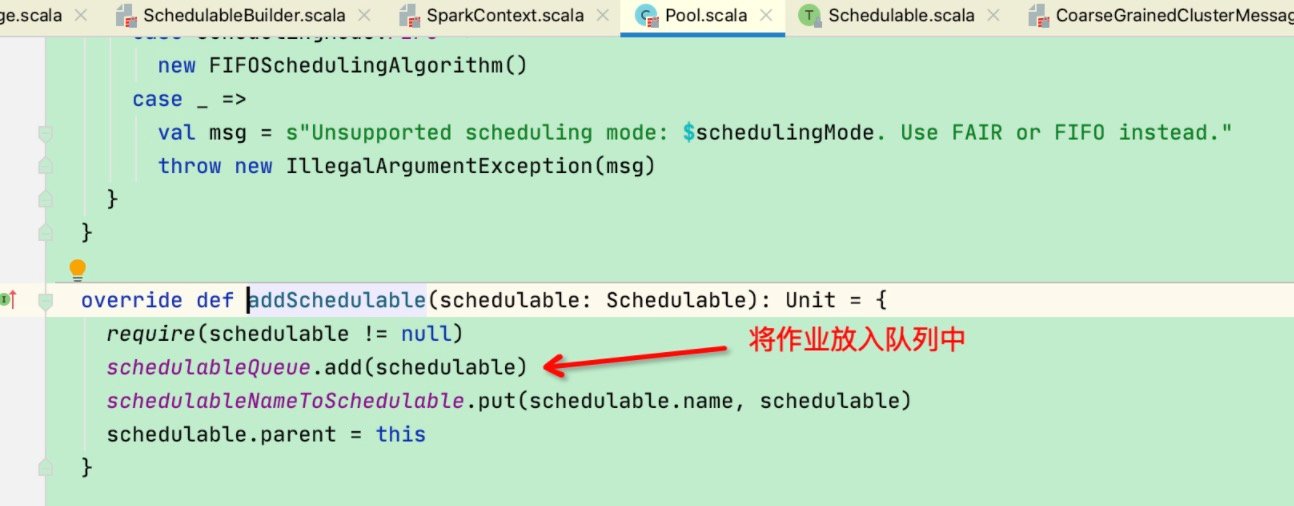
最终将作业放入指定pool的队列中
那这队列放进去后如何使用呢?在 taskScheduler 的 submitTasks 方法中会为每个 taskSet 创建一个 TaskSetManager,用于管理 taskSet。然后向调度池中添加该 TaskSetManager,最后会调用 backend.reviveOffers() 方法为 task 分配资源。
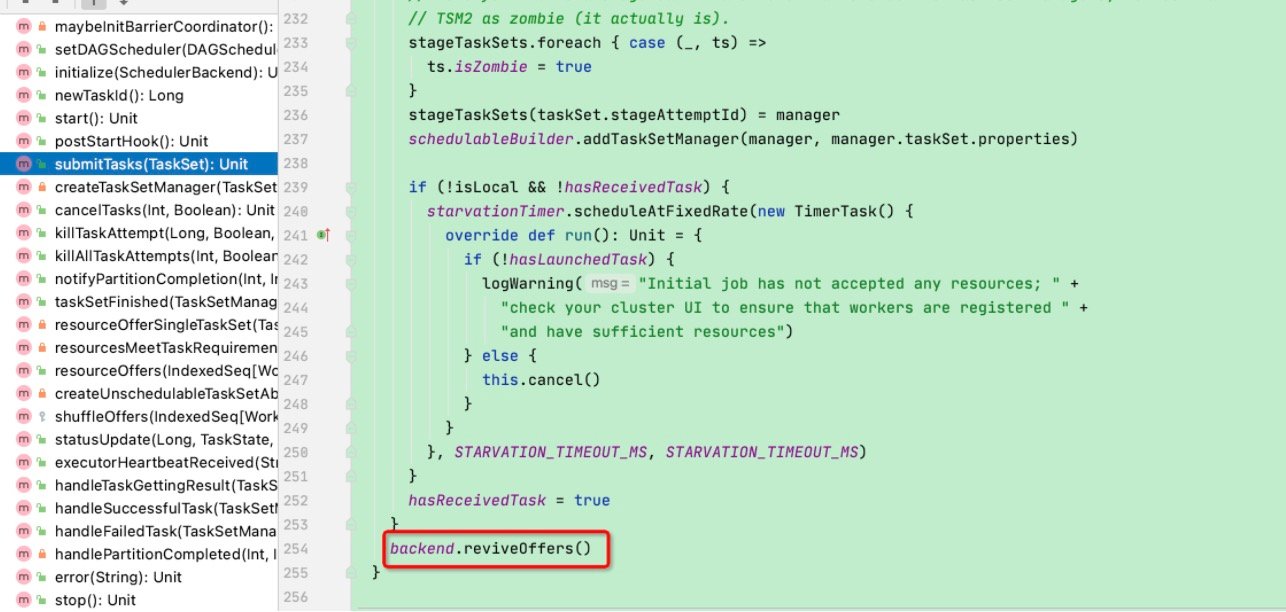
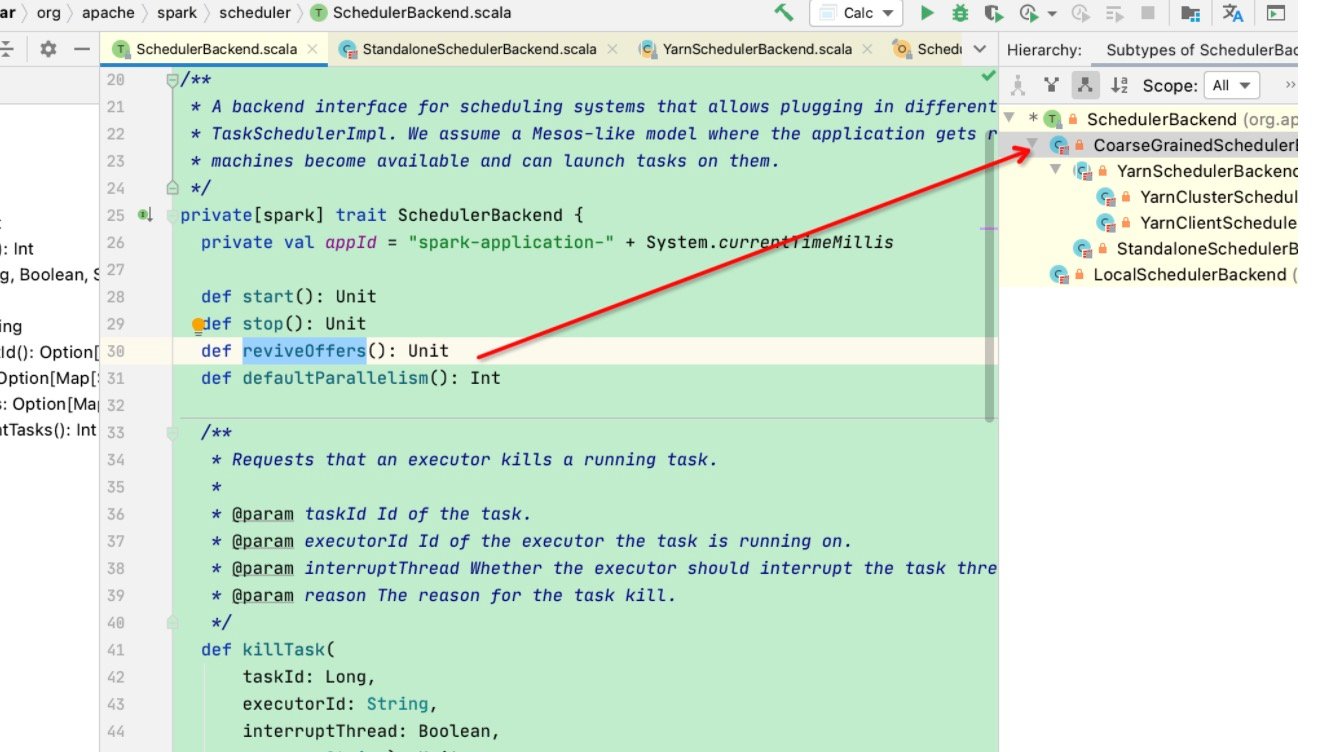
下面主要看 backend.reviveOffers() 这个方法,在提交模式是 yarn-cluster 模式下,实际上是调用 YarnClusterSchedulerBackend 的 reviveOffers 方法,实则调用的是其父类 CoarseGrainedSchedulerBackend 的 reviveOffers 方法,这个方法是向 driverEndpoint 发送一个 ReviveOffers 消息。
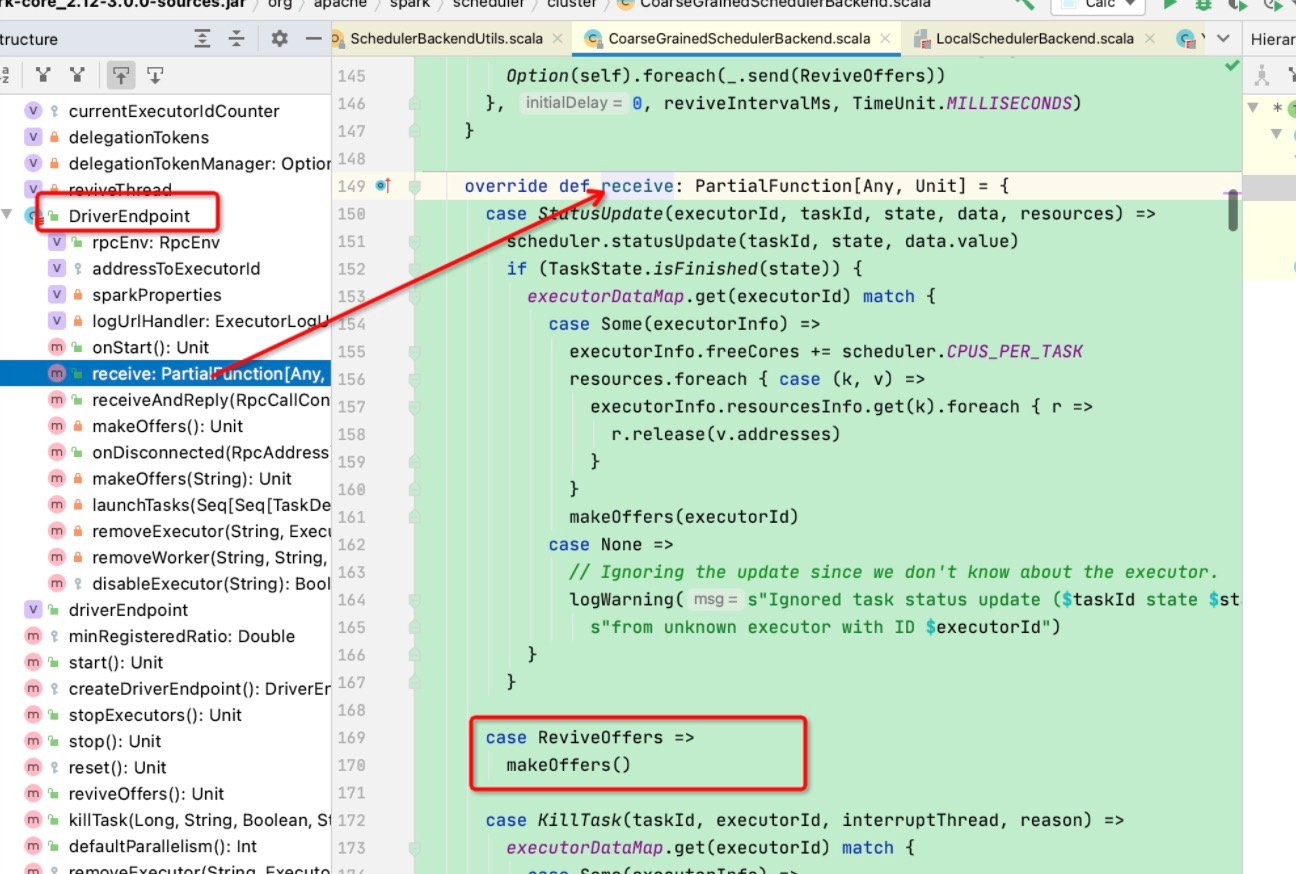
DriverEndpoint 收到信息后会调用 makeOffers 方法:
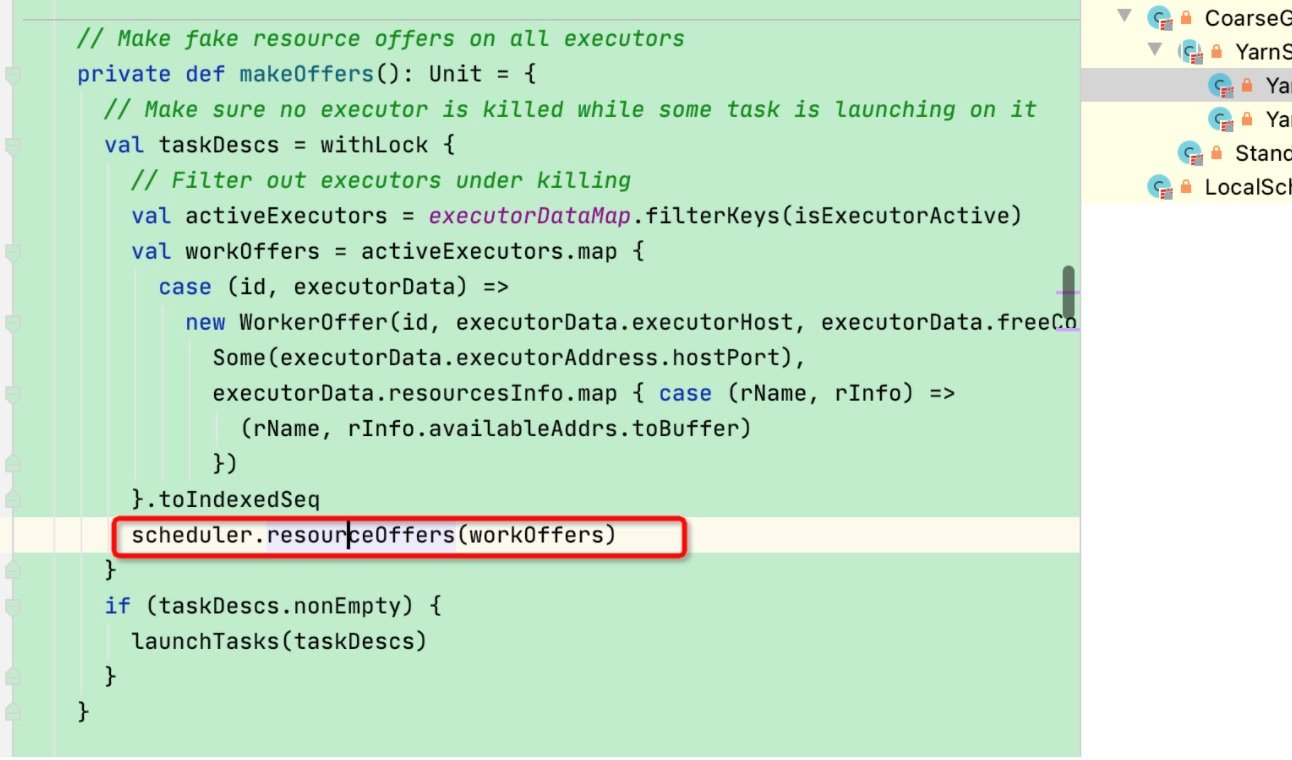
接下来会调用resourceOffers
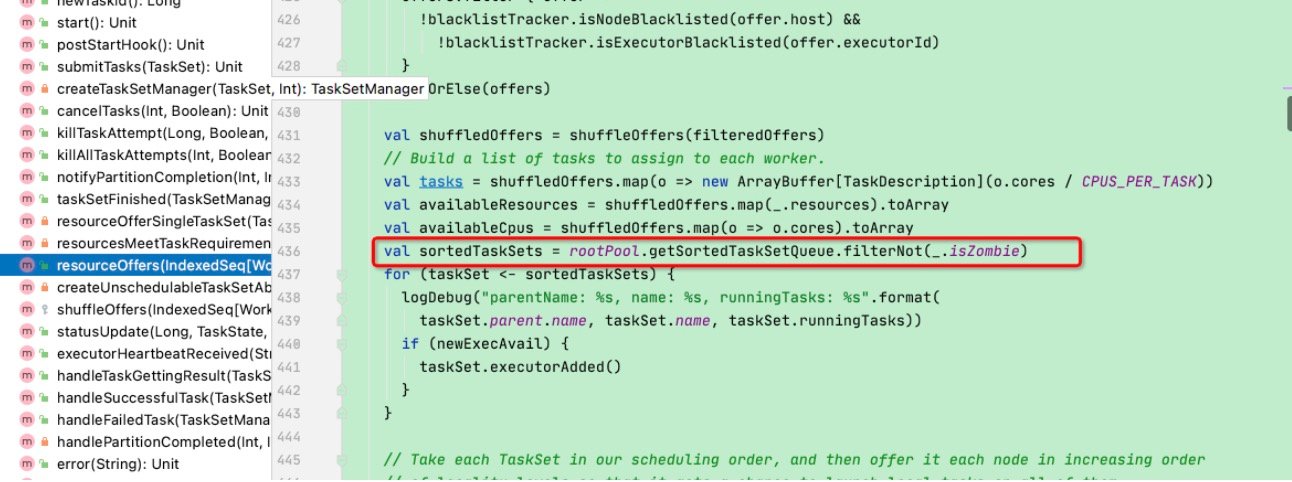
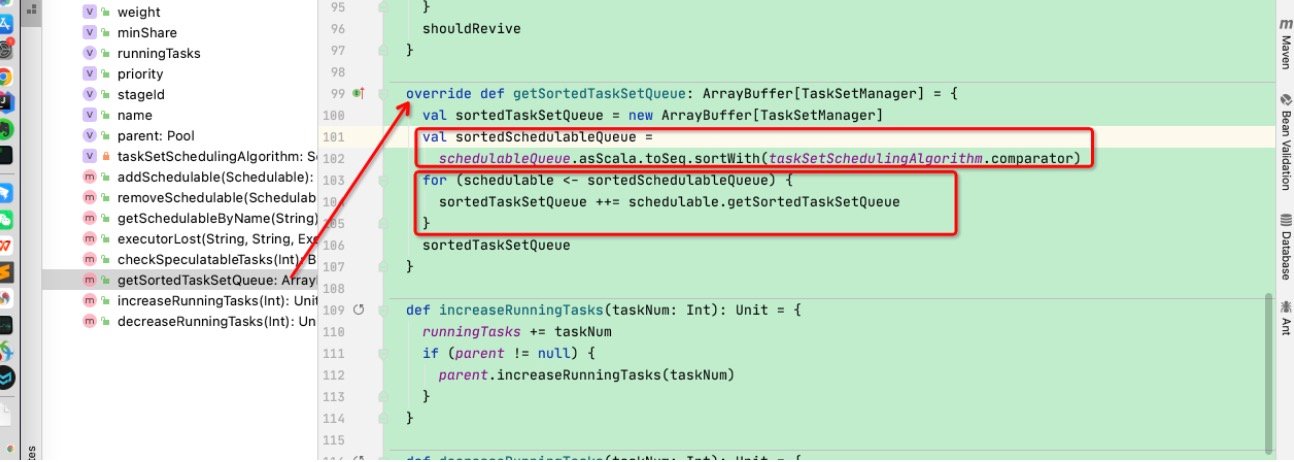
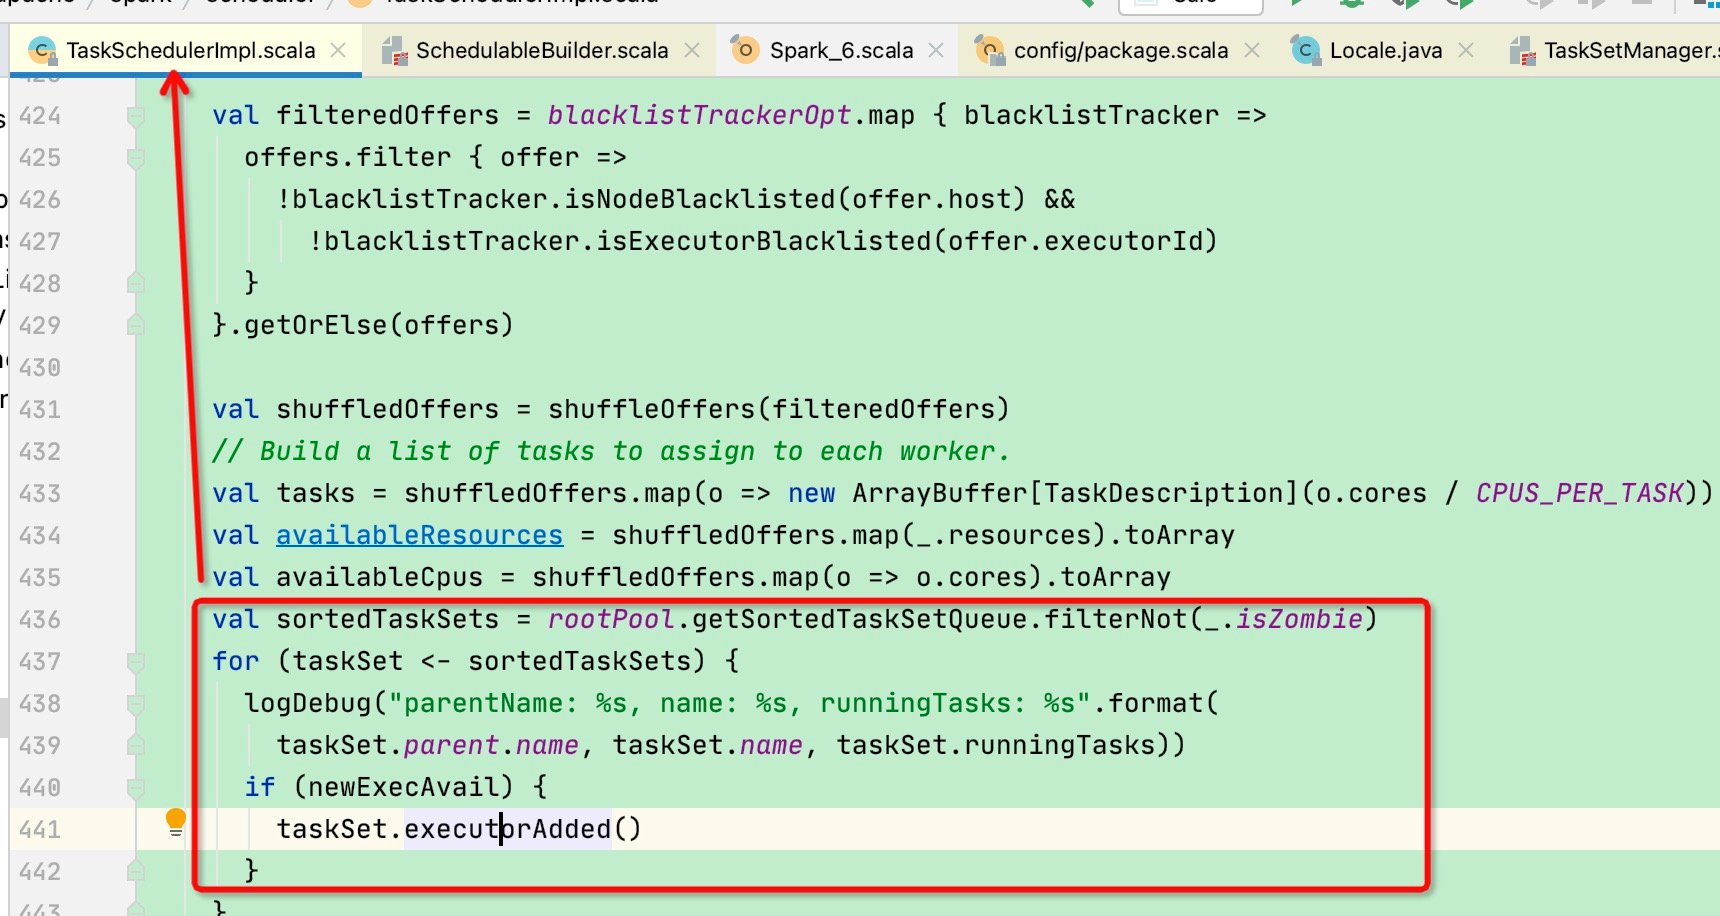
在resourceOffers函数中,会调用根rootpool的getSortedTaskSetQueue函数,将根目录下的所有pool进行排序!然后将排序好的TaskSet按照先后顺序执行,这便是调度使用的关键,那么接下来看getSortedTaskSetQueue函数
getSortedTaskSetQueue函数中有两个重要信息:
第一:是先将rootPool下面的所有pool按照taskSetSchedulingAlgorithm规则进行排序。
第二:将第一层排好序的pool通过for循环将其pool内部的所有TaskSetManager再排序
第三:将这些排好序的taskSetManager累加到ArrayBuffer后返回
注意:这里有一个重点就是taskSetSchedulingAlgorithm的规则适用于pool 和 TaskSetManaer!
接下来看一下taskSetSchedulingAlgorithm是啥,可以看到其实是pool的排序规则【FIFO/FAIR】,每个pool的排序规则是根据fairscheduler.xml文件中schedulingMode标签决定的
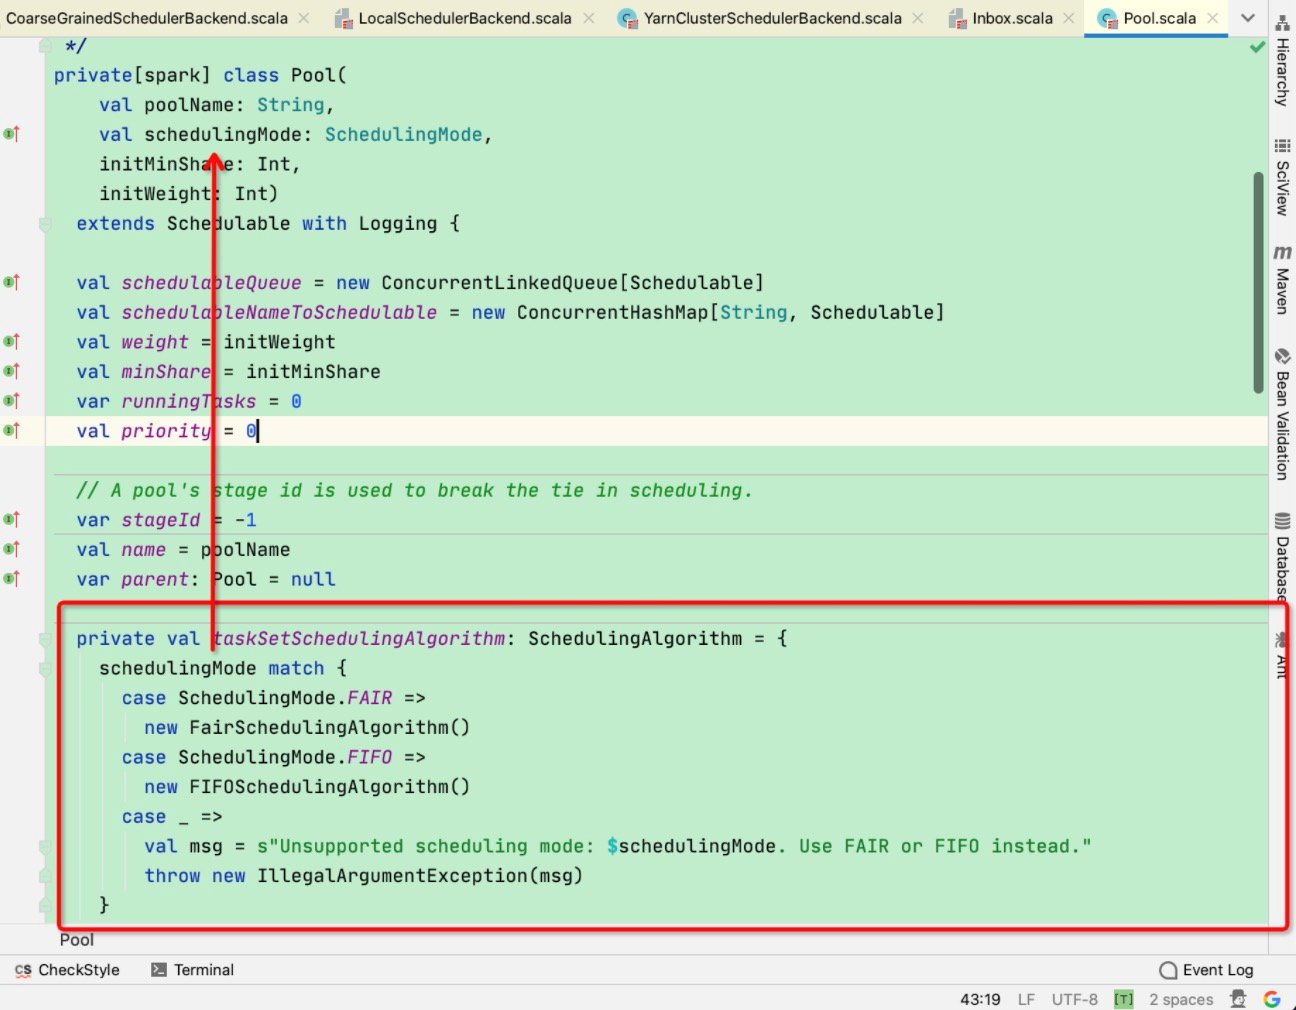
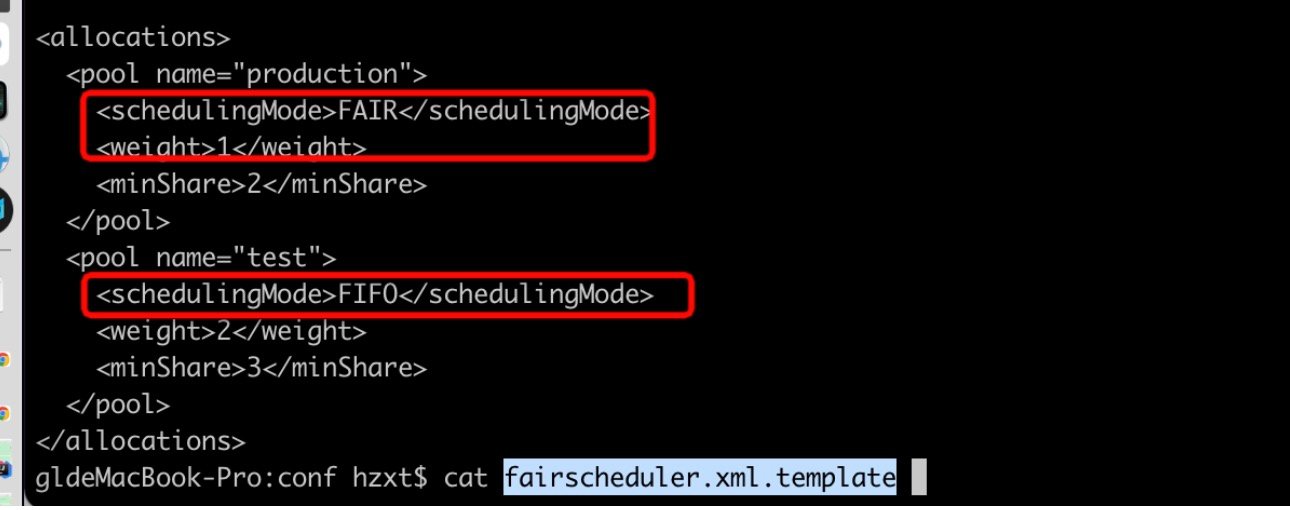
第一层rootPool的排序规则是根据用户配置调度模式决定的,默认是FIFO,FIFO就只有rootPoll一层,那么Fair的话rootPool就是根据FIFOSchedulingAlgorithm进行排序的, 并且其下面还有其他pool

接下来看这两个的排序规则:
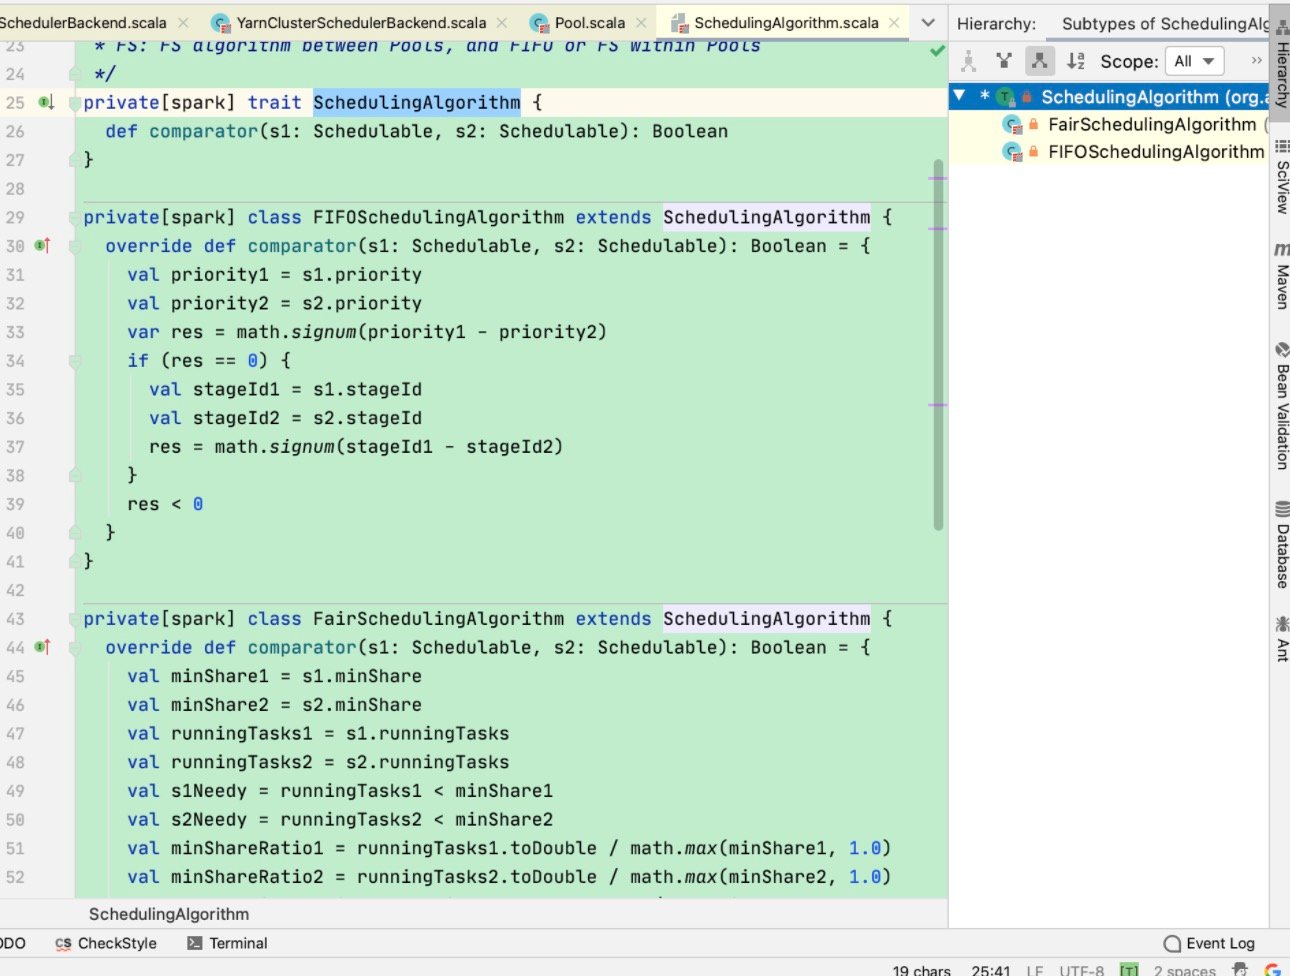
FIFO由于只有RootPool这一层,故实际上就是比较两个TaskSetManager的jobId

而Fair比较器则规则则多了,主要还是根据饥饿原则进行比较
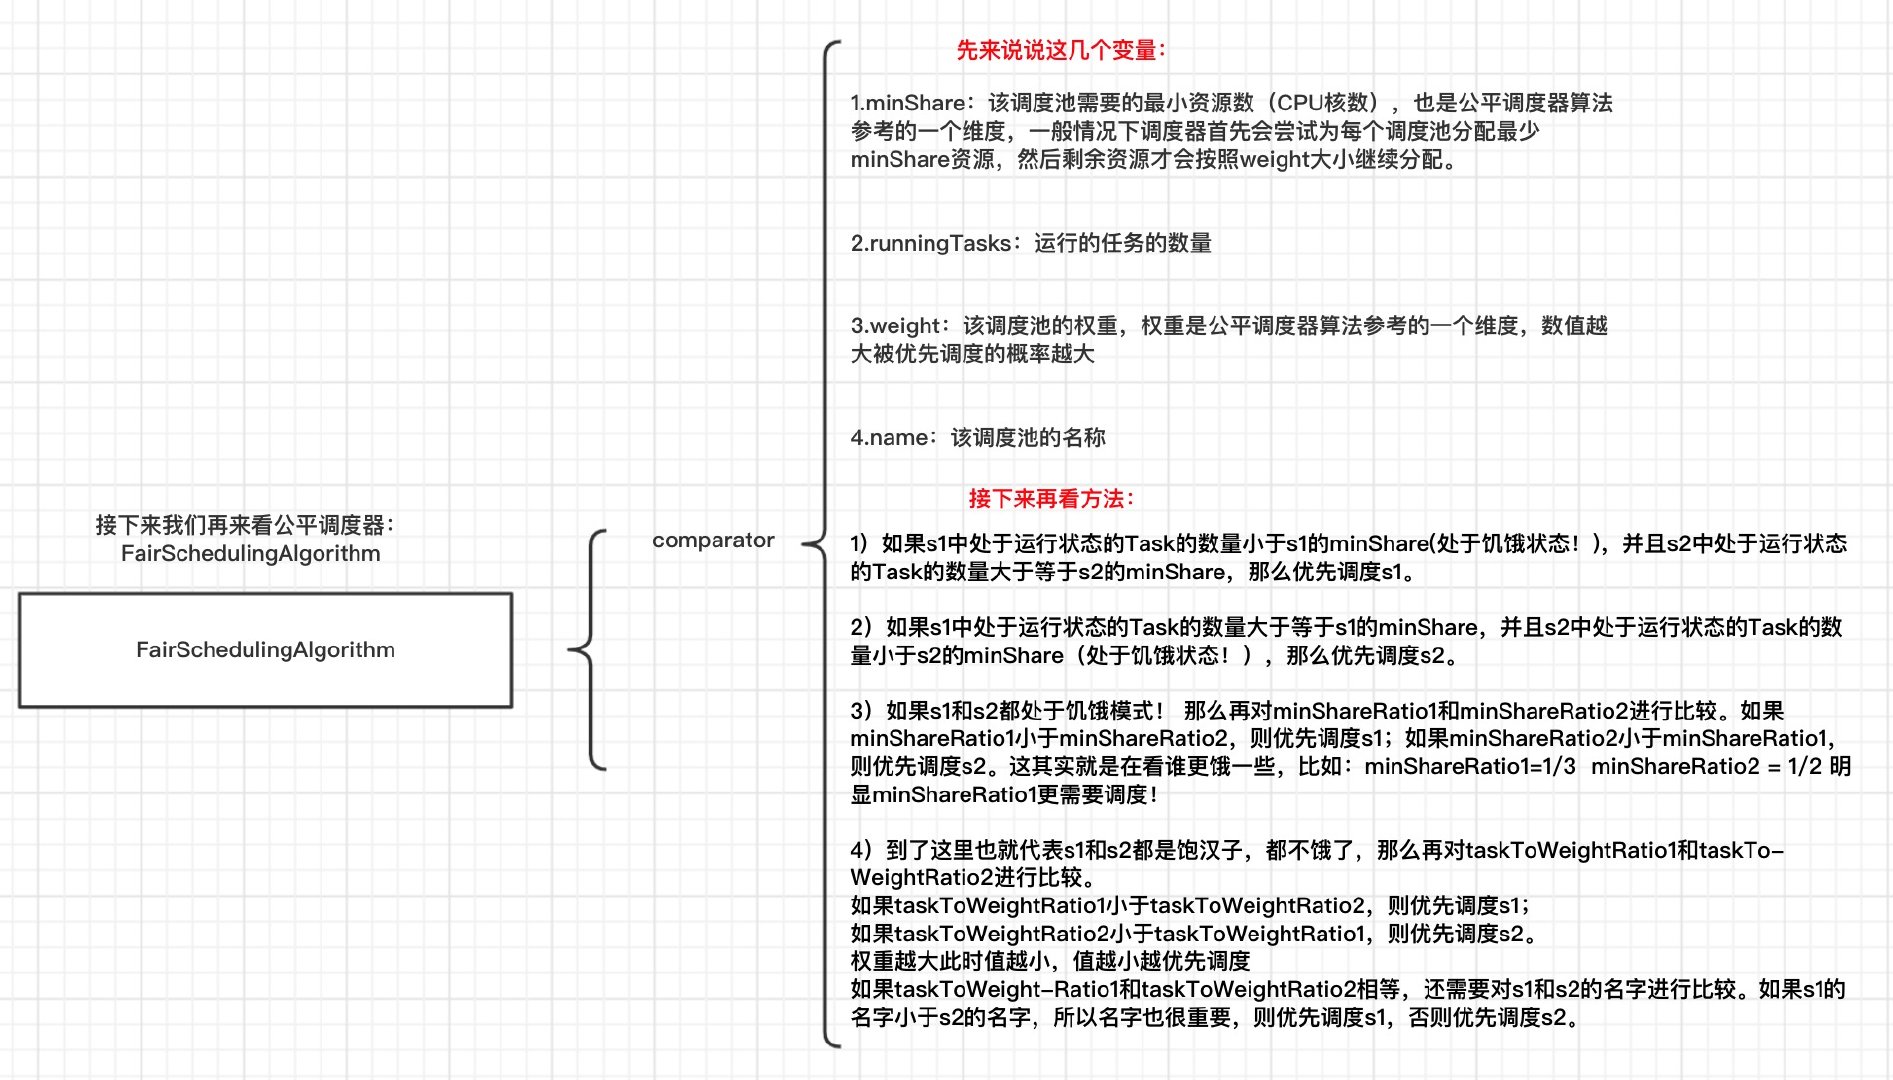
那么再回到getSortedTaskSetQueue函数中,第一层rootPool根据Fair比较之后,会再根据不同的Pool内部进行比较,拿默认的配置文件来说,会有一个test调度池,一个默认default调度池和一个production调度池;
这第一层顺序:production > test > default
随之而来的就是各个pool中内部TaskSetManager的排序
production调度池是Fair模式,故内部按照TaskSetManager的参数来按照Fair饥饿模式排序:

test调度池是FIFO模式,故会按照TaskManager的priority【jobId】顺序排序
default调度池是FIFO模式,故也会按照TaskManager的priority【jobId】顺序排序
看到获取规则后,再回到resourceOffers函数中,可以发现当内部排好序的taskSet集合给到TaskSchedulerImpl后会一次调用并执行,至此spark调度策略就结束了
以上就是spark调度器的设计思路,可以根据代码对照理解;
-
相关阅读:
萤火虫优化算法(FA)附matlab代码
leetcode-二叉树的镜像-91
【FAQ】视频直播点播平台EasyDSS如何单独保存录像计划文件?
17. 电话号码的字母组合
如何保护 PHP Web 应用程序并防止攻击?
java和设计模式(结构模式)
2310d模板替换运行时
【单调队列】
Python---内置方法
【10.30】【VP】Codeforces Round #735 (Div. 2)
- 原文地址:https://blog.csdn.net/qq_35128600/article/details/125535639

- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读