你有没有遇到过这样的怪事?
- 平时上班通勤只要 30 分钟,但上个月有一次居然堵了 2 个小时。
- 你们部门 10 个人的平均工资是 5 万,但因为老板拿了 200 万,平均值瞬间变成了“人均 24 万”,而你实际只拿 1 万。
如果你用我们熟悉的正态分布(钟形曲线) 来套这些场景,它会告诉你:“堵车 2 小时的概率低到几乎不可能,简直是个错误数据。”
但现实是,这种事就是会发生 ,而且发生的频率比你想象的高得多。
这时候,统计学里的“怪胎”—— 柯西分布(Cauchy Distribution) 就该登场了。
它专门用来描述这个世界里那些 “看起来极端,却经常发生” 的疯狂随机事件。
今天,我们就用最接地气的方式来认识这个“不走寻常路”的分布,并用 Python 看看它到底有多野。
扔掉“平均值”,理解柯西的叛逆精神
柯西分布长得有点像正态分布——中间高,两边低。但它有两个完全反叛的特性:
- 极高的峰值:它在中心区域比正态分布更“瘦高”,意味着数据非常集中。比如你觉得明天通勤大概率还是 30 分钟。
- 极重的尾巴(Heavy Tails):它的尾巴衰减得极其缓慢。这意味着,出现极端离谱数值的概率,比正态分布高出成千上万倍。
核心:柯西分布根本没有“均值”和“方差”!
什么意思呢?就是说,如果你不停地往柯西分布里加数据,它的平均值永远不会收敛到一个稳定数值。它像一个永远在躁动的赌徒,偶尔蹦出一个极端值,把所有的“平均计算”搅得天翻地覆。
在柯西的世界里,“平均”是个骗局,你只能依靠中位数或者直接看分布形状。
柯西分布由两个参数决定:
- 位置参数
x 0 - 尺度参数
γ " role="presentation"> :决定曲线有多“胖”或多“瘦”。γ " role="presentation"> 越大,中间的峰越矮,两边的尾巴越粗。
用 Python 画出来,看看它有多“狂野”
口说无凭,我们用代码把标准柯西分布(
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import cauchy, norm

x = np.linspace(-10, 10, 1000)

# 标准柯西和标准正态
cauchy_pdf = cauchy.pdf(x, loc=0, scale=1)
norm_pdf = norm.pdf(x, 0, 1)

plt.figure(figsize=(10, 6))
plt.plot(x, cauchy_pdf, label='柯西分布 (x₀=0, γ=1)', color='red', linewidth=2)
plt.plot(x, norm_pdf, label='正态分布 (均值=0, 标准差=1)', color='blue', linestyle='--')

plt.title('柯西 vs 正态:看看尾巴差距有多大!')
plt.xlabel('x')
plt.ylabel('概率密度')
plt.legend()
plt.xlim(-8, 8)  # 放大看尾巴
plt.show()
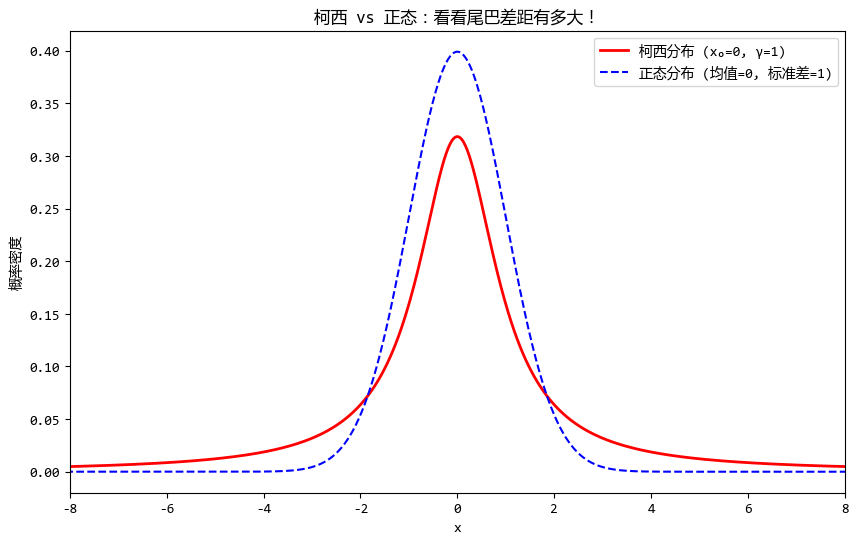
运行结果解读:在中心区域(-1 到 1),两者差不多。
但当你把目光移到 x=4 或 x=-4 的地方,你会惊讶地发现:柯西的尾巴依然翘着,而正态分布的尾巴几乎已经贴着地面(概率接近 0)了。
这意味着,在柯西分布眼里,偏离中心 4 个单位也不奇怪。
生成随机数:体验“命运过山车”
让我们用柯西分布来模拟一下“通勤时间的极端波动”。
假设你平时通勤时间中心点在 30 分钟(
from scipy.stats import cauchy

# 位置=30分钟,尺度=5分钟
x0, gamma = 30, 5
samples = cauchy.rvs(loc=x0, scale=gamma, size=1000)

# 看看结果
print(f"这 1000 次通勤的平均时长: {np.mean(samples):.2f} 分钟")
print(f"这 1000 次通勤的中位数时长: {np.median(samples):.2f} 分钟")
print(f"最夸张的一次通勤花了: {np.max(samples):.2f} 分钟")

# 简单画个直方图看看
plt.hist(samples, bins=50, density=True, alpha=0.6, color='orange')
plt.title('1000 次模拟通勤时长分布(柯西分布)')
plt.xlabel('通勤分钟数')
plt.ylabel('频率')
plt.xlim(0, 100)  # 只看前100分钟,不然极端值会拉爆坐标轴
plt.show()
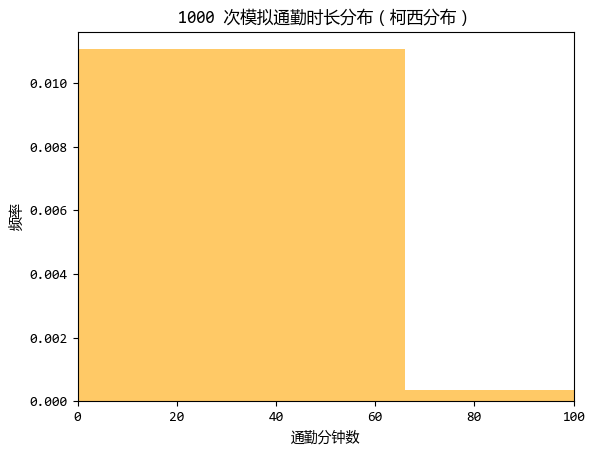
你运行这段代码会发现,平均值极不稳定!这一次可能是 35 分钟,下一次运行可能变成 50 分钟,因为某次抽到了“300 分钟”的超级大堵车,直接把平均值拉爆了。而中位数(50% 分位点)则非常稳定,始终在 30 左右。
下面是某一次的运行结果(多次运行,你会发现,每次运行结果都不一样,但是中位数时长很稳定)。
这 1000 次通勤的平均时长: 35.67 分钟
这 1000 次通勤的中位数时长: 29.61 分钟
最夸张的一次通勤花了: 3370.20 分钟
实战应用:给线性数据加上“现实噪音”
在机器学习中,我们经常给数据加噪声。如果加正态噪声,模型会认为“偏离一点是正常误差”。
但如果加柯西噪声,就是在模拟现实中最恶心的状况:传感器偶尔抽风、记账手滑多写个零、或者突然出现黑天鹅事件。
下面我们演示一个最简单的场景:我们有一条完美的直线 y = 2x + 1,但我们故意给它加上柯西分布的噪声,模拟真实世界中那些“离谱的异常值”。
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import cauchy

# 1. 生成完美的线性数据
x_values = np.linspace(-5, 5, 100)
true_y = 2 * x_values + 1

# 2. 加入柯西噪声(位置0,尺度1)
cauchy_noise = cauchy.rvs(loc=0, scale=1, size=100)
noisy_y = true_y + cauchy_noise

# 3. 画出来看看
plt.figure(figsize=(10, 6))
plt.scatter(x_values, noisy_y, color='red', s=10, label='带着柯西噪声的观测数据')
plt.plot(x_values, true_y, color='blue', linewidth=3, label='隐藏的真实直线')

plt.title('线性回归遇到柯西噪声:那些“飞出去”的红点')
plt.xlabel('x')
plt.ylabel('y')
plt.ylim(-20, 20)  # 为了看清主体,但有些点可能还在外面!
plt.legend()
plt.show()
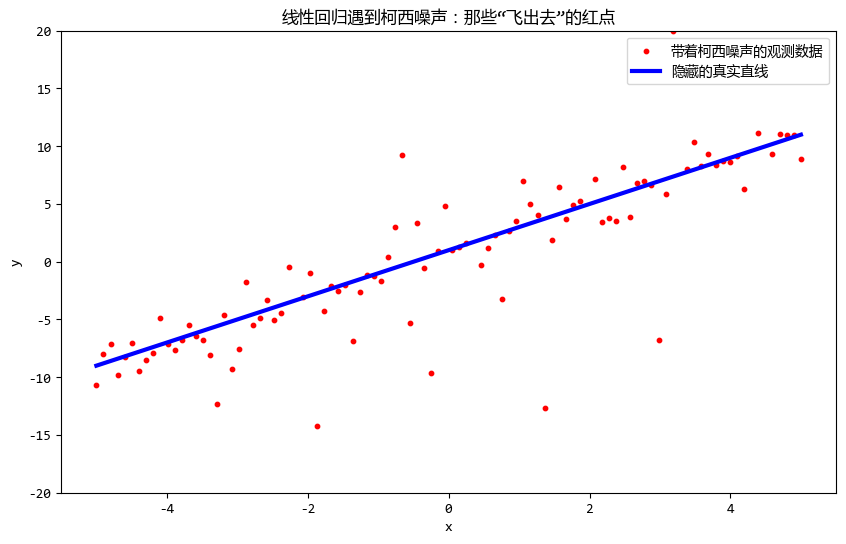
观察这张图,你会看到绝大多数红点紧密贴在蓝线周围,但总有那么几个红点像火箭一样飞到了天空或掉到了地底。
如果你用普通的“最小二乘法”(基于正态假设)去拟合这些红点,直线会被那几个飞出去的点严重带偏;而如果你改用“柯西分布”去建模误差(即稳健回归),那条线就能稳稳地穿过中心。
生活里的柯西分布
- 金融韭菜的觉悟:如果你在看股票收益率,正态分布会说“一天跌 10% 是千年一遇”,但柯西分布会告诉你“别天真了,这每隔几年就会来一次”。所以玩杠杆之前,想想柯西分布的尾巴。
- 社交媒体的流量玄学:你发了 10 条视频,9 条播放量 500,突然一条爆了 100 万。这个“爆款”概率在正态分布眼里是异常值,在柯西分布眼里却是“常规操作”。
- 体育爆冷:弱队战胜强队。如果只看球队平均实力(均值),爆冷几乎不可能;但用柯西分布的视角,极端发挥(超常发挥或失常)的概率远比你想象的大,这就是足球是圆的统计学解释。
快速上手代码模板(可直接复制用)
如果你在数据科学中怀疑数据“有鬼”(异常值极多),想用柯西分布来刻画,直接套用这个模板:
from scipy.stats import cauchy
import numpy as np

# 你的数据猜测:中心位置 x0,分散程度 gamma
# 注意:这里的 gamma 不是标准差!它只是尺度参数
x0, gamma = 你猜的中心值, 你猜的分散度

# 1. 计算某个特定值发生的概率(密度)
prob_at_point = cauchy.pdf(某个x值, loc=x0, scale=gamma)

# 2. 生成 100 个模拟的“极端场景”数据
simulated_data = cauchy.rvs(loc=x0, scale=gamma, size=100)

# 3. 如果你不想被极端值坑,用中位数估计中心
# 而不是用平均值(千万别用平均值!)
central_tendency = np.median(simulated_data)

# 4. 计算 95% 的可信区间(同样因为方差无限,只能用分位数)
lower = cauchy.ppf(0.025, loc=x0, scale=gamma)
upper = cauchy.ppf(0.975, loc=x0, scale=gamma)
print(f"主体数据 95% 落在: {lower:.2f} 到 {upper:.2f} 之间")
总结
柯西分布是大自然赐予我们的 “抗忽悠神器”。
它时时刻刻在提醒我们:
如果数据里存在巨大的不确定性,千万不要被漂亮的“平均值”迷惑,要睁大眼睛看尾巴。
当正态分布告诉你可以高枕无忧时,柯西分布会在角落里幽幽地说:“小心那个百年一遇的黑天鹅,它可能下个月就来。”
下次当你面对极端波动的数据时,记得请出柯西分布这位“叛逆天才”,它会给你带来截然不同的、更清醒的视角。