上一篇我们用 Kueue + NVIDIA 原生 DRA 跑通了 GPU 整卡配额:Job 先进入队列,Kueue 判断配额够不够,够了再放行给调度器。
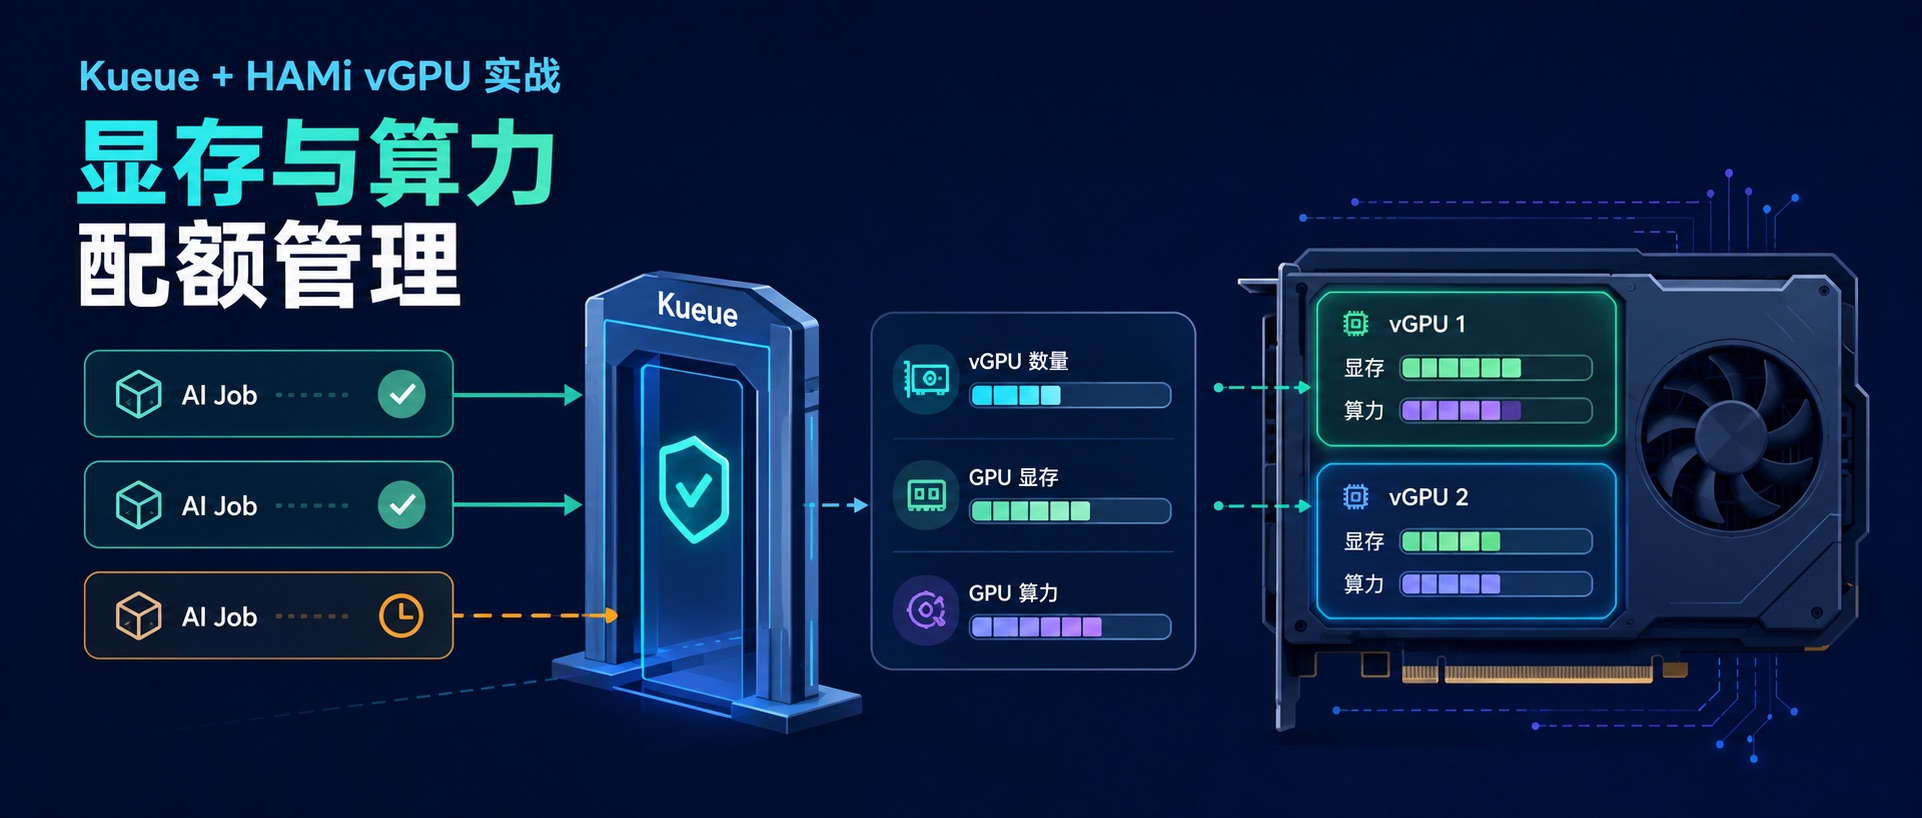
但整卡只是第一步。真实的 GPU 集群里,一张 GPU 往往不会只给一个 Pod 用,HAMi 可以继续按显存和算力切成 vGPU。问题也跟着来了:切完之后,队列系统还能不能知道每个任务用了多少?能不能做到两个任务放行、第三个因为显存或算力配额不够继续排队?
这篇就围绕这个问题跑一遍:HAMi 把 GPU 切给 Pod,Kueue 在 Job 准入阶段先把 vGPU、显存和算力配额算清楚。重点不是“能不能切卡”,而是“切完之后还能不能管起来”。
1. 环境准备
环境基本沿用上一篇 Kueue + NVIDIA DRA 的测试环境。区别只有两点:
- GPU Operator 关闭 DevicePlugin 安装
- 安装 HAMi 开启 DRA 模式
本文的命令和输出来自这套环境:
节点:lixd-test-gpu
GPU:1 x Tesla T4,15Gi 显存
K8s:1.36.1
containerd:2.2.4
Kueue:0.18.1
HAMi:2.9.0
HAMi Chart:2.9.0
K8s 集群、GPU Operator、Kueue 的安装过程前几篇已经写过,这里不再重复。需要确认的一点是:后面由 HAMi 接管 GPU 切分,所以 GPU Operator 安装时要关闭 NVIDIA DevicePlugin:
--set devicePlugin.enabled=false
节点上能看到 T4 即可:
$ kubectl get node lixd-test-gpu -o jsonpath='{.metadata.labels.nvidia\.com/gpu\.product}{"\n"}'
Tesla-T4
1.1 安装 HAMi
HAMi DRA Webhook 需要 TLS 证书,因此需要提前安装 cert-manager 用于自动签发。
helm repo add cert-manager https://charts.jetstack.io
helm repo update

helm install cert-manager cert-manager/cert-manager \
  -n cert-manager --create-namespace \
  --set crds.enabled=true
给节点打上 gpu=on 标签。未标记的节点不会被 HAMi 接管。
# kubectl label nodes {nodeid} gpu=on
kubectl label nodes lixd-test-gpu gpu=on --overwrite
安装 HAMi,并通过 --set dra.enabled=true 开启 DRA 模式:
helm repo add hami-charts https://project-hami.github.io/HAMi/
helm repo update

helm -n hami-system install hami hami-charts/hami \
  --version 2.9.0 \
  --set dra.enabled=true \
  --set devicePlugin.enabled=false \
  --create-namespace
注意:DRA 模式与传统模式不兼容,请勿同时启用。
gpu=on 主要给 HAMi 做节点选择。后面 ResourceFlavor 用的 nvidia.com/gpu.product=Tesla-T4,则是 GPU Operator / GFD 自动打到节点上的标签。
另外,如果 GPU 驱动是主机预装,非 GPU Operator 安装,则安装时需额外指定:
--set hami-dra.drivers.nvidia.containerDriver=false
1.2 验证 HAMi 已接管 GPU
HAMi 正常启动后,hami-system 下会看到三个核心组件:
$ kubectl get pods -n hami-system
NAME                                     READY   STATUS
hami-dra-driver-kubelet-plugin-fb4zm     1/1     Running
hami-hami-dra-monitor-7b8df84bd-jsjrd    1/1     Running
hami-hami-dra-webhook-7bb65cbcc5-g5742   1/1     Running
底层发布出来的 GPU 资源也要确认一下:
$ kubectl get deviceclass,resourceslice
NAME                                                        AGE
deviceclass.resource.k8s.io/hami-core-gpu.project-hami.io   32m

NAME                                                                              NODE            DRIVER
resourceslice.resource.k8s.io/lixd-test-gpu-hami-core-gpu.project-hami.io-2drs2   lixd-test-gpu   hami-core-gpu.project-hami.io
ResourceSlice 里记录了这张 T4 的显存和算力容量:
spec:
  devices:
  - allowMultipleAllocations: true
    attributes:
      productName:
        string: Tesla T4
      type:
        string: hami-gpu
    capacity:
      cores:
        value: "100"
      memory:
        value: 15Gi
    name: hami-gpu-0
  driver: hami-core-gpu.project-hami.io
需要注意的是 allowMultipleAllocations: true:同一张物理 GPU 可以被多个 ResourceClaim 消费,只要显存和算力容量还够,切卡才有空间。
2. 资源模型:为什么选择兼容模式
对 HAMi 不熟悉的同学可以先看看这篇文章:Kubernetes GPU 虚拟化实战:HAMi DRA 模式完整指南
HAMi DRA 现在有两种使用方式:
| 模式 | 用户怎么写 | 谁创建底层设备申请 | 更适合什么场景 |
|---|---|---|---|
| DRA 原生模式 | 手写 ResourceClaim / ResourceClaimTemplate |
用户 | 新业务直接接 DRA API |
| 兼容模式 | 写 nvidia.com/gpu/gpumem/gpucores |
HAMi webhook | 存量 HAMi 业务迁移 |
我这次实测下来,Kueue 接 HAMi 原生 DRA 时,更容易先做到按 claim / 设备数量做准入;但要把 gpumem/gpucores 也纳入 Kueue 配额,兼容模式反而更顺:业务侧仍然写 nvidia.com/gpu/gpumem/gpucores,Kueue 通过 ResourceTransformation 把它们折算成队列里的总量配额资源。
所以这篇走兼容模式,业务 YAML 继续写熟悉的 HAMi 资源:
resources:
  limits:
    nvidia.com/gpu: 1
    nvidia.com/gpumem: 4096
    nvidia.com/gpucores: 50
含义是:
| 资源 | 含义 |
|---|---|
nvidia.com/gpu: 1 |
申请 1 个 vGPU 设备实例 |
nvidia.com/gpumem: 4096 |
每个 vGPU 申请 4096Mi 显存 |
nvidia.com/gpucores: 50 |
每个 vGPU 申请 50% 算力 |
HAMi webhook 会拦截这个 Pod,把上面的资源申请转换成底层设备申请。调度时,kube-scheduler 看到的是 HAMi 发布出来的 GPU 设备,以及对应的显存、算力容量。
3. Demo:Kueue 管理 HAMi vGPU 配额
这里用一个最小例子把链路跑通。先验证 HAMi 能不能切出 4Gi / 50 cores;确认没有问题以后,再接入 Kueue,观察它会不会在准入阶段扣配额。
3.1 先跑通 HAMi vGPU
为了把变量降到最低,先不接 Kueue,直接提交一个 Pod:
apiVersion: v1
kind: Pod
metadata:
  name: hami-compatible-smoke
spec:
  restartPolicy: Never
  containers:
  - name: cuda
    image: nvcr.io/nvidia/cuda:12.6.0-base-ubuntu24.04
    command: ["bash", "-c", "nvidia-smi && sleep 3600"]
    resources:
      limits:
        nvidia.com/gpu: 1
        nvidia.com/gpumem: 4096
        nvidia.com/gpucores: 50
Pod 创建后,HAMi webhook 会把原始资源申请改成 ResourceClaim:
spec:
  containers:
  - name: cuda
    resources:
      claims:
      - name: hami-kueue-demo-hami-compatible-smoke-cuda
  resourceClaims:
  - name: hami-kueue-demo-hami-compatible-smoke-cuda
    resourceClaimName: hami-kueue-demo-hami-compatible-smoke-cuda
对应的 ResourceClaim 如下:
spec:
  devices:
    requests:
    - exactly:
        allocationMode: ExactCount
        capacity:
          requests:
            cores: "50"
            memory: "4294967296"
        count: 1
        deviceClassName: hami-core-gpu.project-hami.io
      name: gpu
status:
  allocation:
    devices:
      results:
      - consumedCapacity:
          cores: "50"
          memory: 4Gi
        device: hami-gpu-0
        driver: hami-core-gpu.project-hami.io
容器里看到的显存也变成了 4096Mi:
$ kubectl exec hami-compatible-smoke -- nvidia-smi
|   0  Tesla T4  ...  |       0MiB /   4096MiB |      0%      Default |
到这里可以确认 HAMi vGPU 已经生效:业务 YAML 仍然写 nvidia.com/gpu/gpumem/gpucores,容器里实际只看到被切分后的 4096Mi 显存。
3.2 让 Kueue 能看懂 gpumem/gpucores
HAMi 验证通过后,就可以把 Kueue 接进来了。接入前需要先把配额口径捋清楚:HAMi 的 nvidia.com/gpumem 和 nvidia.com/gpucores 是“每个 vGPU”的资源。比如这次 Demo 里有两个相同规格的 Job,每个 Job 都申请:
nvidia.com/gpu: 1
nvidia.com/gpumem: 4096
nvidia.com/gpucores: 50
那么队列整体在配额上应该按总量扣减:
vGPU 个数:2
总显存:2 x 4096Mi = 8192Mi
总算力:2 x 50 = 100
Kueue 管队列配额时应该看总量,所以要在 Kueue 配置里加 ResourceTransformation。这次用的是 Kueue 0.18.1:
apiVersion: config.kueue.x-k8s.io/v1beta2
kind: Configuration
integrations:
  frameworks:
  - batch/job
resources:
  transformations:
  - input: nvidia.com/gpumem
    strategy: Replace
    outputs:
      nvidia.com/total-gpumem: 1
    multiplyBy: nvidia.com/gpu
  - input: nvidia.com/gpucores
    strategy: Replace
    outputs:
      nvidia.com/total-gpucores: 1
    multiplyBy: nvidia.com/gpu
这几行最关键的是两个动作:
- Workload 里不再直接统计
nvidia.com/gpumem - 改成统计
nvidia.com/total-gpumem gpucores同理,转成nvidia.com/total-gpucoresmultiplyBy: nvidia.com/gpu表示先乘以 vGPU 个数,再进入 Kueue 配额
修改 kueue-manager-config 后重启 Kueue:
kubectl rollout restart deployment/kueue-controller-manager -n kueue-system
kubectl rollout status deployment/kueue-controller-manager -n kueue-system
3.3 配置 Kueue 队列
这次只用一个队列,把资源扣减先看清楚。
场景:
物理资源:1 x Tesla T4,15Gi 显存
队列配额:最多准入 2 个 vGPU、8192Mi 显存、100 cores
单个 Job:1 个 vGPU、4Gi 显存、50 cores

预期:
第 1 个 Job:准入
第 2 个 Job:准入
第 3 个 Job:配额不够,继续 Suspended
Kueue 配置:
apiVersion: v1
kind: Namespace
metadata:
  name: hami-kueue-demo
---
apiVersion: kueue.x-k8s.io/v1beta2
kind: ResourceFlavor
metadata:
  name: hami-t4
spec:
  nodeLabels:
    nvidia.com/gpu.product: Tesla-T4
---
apiVersion: kueue.x-k8s.io/v1beta2
kind: ClusterQueue
metadata:
  name: hami-cq
spec:
  namespaceSelector: {}
  resourceGroups:
  - coveredResources:
    - nvidia.com/gpu
    - nvidia.com/total-gpumem
    - nvidia.com/total-gpucores
    flavors:
    - name: hami-t4
      resources:
      - name: nvidia.com/gpu
        nominalQuota: 2
      - name: nvidia.com/total-gpumem
        nominalQuota: 8192
      - name: nvidia.com/total-gpucores
        nominalQuota: 100
---
apiVersion: kueue.x-k8s.io/v1beta2
kind: LocalQueue
metadata:
  namespace: hami-kueue-demo
  name: hami-queue
spec:
  clusterQueue: hami-cq
这里的显存配额写 8192,和业务侧的 nvidia.com/gpumem: 4096 保持同一个口径:单位都是 Mi。单个 Job 会被 Kueue 统计成 nvidia.com/total-gpumem: 4096,两个相同 Job 加起来就是 8192。
3.4 提交 Kueue 管理的 HAMi Job
提交一个 4Gi / 50 cores 的 Job:
apiVersion: batch/v1
kind: Job
metadata:
  namespace: hami-kueue-demo
  name: hami-kueue-running-a
  labels:
    kueue.x-k8s.io/queue-name: hami-queue
spec:
  suspend: true
  parallelism: 1
  completions: 1
  template:
    spec:
      restartPolicy: Never
      containers:
      - name: cuda
        image: nvcr.io/nvidia/cuda:12.6.0-base-ubuntu24.04
        command: ["bash", "-c", "nvidia-smi && echo HAMI_KUEUE_RUNNING_A && sleep 3600"]
        resources:
          limits:
            nvidia.com/gpu: 1
            nvidia.com/gpumem: 4096
            nvidia.com/gpucores: 50
结果:
$ kubectl get job,pod,workload
NAME                             STATUS    COMPLETIONS
job.batch/hami-kueue-running-a   Running   0/1

NAME                             READY   STATUS
pod/hami-kueue-running-a-dzjrz   1/1     Running

NAME                                                    QUEUE        RESERVED IN   ADMITTED
workload.kueue.x-k8s.io/job-hami-kueue-running-a-59997   hami-queue   hami-cq       True
看 Workload 的准入结果:
status:
  admission:
    clusterQueue: hami-cq
    podSetAssignments:
    - count: 1
      flavors:
        nvidia.com/gpu: hami-t4
        nvidia.com/total-gpucores: hami-t4
        nvidia.com/total-gpumem: hami-t4
      resourceUsage:
        nvidia.com/gpu: "1"
        nvidia.com/total-gpucores: "50"
        nvidia.com/total-gpumem: "4096"
这个结果就是 Kueue 介入后的关键变化:Pod 还没进入调度阶段,Workload 已经先按 vGPU 个数、总显存、总算力扣了一次配额。
HAMi 生成的 ResourceClaim 也可以对上:
status:
  allocation:
    devices:
      results:
      - consumedCapacity:
          cores: "50"
          memory: 4Gi
        device: hami-gpu-0
        driver: hami-core-gpu.project-hami.io
容器里也能看到 4096Mi 显存上限:
$ kubectl exec hami-kueue-running-a-dzjrz -- nvidia-smi
|   0  Tesla T4  ...  |       0MiB /   4096MiB |      0%      Default |
3.5 验证配额阻塞
继续提交两个相同规格的 Job:
hami-kueue-running-a:1 vGPU + 4096Mi + 50 cores
hami-kueue-running-b:1 vGPU + 4096Mi + 50 cores
hami-kueue-pending-c:1 vGPU + 4096Mi + 50 cores
队列总配额是:
2 vGPU + 8192Mi + 100 cores
因此第 2 个 Job 可以准入,第 3 个 Job 会继续留在队列里:
$ kubectl get job,workload
NAME                             STATUS
job.batch/hami-kueue-running-a   Running
job.batch/hami-kueue-running-b   Running
job.batch/hami-kueue-pending-c   Suspended

NAME                                                     QUEUE        RESERVED IN   ADMITTED
workload.kueue.x-k8s.io/job-hami-kueue-running-a-59997   hami-queue   hami-cq       True
workload.kueue.x-k8s.io/job-hami-kueue-running-b-9d737   hami-queue   hami-cq       True
workload.kueue.x-k8s.io/job-hami-kueue-pending-c-d854d   hami-queue
ClusterQueue 的用量已经打满:
status:
  admittedWorkloads: 2
  flavorsUsage:
  - name: hami-t4
    resources:
    - name: nvidia.com/gpu
      total: "2"
    - name: nvidia.com/total-gpucores
      total: "100"
    - name: nvidia.com/total-gpumem
      total: "8192"
  pendingWorkloads: 1
Pending Workload 里能看到原因:
status:
  conditions:
  - reason: Pending
    message: 'couldn''t assign flavors to pod set main: insufficient unused quota
      for nvidia.com/gpu in flavor hami-t4, 1 more needed, insufficient unused quota
      for nvidia.com/total-gpucores in flavor hami-t4, 50 more needed'
  resourceRequests:
  - resources:
      nvidia.com/gpu: "1"
      nvidia.com/total-gpucores: "50"
      nvidia.com/total-gpumem: "4096"
这也是我更关心的点:不是等 Pod 到调度阶段才 Pending,而是在 Job 准入阶段就把超配额任务留在队列里。
4. 容易踩的坑
不要写小数 GPU
第一个坑是小数 GPU。不要写 nvidia.com/gpu: "0.5"。
Kubernetes 扩展资源必须是整数,而且 GPU 这类不可超卖资源要写在 limits 里。正确写法是:
resources:
  limits:
    nvidia.com/gpu: 1
    nvidia.com/gpumem: 4096
    nvidia.com/gpucores: 50
半张卡 这种说法在 HAMi 里应该理解成:1 个 vGPU 实例 + 部分显存 + 部分算力,不是 0.5 个 nvidia.com/gpu。
Kueue 需要做资源转换
只把 nvidia.com/gpu 放进 Kueue,只能限制 vGPU 个数,管不了显存和算力。
要把 HAMi 的切分资源纳入 Kueue 配额,需要做这两个转换:
nvidia.com/gpumem   -> nvidia.com/total-gpumem
nvidia.com/gpucores -> nvidia.com/total-gpucores
ClusterQueue 里也要同时配置这三个资源:
coveredResources:
- nvidia.com/gpu
- nvidia.com/total-gpumem
- nvidia.com/total-gpucores
5. 小结
这一篇跑完后,Kueue 系列基本就从 CPU 队列一路串到了 GPU 整卡和 HAMi vGPU。真落到 GPU 集群里,光能切卡还不够,准入和配额也一样重要: GPU 虚拟化解决的是"怎么切",Kueue 解决的是"谁先用、谁能用多少"。两者结合起来,GPU 集群才真正具备了多租户管理能力。