-
Hmmer安装与使用-Hmmer-3.3.2(bioinfomatics tools-009)
01 背景
HMMER用于搜索序列数据库以查找序列同源物,并进行序列比对。它实现了使用概率模型称为Profile Hidden Markov Models(profile HMMs)的方法。
HMMER通常与profile数据库一起使用,例如Pfam或许多参与Interpro的数据库。但是,HMMER也可以使用查询序列,而不仅仅是profiles,就像BLAST一样。例如,您可以使用phmmer对蛋白质查询序列进行数据库搜索,或者使用jackhmmer进行迭代搜索。
HMMER旨在尽可能敏感地检测远程同源物,依赖于其基础概率模型的强度。过去,这种强度表现为对其概率模型的依赖。
1.1 Hmmer软件
HMMER搜索生物序列数据库以寻找同源序列,可以使用单个序列或多序列比对作为查询。HMMER实现了一种称为“profile hidden Markov models”(profile HMMs)的技术。HMMER被许多蛋白质家族领域数据库和大规模注释流水线使用,包括InterPro联盟的许多成员。
1.2 原理
Profile hidden Markov models (profile HMMs) 是一种用于序列分析的统计模型,通常用于对生物学序列进行建模和比较,如蛋白质序列或DNA序列。它们是隐马尔可夫模型(HMM)的一种扩展,结合了多序列比对(multiple sequence alignment)和隐马尔可夫模型的思想。
Profile HMMs的原理包括以下几个关键点:
1. 多序列比对(multiple sequence alignment): Profile HMMs通过对多个相关序列进行比对,提取序列间的共同模式和保守特征。这些模式可以用来建立HMM的发射概率。
2. 隐马尔可夫模型(HMM):Profile HMMs是一种HMM,其中隐藏状态表示生物学序列中的不同部分(例如,蛋白质的结构域或功能区域),而观察状态表示序列中的碱基或氨基酸。
3. 状态转移概率(transition probabilities):Profile HMMs通过学习从一个状态到另一个状态的转移概率来建模序列中的转换模式,如从一个结构域到另一个结构域的转换。
4. 发射概率(emission probabilities):Profile HMMs使用从多序列比对中得到的信息来计算从隐藏状态到观察状态的发射概率,表示给定隐藏状态下观察到特定观察状态的概率。
通过这些原理,Profile HMMs可以用来搜索数据库中的序列,进行序列分类、注释和比较,以及预测未知序列的功能和结构。
02 参考
- http://eddylab.org/software/hmmer #官网
- https://github.com/EddyRivasLab/hmmer #github
03 安装
- wget -c http://eddylab.org/software/hmmer/hmmer-3.3.2.tar.gz #下载
- tar -zxvf hmmer-3.3.2.tar.gz #解压
- cd
- mkdir ../hmmerlocation #创建安装目录
- ./configure --prefix=./hmmerlocation #配置
- Now do 'make' to build HMMER, and optionally:
- 'make check' to run self tests,
- 'make install' to install programs and man pages,
- '(cd easel; make install)' to install Easel tools.
- make
- make install
- 或者下面这个方法
- % wget http://eddylab.org/software/hmmer/hmmer.tar.gz
- % tar zxf hmmer.tar.gz
- % cd hmmer-3.4
- % ./configure --prefix /your/install/path # replace /your/install/path with what you want, obv
- % make
- % make check # optional: run automated tests
- % make install # optional: install HMMER programs, man pages
- % (cd easel; make install) # optional: install Easel tools
04 使用
这里是官方文档连接Userguide.pdf (eddylab.org),本文也有下载链接,PDF附后。
里面有许多程序,如下:
alimask hmmalign hmmbuild hmmconvert hmmemit hmmfetch hmmlogo hmmpgmd hmmpgmd_shard hmmpress hmmscan hmmsearch hmmsim hmmstat jackhmmer makehmmerdb nhmmer nhmmscan phmmer常用3个程序。
4.1 hmmpress
- ./hmmpress -h
- # hmmpress :: 准备一个用于更快速 hmmscan 搜索的 HMM 数据库
- # HMMER 3.3.2 (Nov 2020); http://hmmer.org/
- # 版权所有 (C) 2020 年 Howard Hughes Medical Institute。
- # 在 BSD 开源许可下自由分发。
- # - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - -
- 用法:hmmpress [-options]
- 选项:
- -h :显示版本和用法的简要帮助
- -f :强制:覆盖任何先前压缩的文件
4.2 hmmscan
- ./hmmscan -h
- # hmmscan :: 将序列与配置文件数据库进行比对
- # HMMER 3.3.2(2020年11月);http://hmmer.org/
- # 版权所有 (C) 2020 Howard Hughes Medical Institute.
- # 根据BSD开源许可证自由分发。
- # - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - -
- 用法:hmmscan [-选项]
- 基本选项:
- -h :显示版本和用法的简要帮助
- 控制输出的选项:
- -o
:将输出直接定向到文件 ,而不是标准输出 - --tblout
:将每个序列的可解析表格保存到文件 - --domtblout
:将每个域的可解析表格保存到文件 - --pfamtblout
:将命中和域的表格保存到文件中,以Pfam格式 - --acc :在输出中优先使用访问号而非名称
- --noali :不输出对齐,因此输出更小
- --notextw :取消ASCII文本输出行宽的限制
- --textw
:设置ASCII文本输出行的最大宽度 [120] (n>=120) - 控制报告阈值的选项:
- -E
:在输出中报告<=此E值阈值的模型 [10.0] (x>0) - -T
:在输出中报告>=此分数阈值的模型 - --domE
:在输出中报告<=此E值阈值的域 [10.0] (x>0) - --domT
:在输出中报告>=此分数截止的域 - 控制包含(显著性)阈值的选项:
- --incE
:将<=此E值阈值的模型视为显著 - --incT
:将>=此分数阈值的模型视为显著 - --incdomE
:将<=此E值阈值的域视为显著 - --incdomT
:将>=此分数阈值的域视为显著 - 模型特定阈值的选项:
- --cut_ga :使用配置文件的GA收集截断来设置所有阈值
- --cut_nc :使用配置文件的NC噪声截断来设置所有阈值
- --cut_tc :使用配置文件的TC可信截断来设置所有阈值
- 控制加速启发式的选项:
- --max :关闭所有启发式过滤器(减少速度,增加功率)
- --F1
:MSV阈值:提升P <= F1的命中 [0.02] - --F2
:Vit阈值:提升P <= F2的命中 [1e-3] - --F3
:Fwd阈值:提升P <= F3的命中 [1e-5] - --nobias :关闭组成
- 偏差过滤器
- 其他专家选项:
- --nonull2 :关闭偏倚组成分数修正
- -Z
:设置E值计算完成的比较数 - --domZ
:设置域E值计算的显著序列数 - --seed
:将RNG种子设置为 (如果0:一次性任意种子) [42] - --qformat
:断言输入的格式为 :不自动检测 - --cpu
:用于多线程的并行CPU工作数 [2]
4.3 hmmsearch
- hmmsearch :: 将配置文件搜索与序列数据库进行比对
- # HMMER 3.3.2(2020年11月);http://hmmer.org/
- # 版权所有 (C) 2020 Howard Hughes Medical Institute.
- # 根据BSD开源许可证自由分发。
- # - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - - -
- 用法:hmmsearch [选项]
- 基本选项:
- -h :显示版本和用法的简要帮助
- 指导输出的选项:
- -o
:将输出直接定向到文件 ,而不是标准输出 - -A
:将所有命中的多重序列对齐保存到文件 - --tblout
:将每个序列的可解析表格保存到文件 - --domtblout
:将每个域的可解析表格保存到文件 - --pfamtblout
:将命中和域的表格保存到文件中,以Pfam格式 - --acc :在输出中优先使用访问号而非名称
- --noali :不输出对齐,因此输出更小
- --notextw :取消ASCII文本输出行宽的限制
- --textw
:设置ASCII文本输出行的最大宽度 [120] (n>=120) - 控制报告阈值的选项:
- -E
:在输出中报告<=此E值阈值的序列 [10.0] (x>0) - -T
:在输出中报告>=此分数阈值的序列 - --domE
:在输出中报告<=此E值阈值的域 [10.0] (x>0) - --domT
:在输出中报告>=此分数截止的域 - 控制包含(显著性)阈值的选项:
- --incE
:将<=此E值阈值的序列视为显著 - --incT
:将>=此分数阈值的序列视为显著 - --incdomE
:将<=此E值阈值的域视为显著 - --incdomT
:将>=此分数阈值的域视为显著 - 控制模型特定阈值的选项:
- --cut_ga :使用配置文件的GA收集截断来设置所有阈值
- --cut_nc :使用配置文件的NC噪声截断来设置所有阈值
- --cut_tc :使用配置文件的TC可信截断来设置所有阈值
- 控制加速启发式的选项:
- --max :关闭所有启发式过滤器(减少速度,增加功率)
- --F1
:第一阶段(MSV)阈值:提升P <= F1的命中 [0.02] - --F2
:第二阶段(Vit)阈值:提升P <= F2的命中 [1e-3] - --F3
:第三阶段(Fwd)阈值:提升P <= F3的命中 [1e-5] - --nobias :关闭组成偏差过滤器
- 其他专家选项:
- --nonull2 :关闭偏倚组成分数修正
- -Z
:设置E值计算完成的比较数 - --domZ
:设置域E值计算的显著序列数 - --seed
:将RNG种子设置为 (如果0:一次性任意种子) [42] - --tformat
:断言目标的格式为 :不自动检测 - --cpu
:用于多线程的并行CPU工作数 [2]
05 常用命令行
一般而言,hmmer为Pfamscan,InterProscan,Kofamscan的依赖调用程序,很少单独使用,大家用的都是他的隐马算法,这个算法好多程序或软件都内嵌了。常用搜索蛋白结构域隐马模型,这个在Pfam数据库下载,比如糖基转移酶的隐马模型是什么,萜类合成MEV、MEP通路相关酶的隐马模型是什么?下载即可,Pfam官网连接Search - InterPro (ebi.ac.uk)或者Pfam is now hosted by InterPro (xfam.org),如何配合Pfam数据库使用详见后续栏目。
5.1 利用 hmmer 构建隐马尔可夫模型并寻找同源基因操作如下:
- hmmsearch XXX目标蛋白隐马模型文件 XXX.fa --tblout XXX.fa.hmmerresults
- #根据目标蛋白隐马模型进行隐马计算,查找匹配的蛋白序列
有个有意思的文章:基于HMMER算法鉴定基因家族在本科创新实验中的设计与实践 [J]. 生物化工, 2022, 8 (02): 91-94. 提到,大家可以参考学习一下,课堂上学的和实际应用的区别还是很大的,具体还是推荐比较学习,参考官方protocol文档。
HMMER是一种基于隐马尔可夫模型(HMM)的深度学习算法,现已成为代替BLAST算法进行基因家族鉴定的有力工具。为了让学生更好地理解该算法,本实验教学采用学生自主挑选的目标物种与基因家族,通过HMMER-3.1软件在全基因组水平对基因家族成员进行分析。以高粱SBP(SQUAMOSA Promoter Binding Protein)为目标家族,进行全基因组筛选,然后利用SMART、Pfam、NCBICD进行验证,通过MG2C、GSDS2.0等工具完成数据可视化。结果显示,高粱SBP家族共有19位成员,且成员结构具有相似性。该创新实验促进了学生对基因家族的了解以及对全基因组鉴定的认识,进一步提升了学生的实验与科研能力。
本质上也是和blast一样的比对预测工具,blast原理以及应用介绍详见Blast安装及使用-Blast+2.14.0(bioinfomatics tools-001)
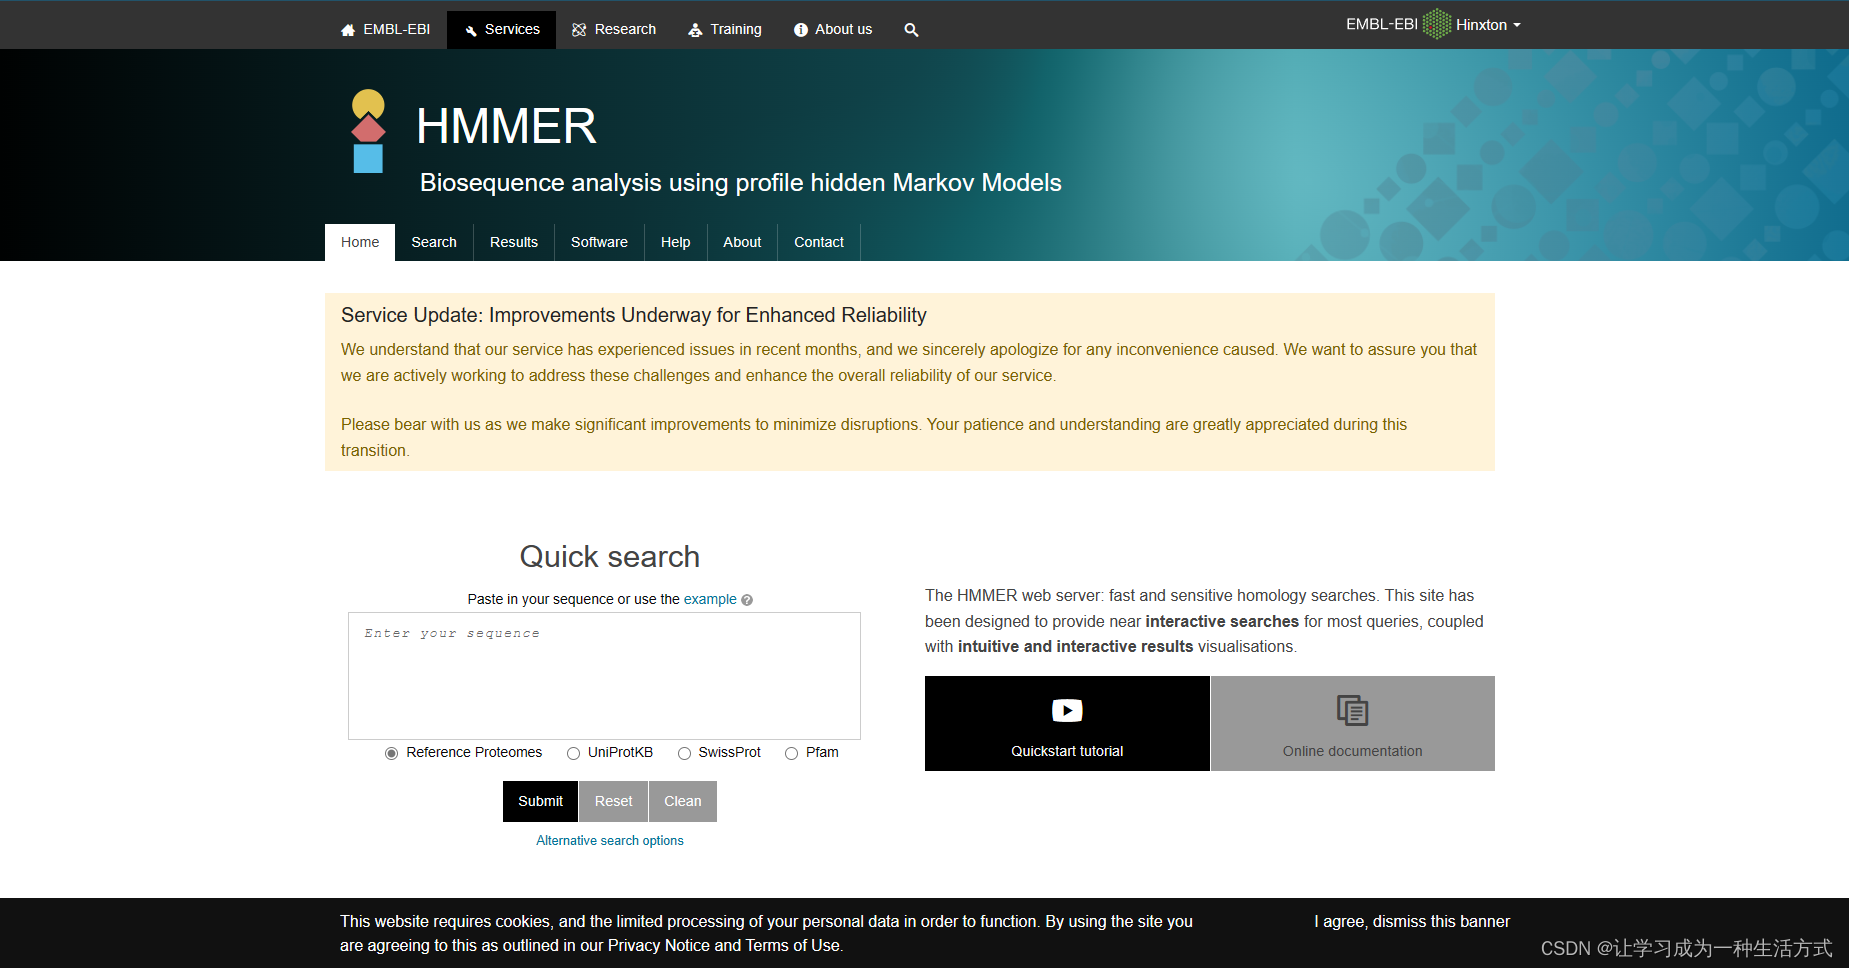
5.2 在线版
https://www.ebi.ac.uk/Tools/hmmer/
Biosequence analysis using profile hidden Markov Models | HMMER (ebi.ac.uk)
06 参考文献
Simon C Potter, Aurélien Luciani, Sean R Eddy, Youngmi Park, Rodrigo Lopez, Robert D Finn, HMMER web server: 2018 update, Nucleic Acids Research, Volume 46, Issue W1, 2 July 2018, Pages W200–W204, HMMER web server: 2018 update | Nucleic Acids Research | Oxford Academic
江霜艳. 基于排序方法的蛋白质远同源性检测[D].哈尔滨工业大学,2020.DOI:10.27061/d.cnki.ghgdu.2018.000704.
裴会敏,方远鹏,王芬等. 基于HMMER算法鉴定基因家族在本科创新实验中的设计与实践 [J]. 生物化工, 2022, 8 (02): 91-94.
王晶,张丽伟,刘春燕等. HMMER及同源比对预测大豆病程相关蛋白 [J]. 基因组学与应用生物学, 2011, 30 (06): 649-656. -
相关阅读:
十五分钟上手JavaScript之面向对象
串的KMP算法匹配实现
隐私交易:DeFi 发展新的突破口,Unijoin 将成为隐私交易潜力黑马
如何利用快解析远程访问家庭智能网关
iOS CoreMotion获取传感器数据
流血、止血、再造血,AI独角兽们何时涅槃?
基于Java的医院预约挂号管理系统设计与实现(源码+lw+部署文档+讲解等)
2022.8.4 模拟赛
面试字节,过关斩将直接干到 3 面,结果被吊打了?
[极致用户体验] 我做的《联机五子棋》是如何追求极致用户体验的?(上)
- 原文地址:https://blog.csdn.net/weixin_44874487/article/details/136573973

- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读