-
【C++】Map和Set -- 详解
一、关联式容器
在初阶阶段,我们已经接触过 STL 中的部分容器,比如:vector、list、deque、forward_list(C++11)等,这些容器统称为 序列式容器 ,因为其底层为线性序列的数据结构,里面存储的是元素本身。什么是关联式容器?它与序列式容器有什么区别?
关联式容器 也是用来存储数据的,与序列式容器不同的是,其里面存储的是
二、键值对 -- pair
用来表示具有一一对应关系的一种结构,该结构中一般只包含两个成员变量 key 和 value,key 代 表键值,value 表示与 key 对应的信息。比如:现在要建立一个英汉互译的字典,那该字典中必然有英文单词与其对应的中文含义,而且,英文单词与其中文含义是一一对应的关系,即通过该应该单词,在词典中就可以找到与其对应的中文含义。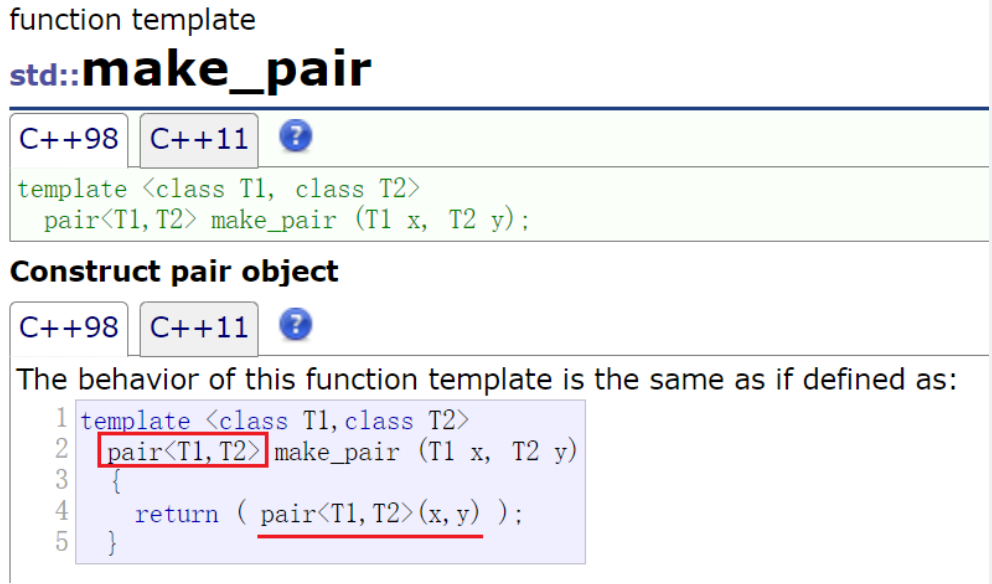
SGI-STL 中关于键值对的定义:map 中存放的元素是一个个的键值对(即 pair 对象)。
- // map中存的是一个pair结构体,key和value被封装在里面
- template <class T1, class T2>
- struct pair
- {
- typedef T1 first_type; // 键值对中key的类型
- typedef T2 second_type; // 键值对中value的类型
- T1 first; // first相当于key
- T2 second; // second相当于value
- // 构造函数
- pair()
- : first(T1())
- , second(T2())
- {}
- // 拷贝构造函数
- pair(const T1& a, const T2& b)
- : first(a)
- , second(b)
- {}
- };
构造一个 pair 对象(键值对):
std::pair<int, int> p(10, 20);利用 make_pair 函数模板构造一个 pair 对象(键值对),通过传递给 make_pair 的参数隐式推导出来。
std::pair<int,int> p = std::make_pair(10,20); // 常用这种构造方式
三、树形结构的关联式容器
根据应用场景的不桶,STL 总共实现了两种不同结构的管理式容器:树型结构与哈希结构。树型结 构的关联式容器主要有四种:map、set、multimap、multiset。这四种容器的共同点是:使用平衡搜索树(即 红黑树 )作为其底层结果,容器中的元素是一个 有序 的序列。1、set(集合)
(1)set 的介绍
set - C++ Reference (cplusplus.com)
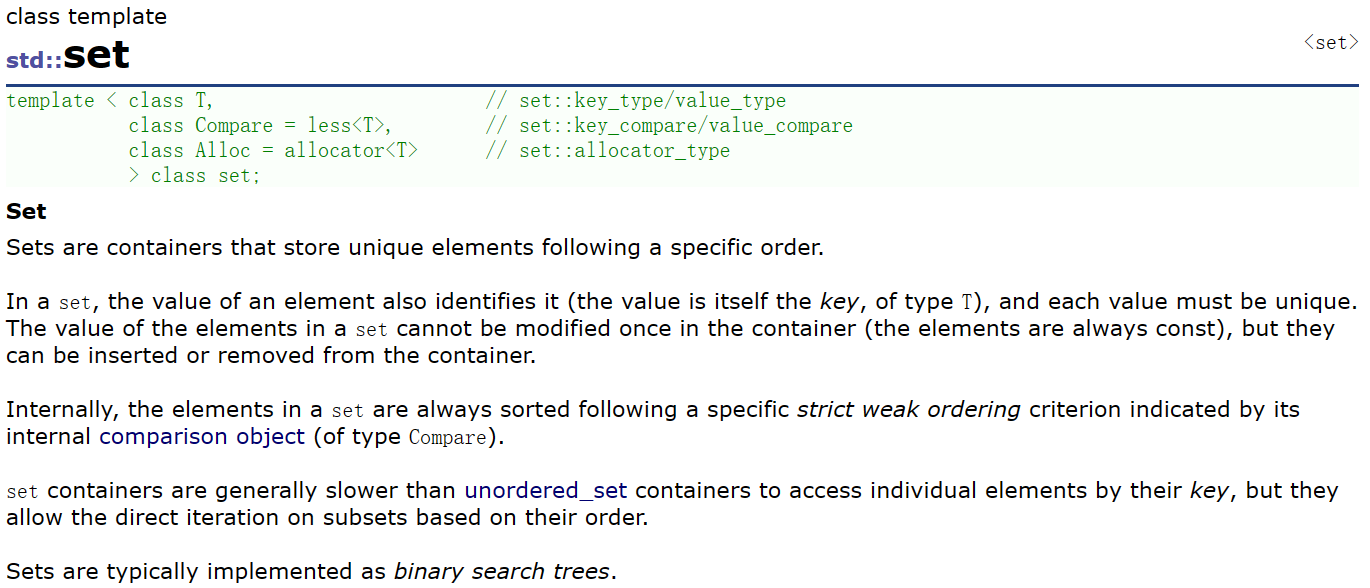 【翻译】
- set 是按照一定次序存储元素的容器。
- 在 set 中,元素的 value 也标识它(value 就是 key,类型为 T),并且每个 value 必须是唯一的。set 中的元素不能在容器中修改(元素总是 const),但是可以从容器中插入或删除它们。
- 在内部,set 中的元素总是按照其内部比较对象(类型比较)所指示的特定严格弱排序准则进行排序。
- set 容器通过 key 访问单个元素的速度通常比 unordered_set 容器慢,但它们允许根据顺序对子集进行直接迭代。
- set 在底层是用二叉搜索树(红黑树)实现的。
(2)set 的使用
a. set的模板参数列表
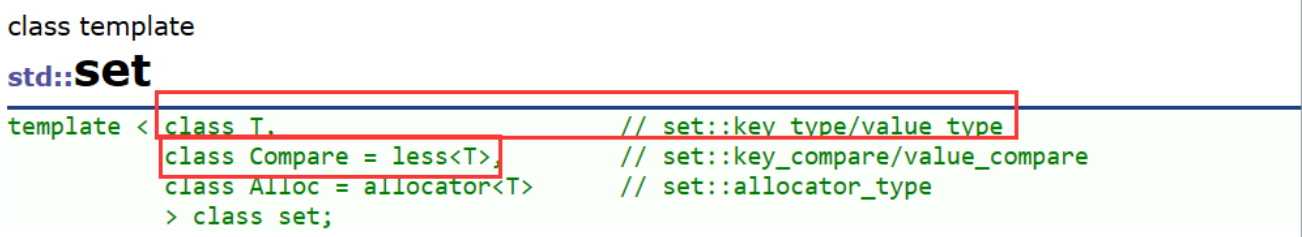 参数解释:1、T:set 中存放元素的类型,实际在底层存储2、Compare:set 中元素默认按照 小于 (< 升序)来比较。一般情况下(内置类型元素)该 参数不需要传递,如果无法比较时(比如自定义类型),需要用户自己显式传递比较规则(一般情况下按照函数指针或者仿函数来传递)
- 小于(< 升序),less。
- 大于(> 降序),定义 set 时模板参数中要写上 greater。
3、Alloc:set 中元素空间的管理方式,使用 STL 提供的空间配置器管理。- 使用 set 时,需要包含头文件 #include
。
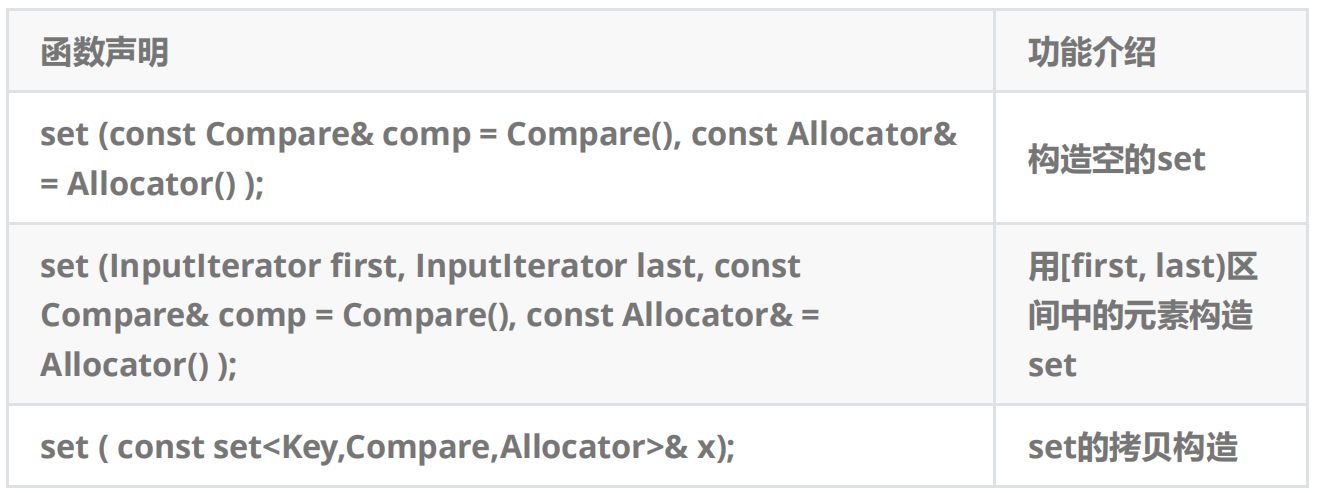
b. set的构造
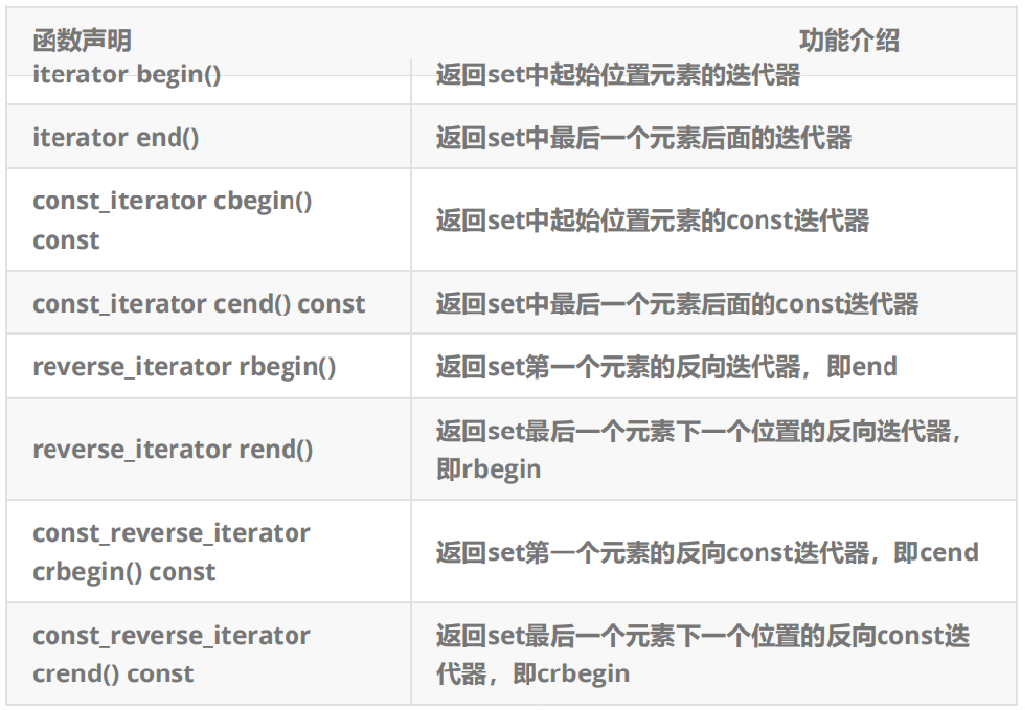
c. set 的迭代器
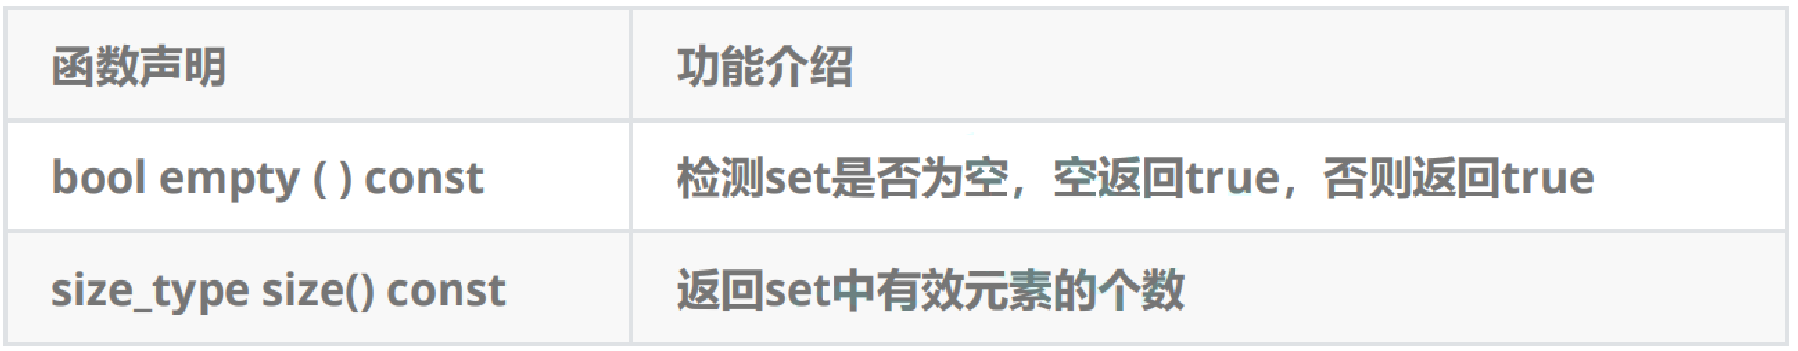
d. set 的容量
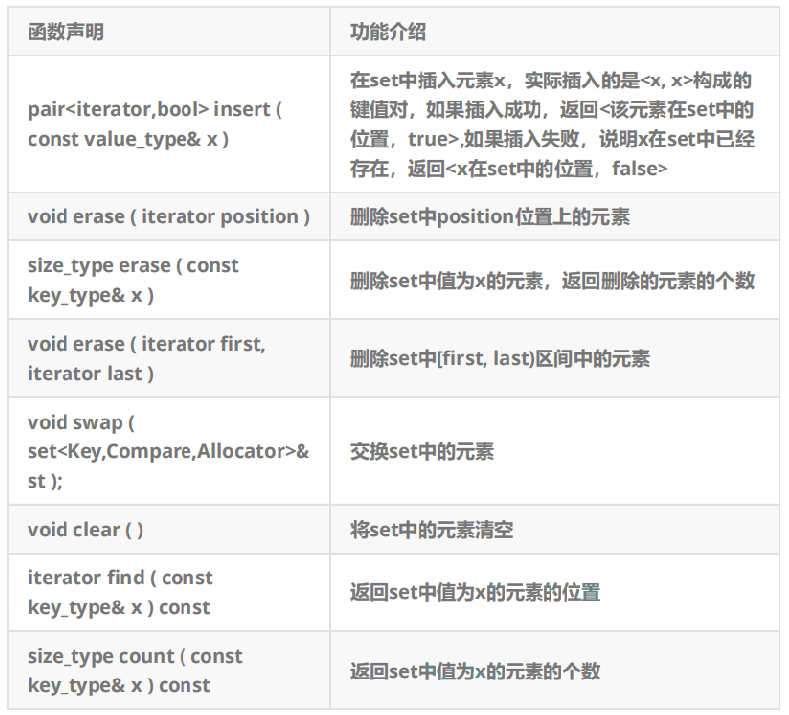
e. set 修改操作
f. set 的使用举例
- void test_set()
- {
- // 用数组array中的元素构造set
- int array[] = { 1, 3, 5, 7, 9, 2, 4, 3 };
- set<int> s(array, array+sizeof(array)/sizeof(array));
- cout << s.size() << endl;
- s.insert(4); // 4已经在set中了,不会插入
- cout << s.size() << endl; // 获取set元素个数
- // 正向打印set中的元素,从打印结果中可以看出:set可以去重
- for (auto& e : s)
- cout << e << " ";
- cout << endl;
- // 使用迭代器逆向打印set中的元素
- for (auto it = s.rbegin(); it != s.rend(); ++it)
- cout << *it << " ";
- cout << endl;
- // 两种查找元素方式:
- // 1、algorithm文件中的find函数,底层是暴力查找,全部节点遍历一遍,效率低,O(N)
- // auto ret = find(s.begin(), s.end(), 4);
- // 2、set的成员函数,O(logN)
- auto ret = s.find(4);
- // 这里需要判断一下,若找到,返回该元素的迭代器,若没有找到,返回s中最后一个元素后面的迭代器
- if (ret != s.end())
- {
- s.erase(ret); // 删除元素方式1,删除迭代器ret指向的元素
- }
- s.erase(5); // 删除元素方式2:删除值为5的元素
- // set中值为3的元素出现了几次 -- 1次(会去重)
- cout << s.count(3) << endl;
- }
注意:set 是不允许数据冗余的,使用 set 迭代器遍历 set 中的元素,可以得到一个有序序列,这样就达到了对一对数据排序+去重的效果。
(3)总结
- 与 map / multimap 不同,map / multimap 中存储的是真正的键值对
- set 中插入元素时,只需要插入 value 即可,不需要构造键值对。
- set 中的元素不可以重复(因此可以使用 set 进行去重)。
- 使用 set 的迭代器遍历 set 中的元素,可以得到有序序列。
- set 中的元素默认按照小于来比较。
- set 中查找某个元素,时间复杂度为:O(logn),set 中增删查改都是 O(logN)。
- set 中的元素不允许修改(为什么? 因为 set 内部实现是基于哈希表的,哈希表中的元素是根据元素的哈希值来进行存储和查找的。如果一个元素被修改了,那么它的哈希值也会发生变化,这样就会导致原来存储该元素的位置无法再次找到该元素,从而破坏了 set 的内部结构。)
- set 中的底层使用二叉搜索树(红黑树)来实现。
2、map(映射)
(1)map的介绍
map - C++ Reference (cplusplus.com)
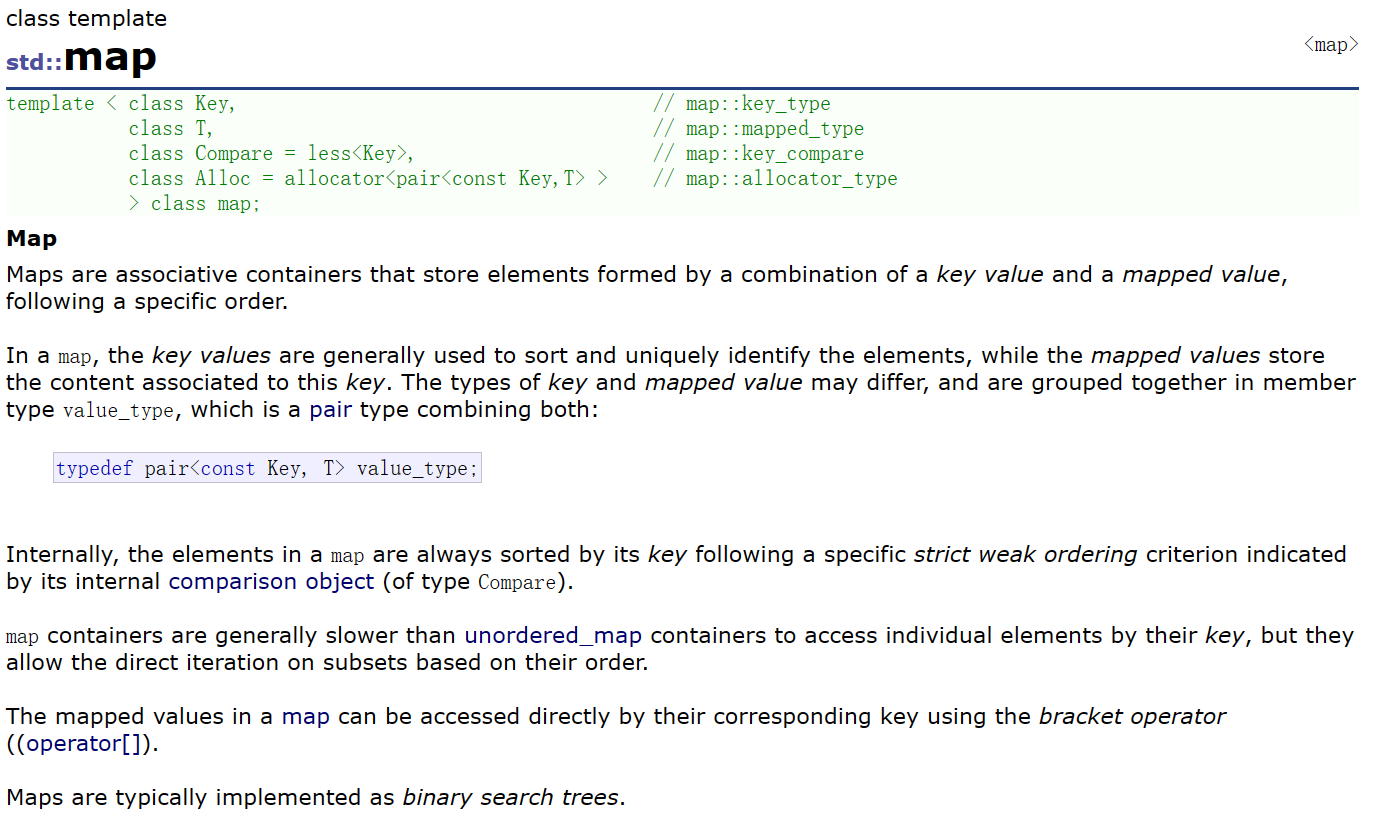 翻译:
- map 是关联容器,它按照特定的次序(按照 key 来比较)存储由键值 key 和值 value 组合而成的元素。
- 在 map 中,键值 key 通常用于排序和唯一地标识元素,而值 value 中存储与此键值 key 关联的内容。键值 key 和值 value 的类型可能不同,并且在 map 的内部,key 与 value 通过成员类型 value_type 绑定在一起,为其取别名称为 pair: typedef pair
value_type; - 在内部,map 中的元素总是按照键值 key 进行比较排序的。
- map 中通过键值访问单个元素的速度通常比 unordered_map 容器慢,但 map 允许根据顺序对元素进行直接迭代(即对 map 中的元素进行迭代时,可以得到一个有序的序列)。
- map 支持下标访问符,即在 [] 中放入 key,就可以找到与 key 对应的 value。
- map 通常被实现为二叉搜索树更准确的说:平衡二叉搜索树(红黑树)。
(2)map的使用
a. map的模板参数说明
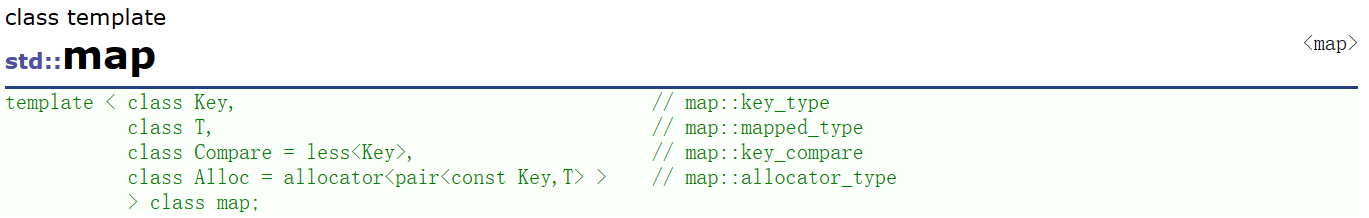 参数解释:1、key:键值对中 key 的类型。2、T:键值对中 value 的类型。3、Compare:比较器的类型,map 中的元素是按照 key 来比较的,缺省情况下按照 小于 (< 升序)来比较,一般情况下(内置类型元素)该参数不需要传递,如果无法比较时(自定义类型),需要用户自己显式传递比较规则(一般情况下按照函数指针或者仿函数来传递)。
- 小于(< 升序),less。
- 大于(> 降序),定义 map 时模板参数中要写上 greater。
4、Alloc:通过空间配置器来申请底层空间,不需要用户传递,除非用户不想使用标准库提供的空间配置器。- 在使用 map 时,需要包含头文件 #include 。
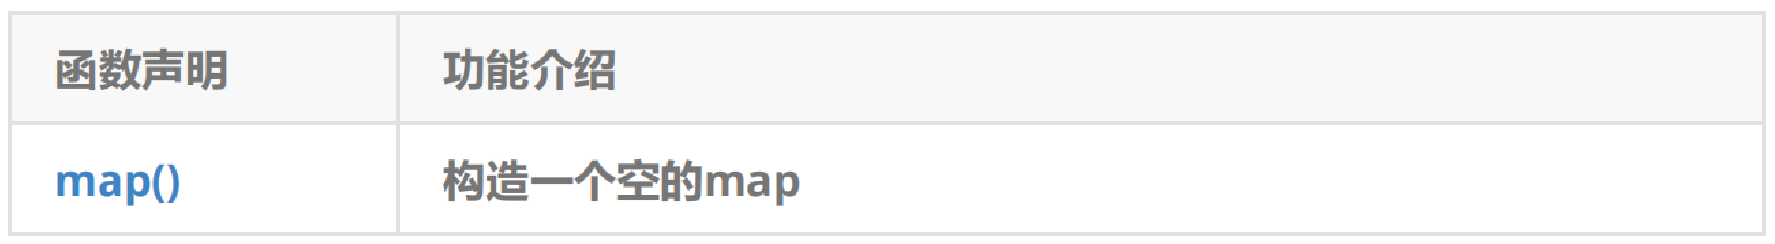
b. map的构造
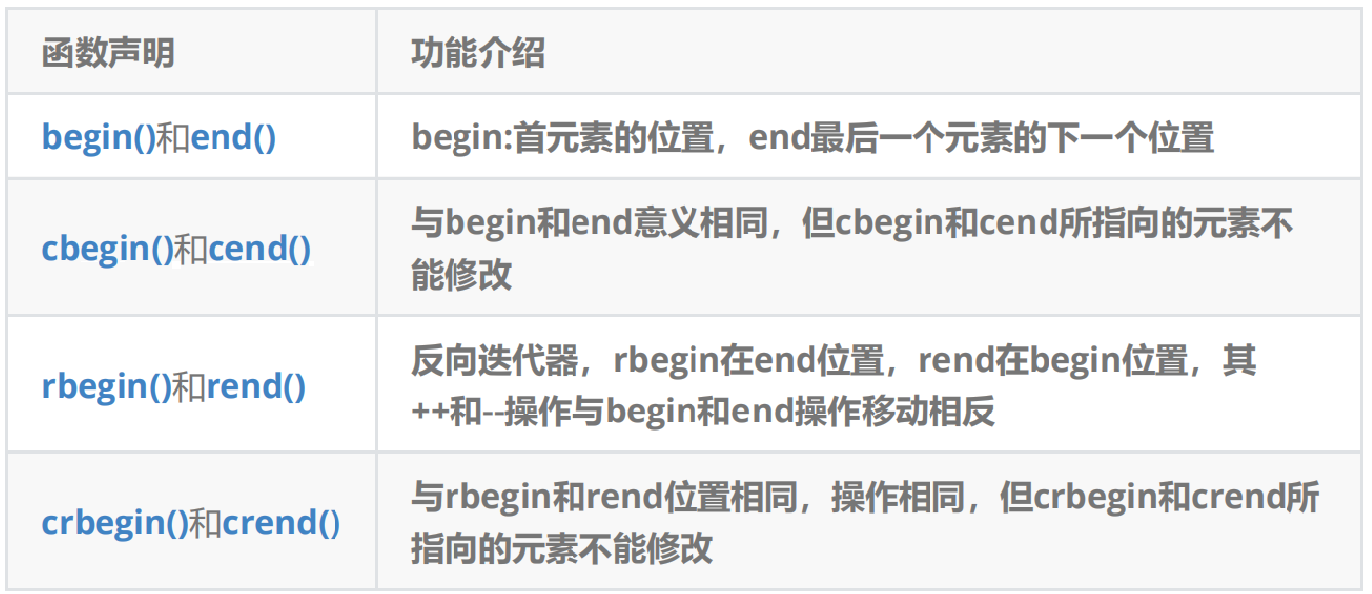
c. map的迭代器
d. map的容量与元素访问
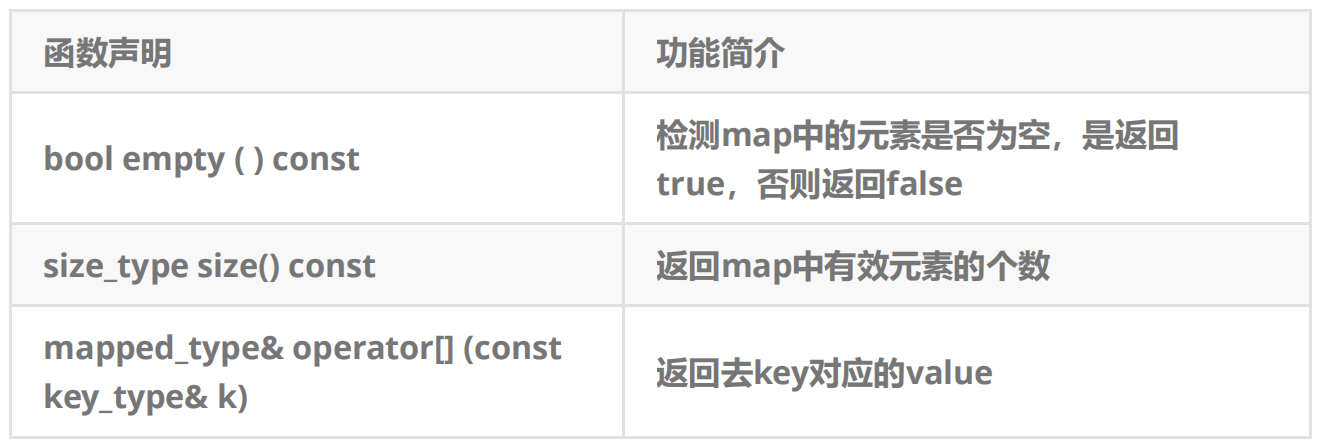
当 key 不在 map 中时,通过 operator 获取对应 value 时会发生什么问题?
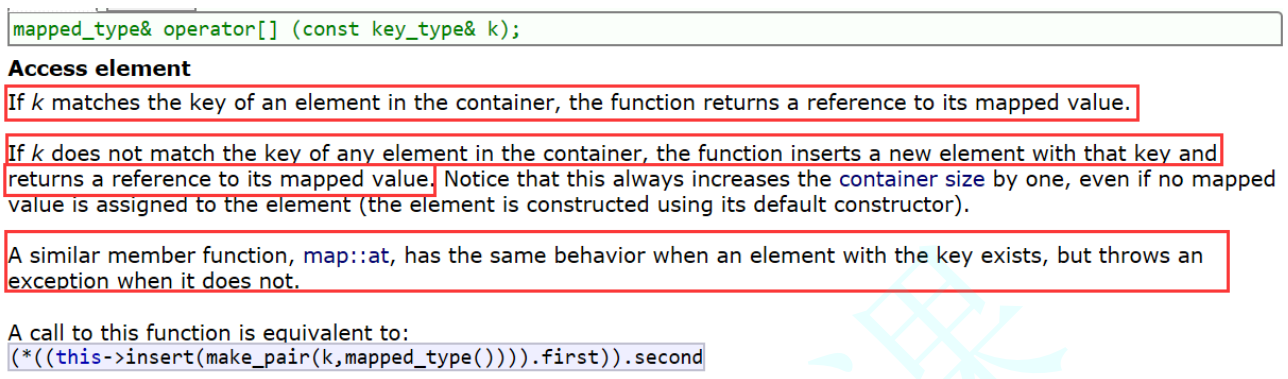 注意 :在元素访问时,有一个与 operator[] 类似的操作 at()(该函数不常用)函数,都是通过 key 找到与 key 对应的 value 然后返回其引用,不同的是:当 key 不存在时,operator[] 用默认 value 与 key 构造键值对然后插入,返回该默认 value,at() 函数直接抛异常。
e. map中元素的修改
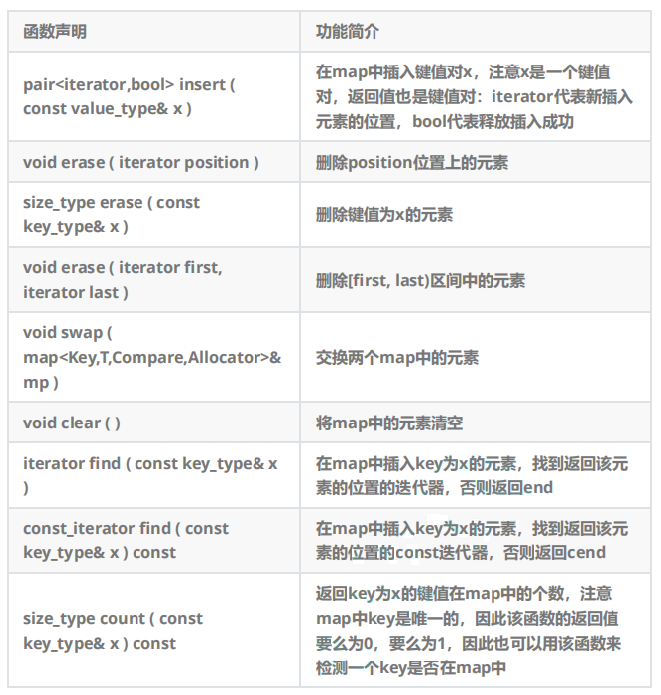
- #include
- #include
- void TestMap()
- {
- map
- // 向map中插入元素的方式:
- // 将键值对<"peach","桃子">插入map中,用pair直接来构造键值对
- m.insert(pair
- // 将键值对<"peach","桃子">插入map中,用make_pair函数来构造键值对
- m.insert(make_pair("banan", "香蕉"));
- // 借用operator[]向map中插入元素
- /*
- operator[]的原理是:
- 用
- 如果key已经存在,插入失败,insert函数返回该key所在位置的迭代器
- 如果key不存在,插入成功,insert函数返回新插入元素所在位置的迭代器
- operator[]函数最后将insert返回值键值对中的value返回
- */
- // 将<"apple", "">插入map中,插入成功,返回value的引用,将“苹果”赋值给该引用结果,
- m["apple"] = "苹果";
- // key不存在时抛异常
- //m.at("waterme") = "水蜜桃";
- cout << m.size() << endl;
- // 用迭代器去遍历map中的元素,可以得到一个按照key排序的序列
- for (auto& e : m)
- cout << e.first << "--->" << e.second << endl;
- cout << endl;
- // map中的键值对key一定是唯一的,如果key存在将插入失败
- auto ret = m.insert(make_pair("peach", "桃色"));
- if (ret.second)
- cout << "
- else
- cout << "键值为peach的元素已经存在:" << ret.first->first << "--->" << ret.first->second << "插入失败" << endl;
- // 删除key为"apple"的元素
- m.erase("apple");
- if (1 == m.count("apple"))
- cout << "apple还在" << endl;
- else
- cout << "apple被吃了" << endl;
- }
🔺operator[] 函数介绍
map::operator= - C++ Reference (cplusplus.com)
前面学习的 vector 容器里面的 vector::operator[] 是传入元素下标,返回对该元素的引用。
而 map 中的 operator[] 访问元素函数,和其它容器有挺大区别的,已经不是传统的数组下标访问了。
- operator[] 底层实际上调用的 insert() 函数。
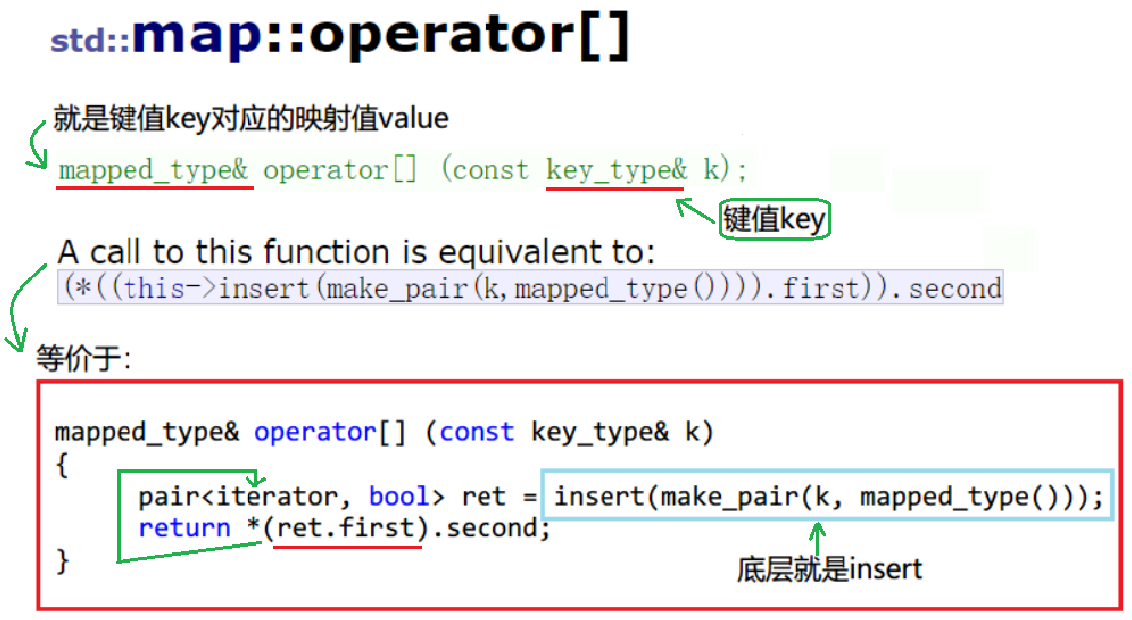
map容器中的 map::operator[] 是传入键值 key,通过该元素的 key 查找并判断是否在 map 中:
- 如果在 map 中,说明 insert 插入失败,insert 函数返回的 pair 对象会带出指向该元素的迭代器,通过这个迭代器,我们可以拿到该元素 key 对应的映射值 value,然后函数返回其对应映射值 value 的引用。
- 如果不在 map 中,说明 insert 插入成功,插入了这个新元素
注意:这里插入新元素时,该 value() 是一个缺省值,是调用 value 类型的默认构造函数构造的一个匿名对象。(比如是 string 类型就调用 string 的默认构造)
【operator[]总结】
使用 map::operator[] 函数,传入元素的键值 key:
- 如果 key 在map中,返回 key 对应映射值 value 的引用。
- 如果 key 不在map中,插入该元素 < key, value() >,返回 key 对应映射值 value 的引用。
- 拿到函数返回的映射值 value,我们可以对其修改。
这个函数非常的强大,即有查找功能,也有插入功能,还可以修改:
- map
- // 这里的意思是,先插入pair("tree", ""),再修改"tree"对应的value值为"树"
- dict["tree"] = "树";
- // 等价于:
- dict["tree"]; // 插入pair("string", "")
- dict["tree"] = "树"; // "tree"已存在,修改了"tree"对应的value值为"树"
【补充】
- 类似的成员函数 map::at 在元素存在时和 map::operator[] 具有相同的行为,区别在于,当元素不存在时 map::at 会抛出异常。
🔺insert 函数介绍
map::insert - C++ Reference (cplusplus.com)
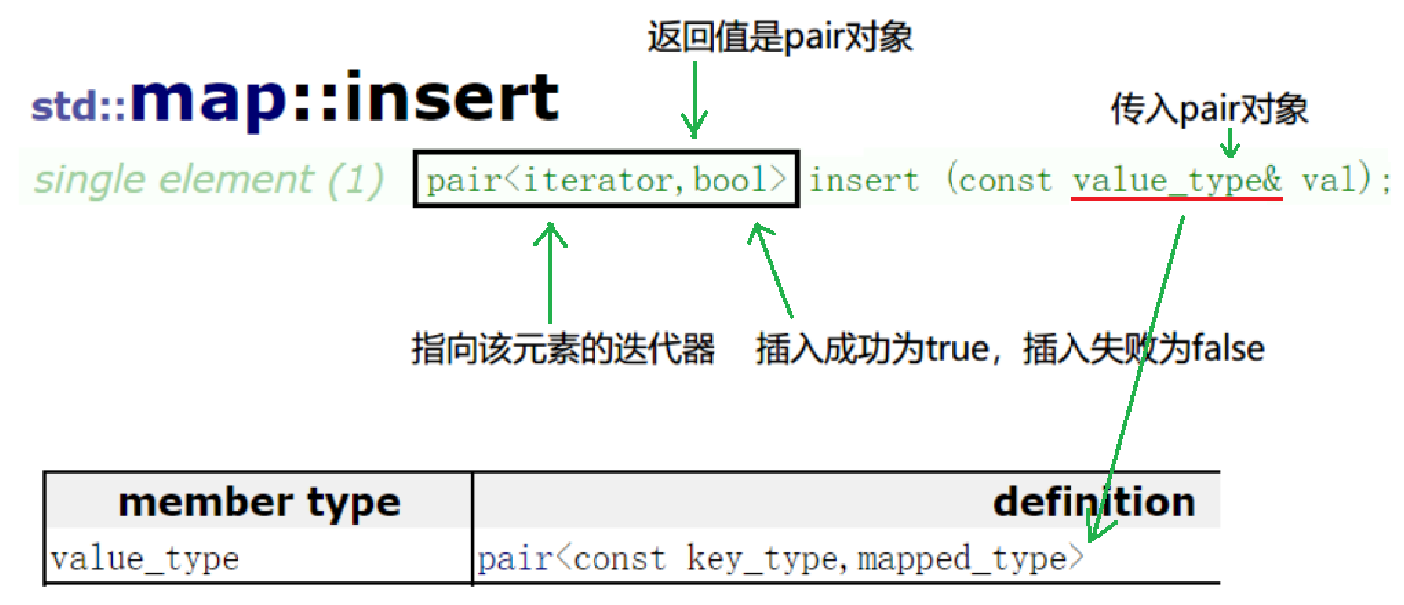
功能:向 map 中插入元素(pair 对象)时,先通过该元素的 key 查找并判断是否在 map 中:
- 如果在,返回一个 pair 对象:<指向该元素的迭代器, false>。
- 如果不在,插入该元素
-
【举例】实现一个字典 —— 可通过单词查找到对应的中文含义
定义 map,向 map 中插入元素(键值对),map 有两种插入元素方式:一般用第二种。
- // 定义map
- map
- // 向map中插入元素,2种方式:
- // 1、将键值对<"sort", "排序">插入map中,直接构造pair匿名对象(键值对)
- dict.insert(pair
- // 2、将键值对<"sort", "排序">插入map中,用make_pair函数来构造pair对象(键值对)
- dict.insert(make_pair("left", "左边"));
- dict.insert(make_pair("tree", "树"));
用迭代器遍历 map 元素:
需要注意的是,遍历 map 中元素的方式和其它迭代器有些不同,下面这种是错误示范:
这里的 it 是指向当前元素的迭代器,解引用 *it 是一个 pair 对象(键值对),而 map 中没有流插入运算符的重载,所以不能这样输出。
- // 错误示范❌
- map
- while (it != dict.end())
- {
- // cout << *it << endl; // error!
- it++;
- }
这里调用的是 it.operator*() 解引用运算符重载函数,所以 *it 只是得到了当前节点中存储 pair
迭代器遍历map元素的两种方式:
- // 迭代器遍历map
- map
- while (it != dict.end())
- {
- /* 1、迭代器是像指针一样的类型
- * 对当前元素的迭代器it解引用(*it)可以得到当前节点中存储的数据:即pair对象(键值对),然后用'.'再去访问pair对象中的kv值
- * 这里调用的是it.operator*() 解引用运算符重载函数,返回值为:pair对象的引用
- */
- cout << (*it).first << ", " << (*it).second << endl;
- /* 2、迭代器箭头->,返回当前迭代器指向j的地址(指针):pair
- * 该指针再使用'->'就可以取到(pair对象)里面的kv值,即first和second
- * 代码为:it->->first,但可读性太差,编译器进行了特殊处理,省略掉了一个箭头,保持了程序的可读性
- */
- // 一般结构体的指针才会使用'->'来访问成员,所以当迭代器管理的节点中的数据是结构体的时候,就可以用'->'
- cout << it->first << ", " << it->second << endl; // 常用这种写法
- it++;
- }
-
【举例】统计单词出现的次数
第一种解法,定义 map,遍历 str,向 map 中插入元素(键值对):
- string str[] = { "sort","sort", "tree","sort", "node", "tree","sort", "sort", };
- // 定义map
- map
- // 遍历str
- for (auto& e : str) // 传引用,避免string深拷贝
- {
- // 先查找判断当前单词是否已经在Map中了
- auto ret = Map.find(e);
- if (ret == Map.end()) // 如果不在Map中,返回Map中最后一个元素后面的迭代器
- {
- Map.insert(make_pair(e, 1)); // 插入pair对象(键值对),即<单词,单词出现次数>
- }
- else // 如果在Map中,返回该元素的迭代器
- {
- ret->second++; // 单词出现的次数+1
- }
- }
- // 遍历map,这里的e是map的元素(即pair对象),打印<单词,单词出现次数>
- for (auto& e : Map)
- {
- cout << e.first << ", " << e.second << endl;
- }
上述解法,先查找当前单词是否在 map 中,如果不在,则插入,但是在插入函数内又会查找一次,找到插入的位置,有点冗余。
第二种解法,插入元素时,insert 本来就有查找功能:
- void test_map()
- {
- string str[] = { "sort", "sort", "tree", "sort", "node", "tree", "sort", "sort", };
- // 定义map
- map
- // 遍历str
- for (auto& e : str)
- {
- // 插入元素
- auto ret = count_map.insert(make_pair(e, 1));
- // insert返回值类型是:pair
- // 插入失败,说明该元素已存在于map中,函数返回一个pair对象
- // 即:pair<指向该元素的迭代器, false>
- if (ret.second == false)
- {
- (ret.first)->second++; // 对当前元素的value值加1
- }
- }
- // 遍历map,这里的e是map的元素(即pair对象)
- for (auto& e : count_map)
- {
- cout << e.first << ", " << e.second << endl;
- }
- }
第三种解法:
使用 map::operator[] 函数根据当前元素的键值 key 查找,判断该元素是否在 map 中,如果在,返回其映射值 value 的引用,如果不在,当成新元素插入,并返回其映射值 value 的引用。
- 若元素 e 存在,返回其对应映射值 value,并加 1。
- 若元素 e 不存在,则插入,返回其对应映射值 value,并加 1。
- string str[] = { "sort", "sort", "tree", "sort", "node", "tree", "sort", "sort", };
- // 定义map
- map
- // 使用operator[]函数
- for (auto& e : str)
- {
- Map[e]++;
- }
- // 遍历map,打印< 单词,单词出现次数 >
- for (auto& e : Map)
- {
- cout << e.first << ", " << e.second << endl;
- }
【总结】
- map 中的的元素是键值对(pair 结构体)。
- map 中的 key 是唯一的,并且不能修改,只能修改 key 对应的映射值 value。
- 默认按照小于的方式对 key 进行比较。
- map 中的元素如果用迭代器去遍历,可以得到一个有序的序列。
- map 的底层为平衡搜索树(红黑树),查找效率比较高,时间复杂度为 O(logN)。
- 支持 [] 操作符,operator[] 中实际进行插入查找,即在 [] 中放入 key,就可以找到与 key 对应的 value。
3、multiset
(1)multiset的介绍
multiset - C++ Reference (cplusplus.com)
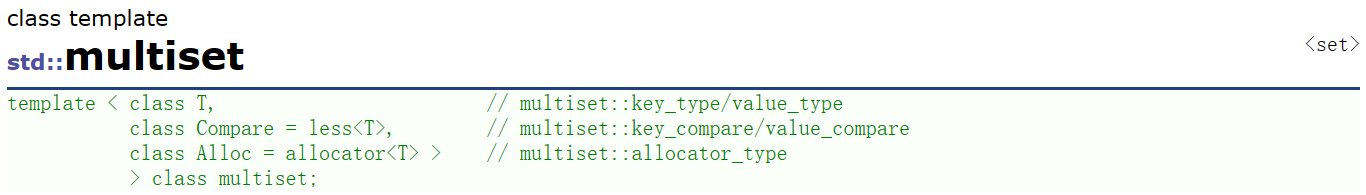 【翻译】
- multiset 是按照特定顺序存储元素的容器,其中元素是可以重复的。
- multiset 中,元素的 value 也会识别它(因为 multiset 中本身存储的就是
- 在内部,multiset 中的元素总是按照其内部比较规则(类型比较)所指示的特定严格弱排序准则进行排序。
- multiset 容器通过 key 访问单个元素的速度通常比 unordered_multiset 容器慢,但当使用迭代器遍历时会得到一个有序序列。
- multiset 底层结构为二叉搜索树(红黑树)。
【注意】- multiset 中在底层中存储的是
- mtltiset 的插入接口中只需要插入即可。
- 与 set 的区别是,multiset 中的元素可以重复,set 中的 value 是唯一的。
- 使用迭代器对 multiset 中的元素进行遍历,可以得到有序的序列。
-
multiset 中的元素不能修改。
-
在 multiset 中找某个元素,时间复杂度为 O(logN)。
-
multiset 的作用:可以对元素进行排序。
(2)multiset的使用
这里只简单演示 set 与 multiset 的不同,其他接口接口与 set 相同,可以参考 set。
- #include
- void TestSet()
- {
- int array[] = { 4, 1, 3, 9, 6, 4, 5, 8, 4, 4 };
- // 注意:multiset在底层实际存储的是
- multiset<int> s(array, array + sizeof(array)/sizeof(array[0]));
- for (auto& e : s)
- cout << e << " ";
- cout << endl;
- // 1 3 4 4 4 4 5 6 8 9
- cout << s.count(4) << endl; // 运行结果:3
- cout << s.count(3) << endl; // 运行结果:1
- return 0;
- }
4、multimap
(1)multimap的介绍
multimap - C++ Reference (cplusplus.com)
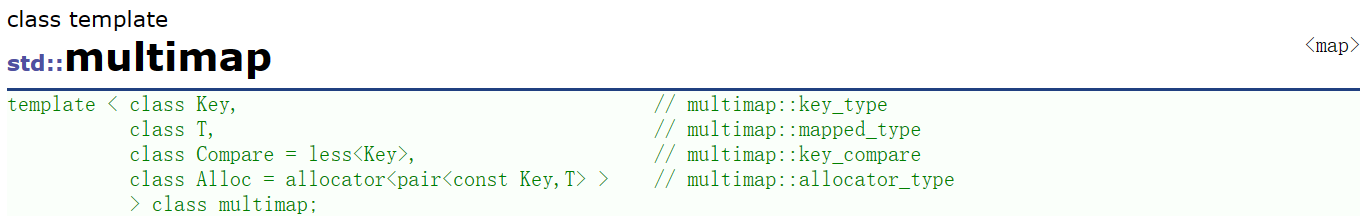
【翻译】
- Multimaps 是关联式容器,它按照特定的顺序,存储由 key 和 value 映射成的键值对
- 在 multimap 中,通常按照 key 排序和唯一地标识元素,而映射的 value 存储与 key 关联的内容。key 和 value 的类型可能不同,通过 multimap 内部的成员类型 value_type 组合在一起,value_type 是组合 key 和 value 的键值对:typedef pair
value_type; - 在内部,multimap 中的元素总是通过其内部比较对象,按照指定的特定严格弱排序标准对 key 进行排序的。
- multimap 通过 key 访问单个元素的速度通常比 unordered_multimap 容器慢,但是使用迭代器直接遍历 multimap 中的元素可以得到关于 key 有序的序列。
- multimap 在底层用二叉搜索树(红黑树)来实现。
【注意】- multimap 和 map 的唯一不同就是:map 中的 key 是唯一的,而 multimap 中的 key 是可以重复的。
(2)multimap的使用
- multimap 中的接口可以参考 map,功能都是类似的。
注意 :- multimap 中的 key 是可以重复的。
- multimap 中的元素默认将 key 按照小于来比较。
- multimap 中没有重载 operator[] 操作(为什么?因为 multimap 中的元素是按照键值有序存储的,而 operator[] 操作需要通过键值来访问元素,这样会破坏 multimap 中元素的有序性。因此,multimap 只提供了通过迭代器来访问元素的方式,如 find()、lower_bound()、upper_bound() 等函数)。
- 使用时与 map 包含的头文件相同。
-
相关阅读:
一种高效的同态加密方案及其应用-解读
Docker笔记-07 Dockerfile
卡方检验--离散变量相关性分析--机器学习特征选择
Nwafu-OJ-1503 Problem 6 2019阶段1考试 题目5
信息系统漏洞与风险管理制度
IceRPC之使用Dev Containers进行 .NET QUIC 精简开发
基于Java的校园“研帮”系统的设计与实现毕业设计源码201433
单片机——通过对P3口地址的操作流水点亮8位LED
AIE荧光分子杂化介孔二氧化硅杂化纳米微球/聚合诱导微米级多孔SiO2微球
智能汽车-大数据标签系统应用浅谈
- 原文地址:https://blog.csdn.net/weixin_74531333/article/details/133861088

- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读