-
Python 序列化与反序列化(pickle 标准库的使用)
目录
1.什么是序列化与反序列化?
1.1 序列化与反序列化的定义
在计算机网络通信中,不同机器间的通讯需要采用约定的协议,而序列化和反序列化就是属于通讯协议的一部分。通讯协议往往采用分层模型,不同模型每层的功能定义以及颗粒度不同,例如:TCP/IP协议是一个四层协议,而OSI模型却是七层协议模型。在OSI七层协议模型中展现层(Presentation Layer)的主要功能是把应用层的对象转换成一段连续的二进制串,或者反过来,把二进制串转换成应用层的对象--这两个功能就是序列化和反序列化。
-
序列化: 将数据结构或对象转换成二进制串的过程
-
反序列化:将在序列化过程中所生成的二进制串转换成数据结构或者对象的过程
1.2 序列化与反序列化的应用场景
存储:我们在运行python程序的过程中,运行时的列表、字典等数据结构往往都是随着程序的运行开始而产生,随着程序的运行结束而消失,那么如何将这些Python对象保存下来呢?这时候序列化就派上了用场。
传输:当两个进程在进行远程通信时,彼此可以发送各种类型的数据。无论是何种类型的数据,都会以二进制序列的形式在网络上传送。发送方需要把这个对象转换为字节序列,在能在网络上传输;接收方则需要把字节序列在恢复为对象。
在Python中,模块pickle实现了对一个 Python 对象结构的二进制序列化和反序列化。
2.pickle标准库介绍
pickle是python语言的一个标准模块,安装python后已包含pickle库,不需要单独再安装。通过模块的序列化操作我们能够将程序中运行的对象信息保存到文件中去,永久存储;通过模块的反序列化操作,我们能够从文件中还原保存的对象。值得注意的是,pickle模块是以二进制的形式序列化后保存到文件中(后缀.kpl),我们打开该文件看到的是一堆乱码,而python的另一个序列化标准模块JSON文件打开之后是肉眼可读的。
2.1 pickle序列化操作
pickle.dump(obj,file)
参数obj:将要序列化的python对象
参数file:将对象 obj 封存以后的对象写入已打开的file文件
下面我们通过一个实例来看看如何使用dump()函数:
- import pickle
- dic={
- "name":"张三",
- "age":12
- }
- #注意open函数mode选择以二进制写入文件,比如'wb+',
- f = open("E:\VsCodeWorkSpace\PythonProjects\pickle_File.pkl",'wb+')
- pickle.dump(dic,f)
- f.close()
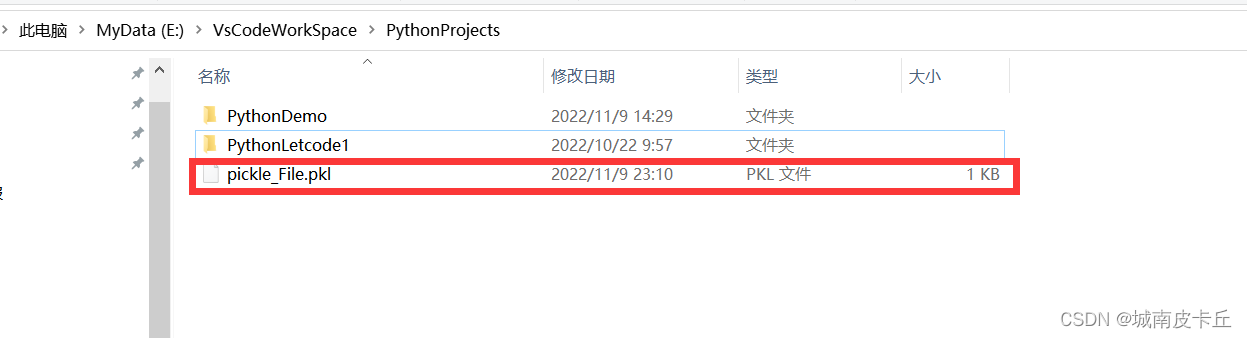
上述代码中,我们创建了一个字典,然后打开了一个file文件对象,我们通过调用dump()函数将字典永久保存在pickle_File.pkl文件中。
Pickler(file).dump(obj)
参数obj:将要序列化的python对象
参数file:将对象 obj 封存以后的对象写入已打开的file文件
下面我们再来通过一个实例看看如何使用这个函数
- from pickle import Pickler
- #注意open函数mode选择以二进制写入文件,比如'wb+'
- f=open("E:\VsCodeWorkSpace\PythonProjects\Pickler_file", 'wb+')
- list=["admin","123458"]
- Pickler(f).dump(list);
- f.close()
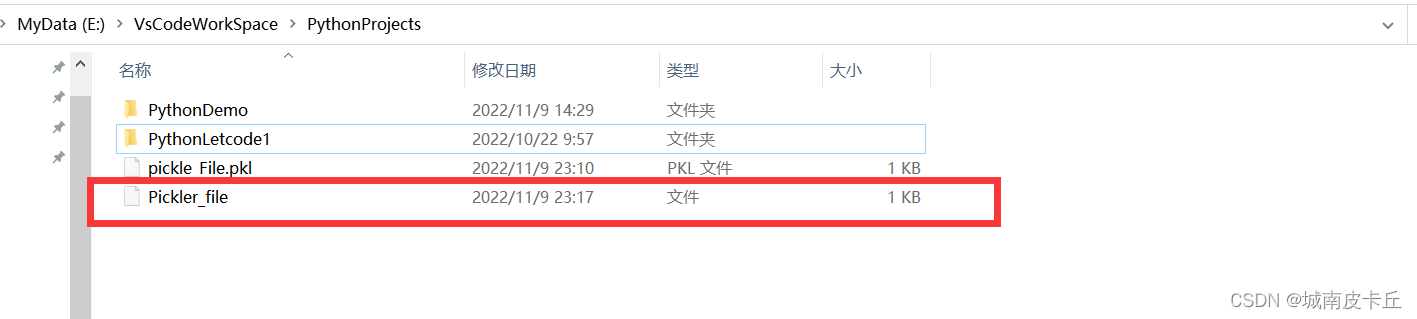
上述代码中,我们创建了一个列表,然后打开了一个file文件对象,我们通过调用pickle模块中的Pickler类中的dump()函数将该列表永久保存在Pickler_file文件中。
2.2 pickle反序列化操作
pickle.load(file)
#该方法实现的是将序列化的对象从文件file中读取出来
参数file:序列化的file文件
刚才我们通过调用pickle模块中的Pickler类中的dump()函数将列表
list=["admin","123458"]永久保存在Pickler_file文件中,我们现在通过调用模块中的load()方法将它还原
- import pickle
- #注意open函数mode选择以二进制读取文件,比如'rb'
- f1 = open("E:\VsCodeWorkSpace\PythonProjects\Pickler_file", 'rb')
- di=pickle.load(f1)
- print(di)
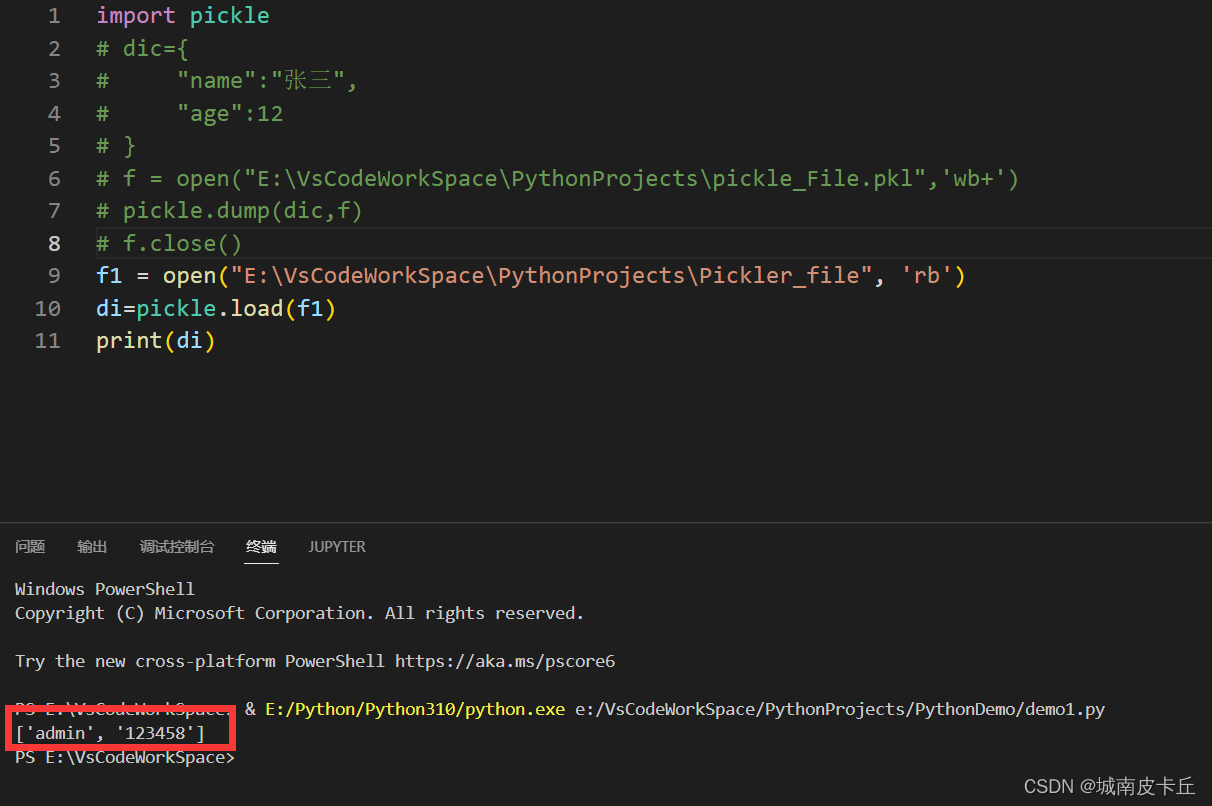
有一点需要注意,无论是序列化操作还是反序列化操作,参数file必须是以二进制的形式进行操作(读取)
Unpickler(file).load()
参数file:序列化的file文件
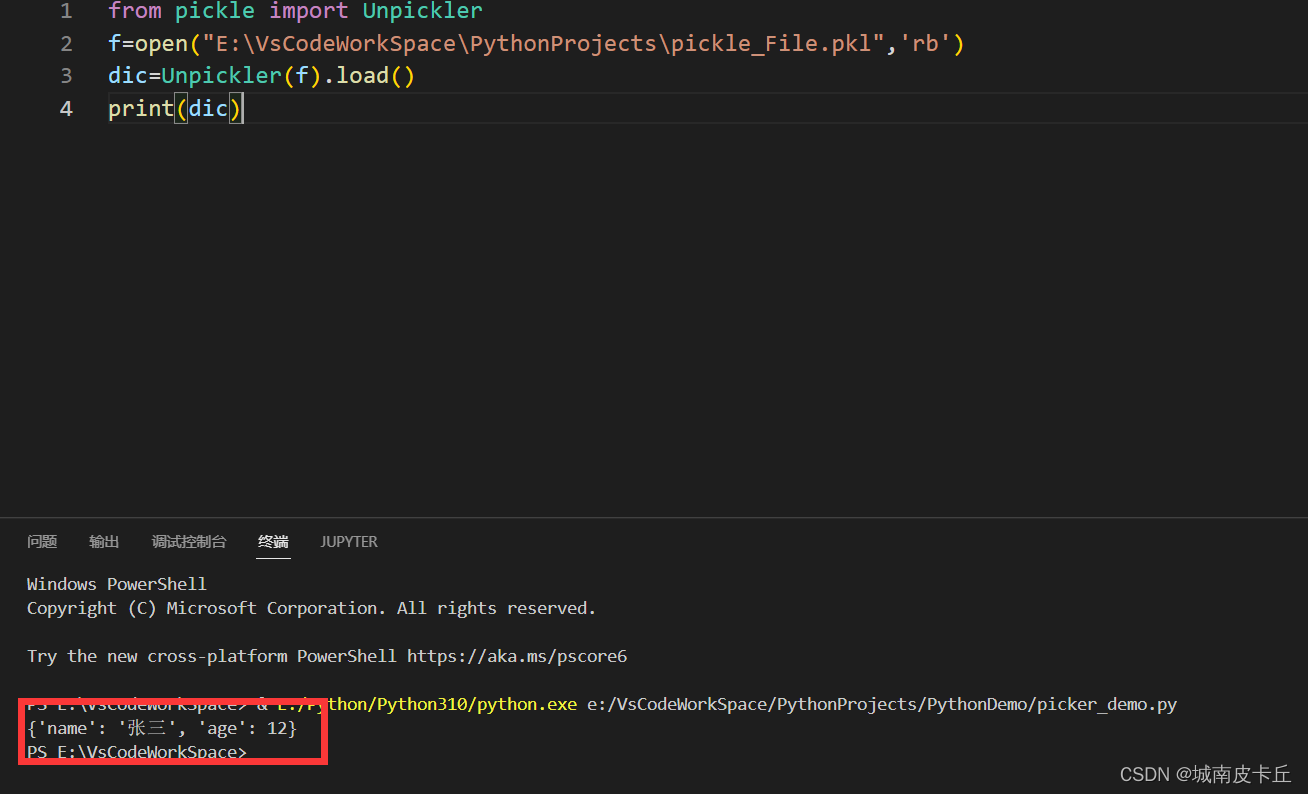
之前我们创建了一个字典,然后打开了一个file文件对象,我们通过调用dump()函数将字典永久保存在pickle_File.pkl文件中。现在用该反序列化方法将该对象还原。
- from pickle import Unpickler
- f=open("E:\VsCodeWorkSpace\PythonProjects\pickle_File.pkl",'rb')
- dic=Unpickler(f).load()
- print(dic)
值得注意的是pickle模块中还有一些其他的函数来帮助我们实现序列化与反序列化操作,我刚才介绍的dump()、load()函数还有其它可选参数来拓展函数的功能,这些官方文档中都做了非常详细的讲解。
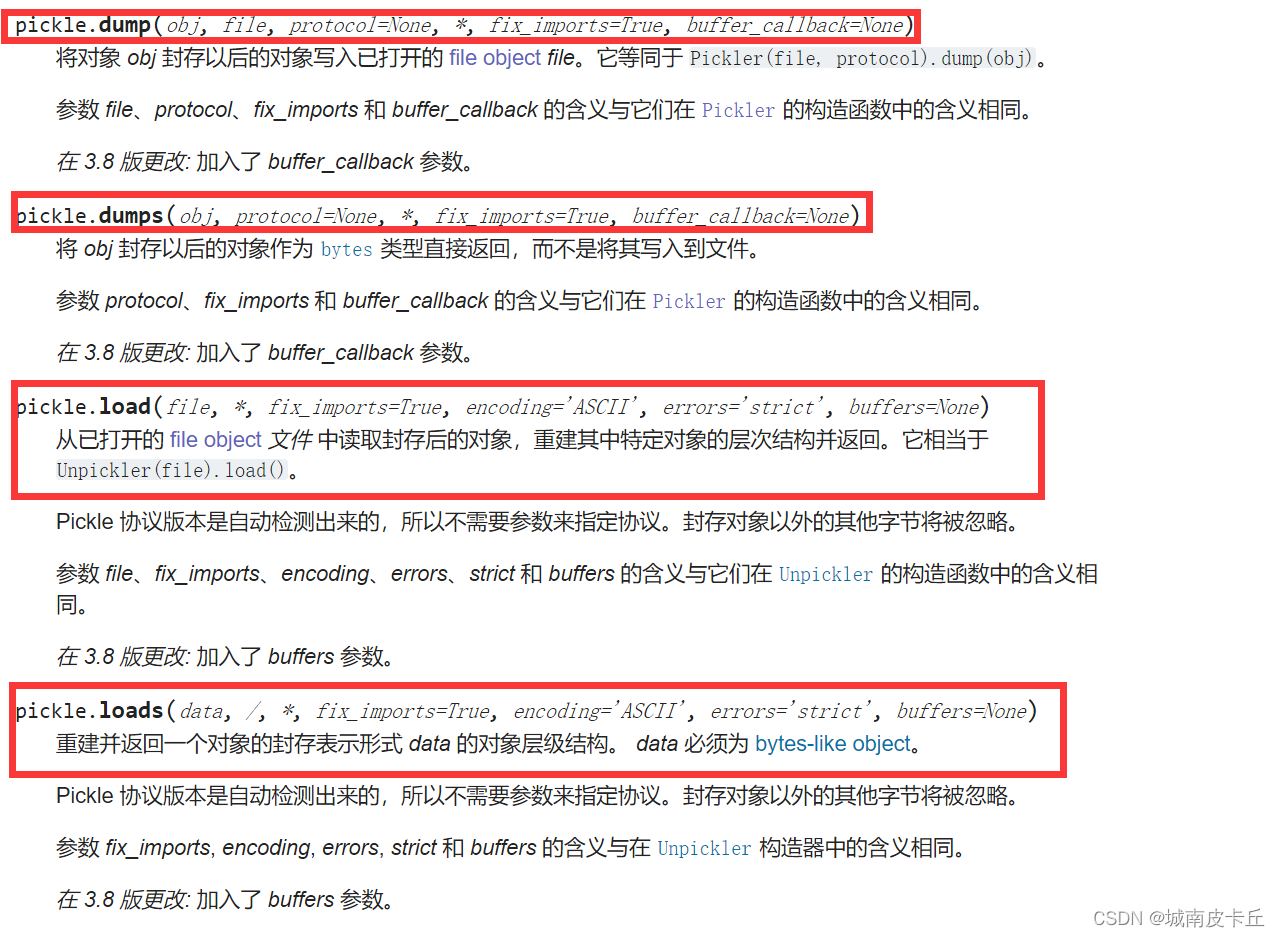
更多函数用法,请参见python官方文档pickle模块
-
-
相关阅读:
Python曲线拟合(polyfit , curve_fit, interp1d插值)
面试题-7
高等数学(第七版)同济大学 习题8-1 个人解答
Cppcheck 详细介绍
IOC理解
接口测试需要验证数据库么?
Typora最强替代神器Marktext
第一课 HelloPython
【开源教程2】疯壳·开源编队无人机-硬件资源简介
【Linux】提权问题
- 原文地址:https://blog.csdn.net/qq_42681787/article/details/127770055
- 最新文章
-
【FHE】我们如何实现同态加密推理(八):SiLU 的密文化——两条路径,和一个 8 字节的开关
SQLcl 中 c/old/new 替换变量为何失效?先定位再替换
不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
Halo插件:支持GitHub的图床附件策略
电视投屏界的“一股清流”!SimpleTVCast 6.0.0-beta 抢先体验:无需TV端App,界面大换血!✨
华三VXLAN集中式网关实战指南:Spine多活网关 + 双活接入(M-LAG)
软件更好写之后口碑会更重要
大 O、大 Omega、大 Theta 的区别,O(n) 复杂度是什么意思
Java标签跳转:一个鲜为人知但却很实用的小技巧
多智能体系统论文速读