-
还不懂Java线程池实现原理,看这一篇文章就够了
1. 为什么要使用线程池
使用线程池通常由以下两个原因:
-
频繁创建销毁线程需要消耗系统资源,使用线程池可以复用线程。
-
使用线程池可以更容易管理线程,线程池可以动态管理线程个数、具有阻塞队列、定时周期执行任务、环境隔离等。
2. 线程池的使用
- /**
- * @author 一灯架构
- * @apiNote 线程池示例
- **/
- public class ThreadPoolDemo {
- public static void main(String[] args) {
- // 1. 创建线程池
- ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor(
- 3,
- 3,
- 0L,
- TimeUnit.MILLISECONDS,
- new LinkedBlockingQueue<>(),
- Executors.defaultThreadFactory(),
- new ThreadPoolExecutor.AbortPolicy());
- // 2. 往线程池中提交3个任务
- for (int i = 0; i < 3; i++) {
- threadPoolExecutor.execute(() -> {
- System.out.println(Thread.currentThread().getName() + " 关注公众号:一灯架构");
- });
- }
- // 3. 关闭线程池
- threadPoolExecutor.shutdown();
- }
- }
- 复制代码
输出结果:
- pool-1-thread-2 关注公众号:一灯架构
- pool-1-thread-1 关注公众号:一灯架构
- pool-1-thread-3 关注公众号:一灯架构
- 复制代码
线程池的使用非常简单:
- 调用new ThreadPoolExecutor()构造方法,指定核心参数,创建线程池。
- 调用execute()方法提交Runnable任务
- 使用结束后,调用shutdown()方法,关闭线程池。
再看一下线程池构造方法中核心参数的作用。
3. 线程池核心参数
线程池共有七大核心参数:
参数名称 参数含义 int corePoolSize 核心线程数 int maximumPoolSize 最大线程数 long keepAliveTime 线程存活时间 TimeUnit unit 时间单位 BlockingQueue workQueue 阻塞队列 ThreadFactory threadFactory 线程创建工厂 RejectedExecutionHandler handler 拒绝策略 -
corePoolSize 核心线程数
当往线程池中提交任务,会创建线程去处理任务,直到线程数达到corePoolSize,才会往阻塞队列中添加任务。默认情况下,空闲的核心线程并不会被回收,除非配置了allowCoreThreadTimeOut=true。
-
maximumPoolSize 最大线程数
当线程池中的线程数达到corePoolSize,阻塞队列又满了之后,才会继续创建线程,直到达到maximumPoolSize,另外空闲的非核心线程会被回收。
-
keepAliveTime 线程存活时间
非核心线程的空闲时间达到了keepAliveTime,将会被回收。
-
TimeUnit 时间单位
线程存活时间的单位,默认是TimeUnit.MILLISECONDS(毫秒),可选择的有:
TimeUnit.NANOSECONDS(纳秒) TimeUnit.MICROSECONDS(微秒) TimeUnit.MILLISECONDS(毫秒) TimeUnit.SECONDS(秒) TimeUnit.MINUTES(分钟) TimeUnit.HOURS(小时) TimeUnit.DAYS(天)
-
workQueue 阻塞队列
当线程池中的线程数达到corePoolSize,再提交的任务就会放到阻塞队列的等待,默认使用的是LinkedBlockingQueue,可选择的有:
LinkedBlockingQueue(基于链表实现的阻塞队列)
ArrayBlockingQueue(基于数组实现的阻塞队列)
SynchronousQueue(只有一个元素的阻塞队列)
PriorityBlockingQueue(实现了优先级的阻塞队列)
DelayQueue(实现了延迟功能的阻塞队列)
-
threadFactory 线程创建工厂
用来创建线程的工厂,默认的是Executors.defaultThreadFactory(),可选择的还有Executors.privilegedThreadFactory()实现了线程优先级。当然也可以自定义线程创建工厂,创建线程的时候最好指定线程名称,便于排查问题。
-
RejectedExecutionHandler 拒绝策略
当线程池中的线程数达到maximumPoolSize,阻塞队列也满了之后,再往线程池中提交任务,就会触发执行拒绝策略,默认的是AbortPolicy(直接终止,抛出异常),可选择的有:
AbortPolicy(直接终止,抛出异常)
DiscardPolicy(默默丢弃,不抛出异常)
DiscardOldestPolicy(丢弃队列中最旧的任务,执行当前任务)
CallerRunsPolicy(返回给调用者执行)
4. 线程池工作原理
线程池的工作原理,简单理解如下:
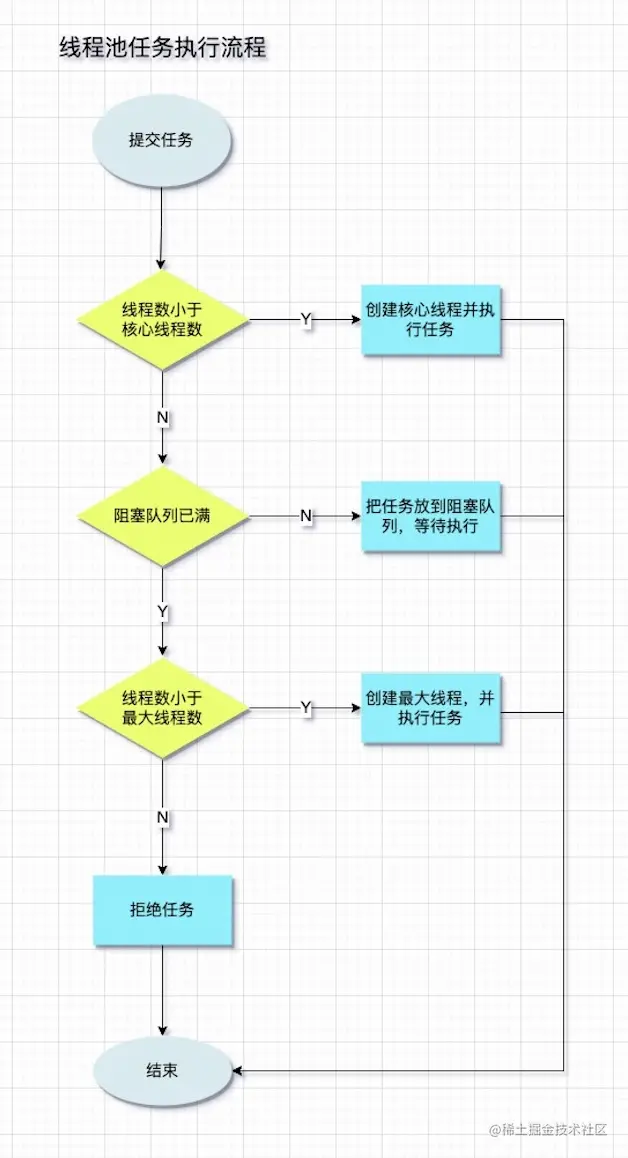
- 当往线程池中提交任务的时候,会先判断线程池中线程数是否核心线程数,如果小于,会创建核心线程并执行任务。
- 如果线程数大于核心线程数,会判断阻塞队列是否已满,如果没有满,会把任务添加到阻塞队列中等待调度执行。
- 如果阻塞队列已满,会判断线程数是否小于最大线程数,如果小于,会继续创建最大线程数并执行任务。
- 如果线程数大于最大线程数,会执行拒绝策略,然后结束。
5. 线程池源码剖析
5.1 线程池的属性
- public class ThreadPoolExecutor extends AbstractExecutorService {
- // 线程池的控制状态,Integer长度是32位,前3位用来存储线程池状态,后29位用来存储线程数量
- private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0));
- // 线程个数所占的位数
- private static final int COUNT_BITS = Integer.SIZE - 3;
- // 线程池的最大容量,2^29-1,约5亿个线程
- private static final int CAPACITY = (1 << COUNT_BITS) - 1;
- // 独占锁,用来控制多线程下的并发操作
- private final ReentrantLock mainLock = new ReentrantLock();
- // 工作线程的集合
- private final HashSet<Worker> workers = new HashSet<>();
- // 等待条件,用来响应中断
- private final Condition termination = mainLock.newCondition();
- // 是否允许回收核心线程
- private volatile boolean allowCoreThreadTimeOut;
- // 线程数的历史峰值
- private int largestPoolSize;
- /**
- * 以下是线程池的七大核心参数
- */
- private volatile int corePoolSize;
- private volatile int maximumPoolSize;
- private volatile long keepAliveTime;
- private final BlockingQueue<Runnable> workQueue;
- private volatile ThreadFactory threadFactory;
- private volatile RejectedExecutionHandler handler;
- }
- 复制代码
线程池的控制状态ctl用来存储线程池状态和线程个数,前3位用来存储线程池状态,后29位用来存储线程数量。
设计者多聪明,用一个变量存储了两块内容。
5.2 线程池状态
线程池共有5种状态:
状态名称 状态含义 状态作用 RUNNING 运行中 线程池创建后默认状态,接收新任务,并处理阻塞队列中的任务。 SHUTDOWN 已关闭 调用shutdown方法后处于该状态,不再接收新任务,处理阻塞队列中任务。 STOP 已停止 调用shutdownNow方法后处于该状态,不再新任务,并中断所有线程,丢弃阻塞队列中所有任务。 TIDYING 处理中 所有任务已完成,所有工作线程都已回收,等待调用terminated方法。 TERMINATED 已终止 调用terminated方法后处于该状态,线程池的最终状态。 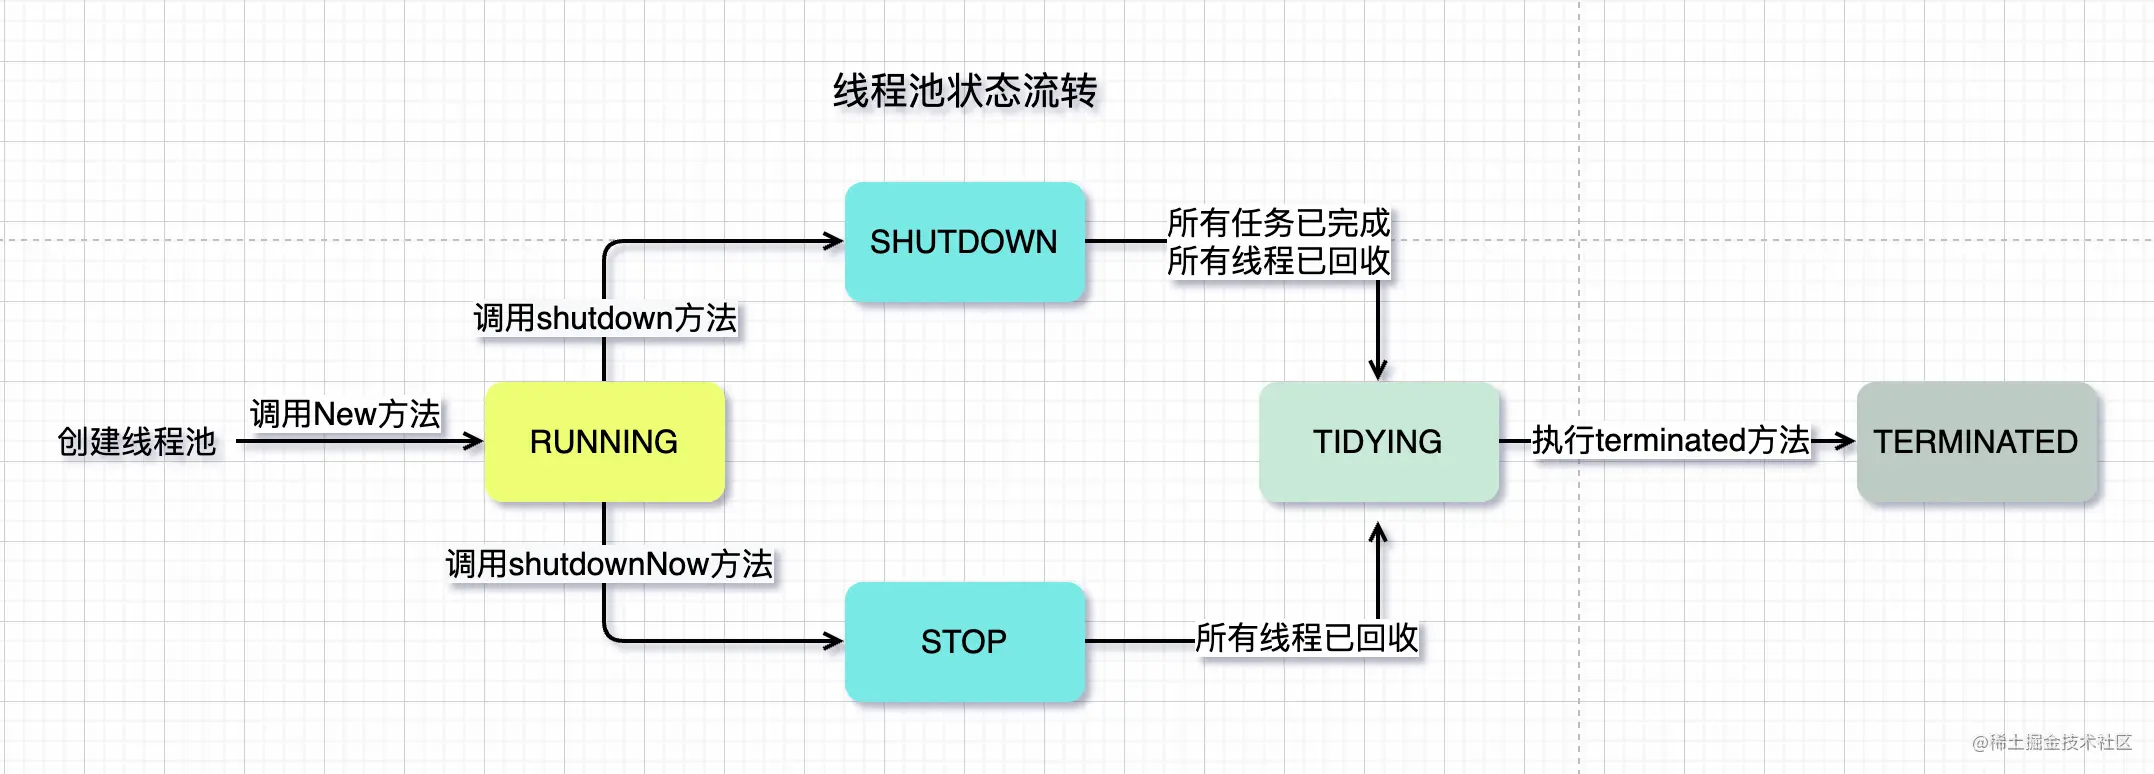
5.3 execute源码
看一下往线程池中提交任务的源码,这是线程池的核心逻辑:
- // 往线程池中提交任务
- public void execute(Runnable command) {
- // 1. 判断提交的任务是否为null
- if (command == null)
- throw new NullPointerException();
- int c = ctl.get();
- // 2. 判断线程数是否小于核心线程数
- if (workerCountOf(c) < corePoolSize) {
- // 3. 把任务包装成worker,添加到worker集合中
- if (addWorker(command, true))
- return;
- c = ctl.get();
- }
- // 4. 判断如果线程数不小于corePoolSize,并且可以添加到阻塞队列
- if (isRunning(c) && workQueue.offer(command)) {
- // 5. 重新检查线程池状态,如果线程池不是运行状态,就移除刚才添加的任务,并执行拒绝策略
- int recheck = ctl.get();
- if (!isRunning(recheck) && remove(command))
- reject(command);
- // 6. 判断如果线程数是0,就创建非核心线程(任务是null,会从阻塞队列中拉取任务)
- else if (workerCountOf(recheck) == 0)
- addWorker(null, false);
- }
- // 7. 如果添加阻塞队列失败,就创建一个Worker
- else if (!addWorker(command, false))
- // 8. 如果创建Worker失败说明已经达到最大线程数了,则执行拒绝策略
- reject(command);
- }
- 复制代码
execute方法的逻辑也很简单,最终就是调用addWorker方法,把任务添加到worker集合中,再看一下addWorker方法的源码:
- // 添加worker
- private boolean addWorker(Runnable firstTask, boolean core) {
- retry:
- for (; ; ) {
- int c = ctl.get();
- int rs = runStateOf(c);
- // 1. 检查是否允许提交任务
- if (rs >= SHUTDOWN &&
- !(rs == SHUTDOWN &&
- firstTask == null &&
- !workQueue.isEmpty()))
- return false;
- // 2. 使用死循环保证添加线程成功
- for (; ; ) {
- int wc = workerCountOf(c);
- // 3. 校验线程数是否超过容量限制
- if (wc >= CAPACITY ||
- wc >= (core ? corePoolSize : maximumPoolSize))
- return false;
- // 4. 使用CAS修改线程数
- if (compareAndIncrementWorkerCount(c))
- break retry;
- c = ctl.get();
- // 5. 如果线程池状态变了,则从头再来
- if (runStateOf(c) != rs)
- continue retry;
- }
- }
- boolean workerStarted = false;
- boolean workerAdded = false;
- Worker w = null;
- try {
- // 6. 把任务和新线程包装成一个worker
- w = new Worker(firstTask);
- final Thread t = w.thread;
- if (t != null) {
- // 7. 加锁,控制并发
- final ReentrantLock mainLock = this.mainLock;
- mainLock.lock();
- try {
- // 8. 再次校验线程池状态是否异常
- int rs = runStateOf(ctl.get());
- if (rs < SHUTDOWN ||
- (rs == SHUTDOWN && firstTask == null)) {
- // 9. 如果线程已经启动,就抛出异常
- if (t.isAlive())
- throw new IllegalThreadStateException();
- // 10. 添加到worker集合中
- workers.add(w);
- int s = workers.size();
- // 11. 记录线程数历史峰值
- if (s > largestPoolSize)
- largestPoolSize = s;
- workerAdded = true;
- }
- } finally {
- mainLock.unlock();
- }
- if (workerAdded) {
- // 12. 启动线程
- t.start();
- workerStarted = true;
- }
- }
- } finally {
- if (!workerStarted)
- addWorkerFailed(w);
- }
- return workerStarted;
- }
- 复制代码
方法虽然很长,但是逻辑很清晰。就是把任务和线程包装成worker,添加到worker集合,并启动线程。
5.4 worker源码
再看一下worker类的结构:
- private final class Worker
- extends AbstractQueuedSynchronizer
- implements Runnable {
- // 工作线程
- final Thread thread;
- // 任务
- Runnable firstTask;
- // 创建worker,并创建一个新线程(用来执行任务)
- Worker(Runnable firstTask) {
- setState(-1);
- this.firstTask = firstTask;
- this.thread = getThreadFactory().newThread(this);
- }
- }
- 复制代码
5.5 runWorker源码
再看一下run方法的源码:
- // 线程执行入口
- public void run() {
- runWorker(this);
- }
- // 线程运行核心方法
- final void runWorker(Worker w) {
- Thread wt = Thread.currentThread();
- Runnable task = w.firstTask;
- w.firstTask = null;
- w.unlock();
- boolean completedAbruptly = true;
- try {
- // 1. 如果当前worker中任务是null,就从阻塞队列中获取任务
- while (task != null || (task = getTask()) != null) {
- // 加锁,保证thread不被其他线程中断(除非线程池被中断)
- w.lock();
- // 2. 校验线程池状态,是否需要中断当前线程
- if ((runStateAtLeast(ctl.get(), STOP) ||
- (Thread.interrupted() &&
- runStateAtLeast(ctl.get(), STOP))) &&
- !wt.isInterrupted())
- wt.interrupt();
- try {
- beforeExecute(wt, task);
- Throwable thrown = null;
- try {
- // 3. 执行run方法
- task.run();
- } catch (RuntimeException x) {
- thrown = x;
- throw x;
- } catch (Error x) {
- thrown = x;
- throw x;
- } catch (Throwable x) {
- thrown = x;
- throw new Error(x);
- } finally {
- afterExecute(task, thrown);
- }
- } finally {
- task = null;
- w.completedTasks++;
- // 解锁
- w.unlock();
- }
- }
- completedAbruptly = false;
- } finally {
- // 4. 从worker集合删除当前worker
- processWorkerExit(w, completedAbruptly);
- }
- }
- 复制代码
runWorker方法逻辑也很简单,就是不断从阻塞队列中拉取任务并执行。
再看一下从阻塞队列中拉取任务的逻辑:
- // 从阻塞队列中拉取任务
- private Runnable getTask() {
- boolean timedOut = false;
- for (; ; ) {
- int c = ctl.get();
- int rs = runStateOf(c);
- // 1. 如果线程池已经停了,或者阻塞队列是空,就回收当前线程
- if (rs >= SHUTDOWN && (rs >= STOP || workQueue.isEmpty())) {
- decrementWorkerCount();
- return null;
- }
- int wc = workerCountOf(c);
- // 2. 再次判断是否需要回收线程
- boolean timed = allowCoreThreadTimeOut || wc > corePoolSize;
- if ((wc > maximumPoolSize || (timed && timedOut))
- && (wc > 1 || workQueue.isEmpty())) {
- if (compareAndDecrementWorkerCount(c))
- return null;
- continue;
- }
- try {
- // 3. 从阻塞队列中拉取任务
- Runnable r = timed ?
- workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) :
- workQueue.take();
- if (r != null)
- return r;
- timedOut = true;
- } catch (InterruptedException retry) {
- timedOut = false;
- }
- }
- }
- 复制代码
6. 总结
今天带大家一块详细剖析了Java线程池的实现原理,是不是非常简单?
几百行的方法虽然看着复杂,令人头疼,只要由浅入深的梳理清理业务逻辑,源码读起来也是小菜一碟。
-
-
相关阅读:
网络安全笔记-入侵检测系统
第七章 数学 AcWing 1586. 连续因子
仿写el-upload组件,彻底搞懂文件上传
支付宝支付
算法分析与设计考前冲刺 (算法基础、数据结构与STL、递归和分治、 动态规划、贪心算法、 回溯算法)
大模型的视觉能力
HTML DOM 对象
【软件测试】PDM、PTM、IPD介绍(捣鼓一晚上的血泪知识)
站群程序-免费站群程序排名
【C语言刷题】指针入门三题|字符串长度、字符串复制、两数交换
- 原文地址:https://blog.csdn.net/BASK2312/article/details/127686859
